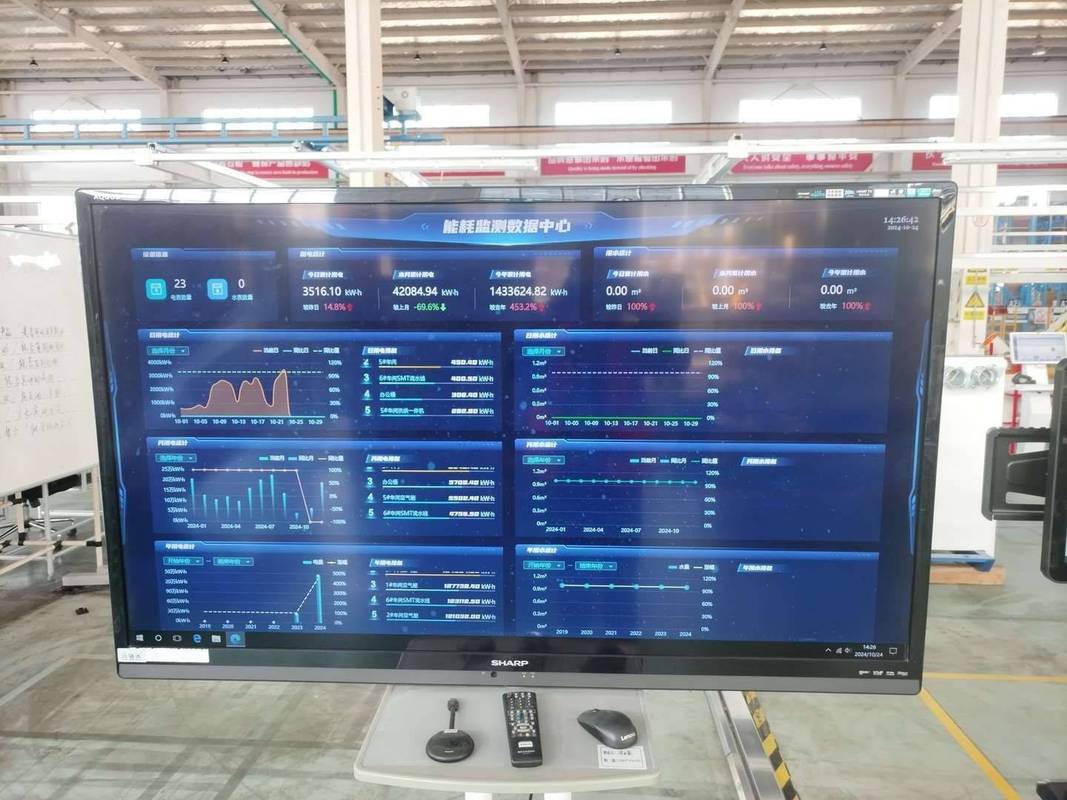
上个月跑江浙的三家汽车零部件厂,给我整得直皱眉。一线的生产主任拿着去年的用电曲线拍脑袋排产,碰到错峰电价上浮30%的时段,整条冲压线硬生生停俩小时,算下来省的电费还抵不上耽误的订单交期罚款。问题出在哪?工业负荷预测的精度没踩在真实生产节奏上,全是飘在实验室的模型。
那些吹上天的预测模型,为什么一进车间就“水土不服”?
那些动辄宣称能实现99%预测精度、全场景覆盖的供应商,大多是拿电网侧的成熟模型改了个皮,根本没考虑工业现场随时可能出现的换产、设备故障、临时插单这些突发变量,一碰到真实生产场景,精度跳水比跳水冠军还快。电网侧的负荷是跟着居民用电、商业用电走的,惯性大,波动平缓,提前一天的预测误差能控制在5%以内就算优秀。但工业侧不一样——
今天临时插个新能源客户的急单,明天下游供应商迟了俩小时料,后天车间的空压机组突然漏了个气,这些细碎的变量,全是之前的模型没考虑过的盲区。
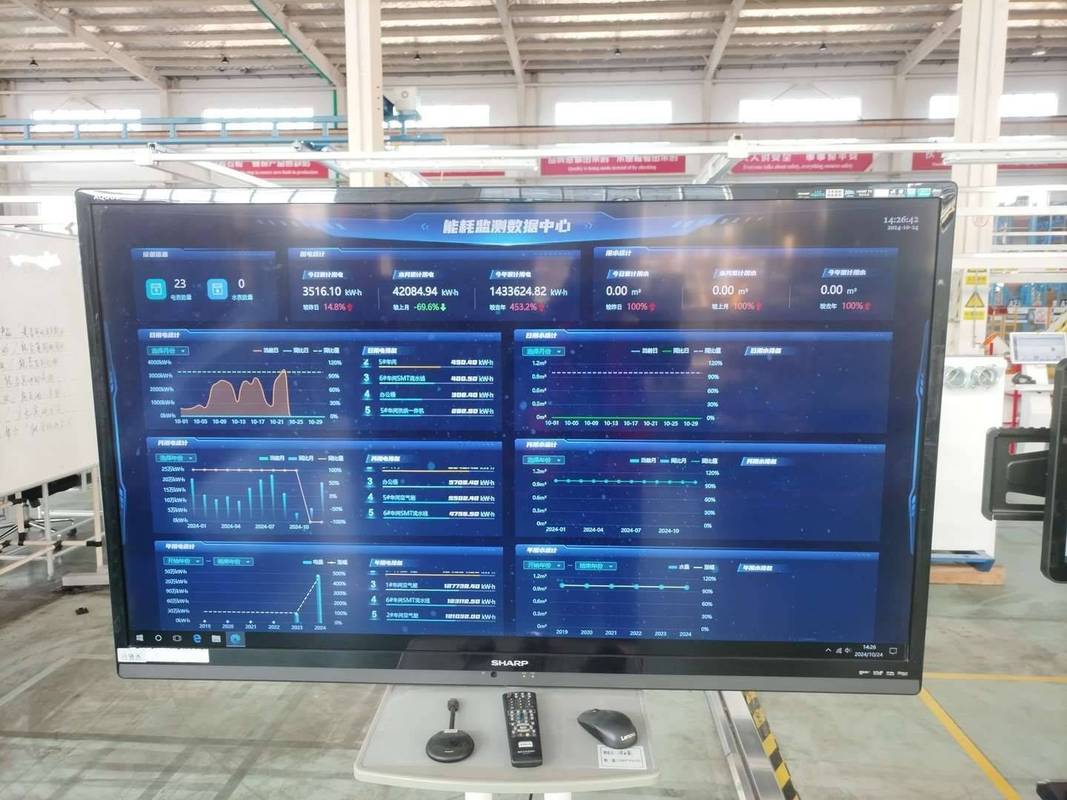
问:我们之前试过用Python搭了个LSTM模型,拿过去1年的用电数据跑训练,预测精度能到92%,为什么实际用的时候碰到换产就直接崩了?
答:你漏了最核心的三类非电数据。第一是排产工单的实时变动——哪个批次的产品在跑,对应的机床功率区间是多少;第二是生产环境的动态参数——夏天车间温度超35度的时候,通风机组的负荷会比基准值高18%左右;第三是设备的健康状态——用了10年的旧电机,空载功率比新电机高20%,你拿新设备的基准值算,肯定错。别光拿电数据喂模型,那叫“盲人摸象”。
真能落地的工业负荷预测,到底要抓哪些核心变量?
2024年跑了快20家制造工厂的落地项目,我发现一个有意思的规律:越是把模型搞得复杂的项目,落地效果越差。反而是那些把核心变量抓得准的轻量化方案,最后能真正在车间里跑起来。
✅ 第一类是刚性可量化的基础负荷:比如车间的照明、中控室的空调、常年运行的水泵,这部分负荷是稳的,波动不超过5%,可以直接用历史均值算,没必要搞复杂模型。
✅ 第二类是随生产节奏变动的柔性负荷:比如冲压线、焊接机器人、热处理炉,这部分的负荷波动完全跟着工单走,必须和生产端的实时数据打通,不能脱离生产谈预测。
❗ 这里必须吐槽一句,之前见过一个供应商,给工厂做的预测系统根本不接MES,就盯着电表数算,碰到车间临时插个新能源配件的急单,直接预测偏差冲到40%,最后被生产主任追着骂了三公里。
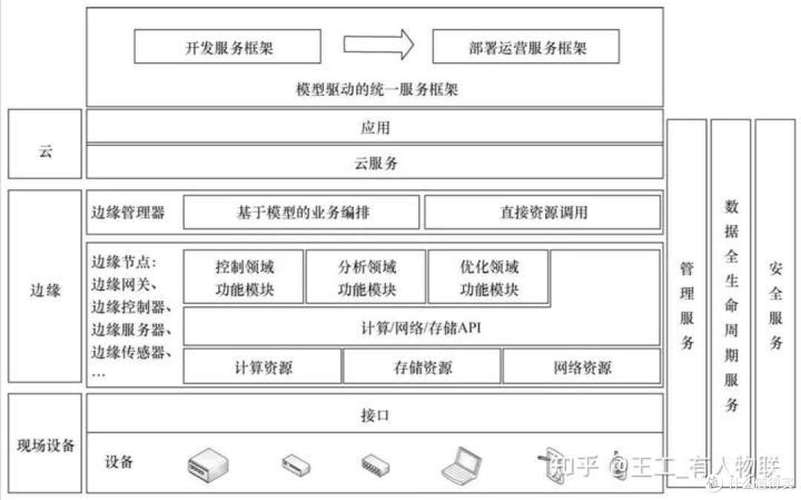
问:我们工厂的MES系统是10年前上的,接口都快掉皮了,根本没法和新的预测系统打通,难道要花几十万换整套MES才能做工业负荷预测?
答:完全没必要。现在主流的做法是给每个关键用电节点装个带边缘计算的智能电表,直接采集设备的启停信号、功率波动曲线,和MES里的排产计划做离线匹配就行——比如你今天排产是3号机床跑12个小时的铝件加工,电表采集到3号机床的空载信号、带载功率,根本不需要MES开放实时接口,靠信号匹配就能把预测精度拉到85%以上。算下来成本也就换MES的1/10,性价比高到离谱。
算完账你就知道,靠谱的工业负荷预测到底能省多少钱?
之前给一个做光伏支架的工厂算过一笔账:他们之前碰到尖峰电价时段,就是硬停生产线,每个月的停产损失大概是12万。上了落地的工业负荷预测之后,能提前4个小时预判未来的负荷曲线,把高能耗的镀锌工序调整到谷电时段,把低能耗的组装工序放到尖峰时段,每个月的电费省了8万,还不用停线,算下来投入的系统成本,6个月就收回来了。
说真的,很多人觉得工业负荷预测是个高大上的数字化项目,要花几百万,要找顶级的算法团队。其实根本不是。我见过最朴素的一个工厂,就是找了个刚毕业的电气工程师,花了3个月时间,把每个设备的用电特性摸得门清,结合每天的排产表算负荷,比那些花了大几十万上的云端模型准多了。为啥?因为他天天在车间转,知道哪天设备会出问题,知道哪个主任会为了赶进度偷偷开备用设备,这些东西,再牛的算法也算不出来。
别追求完美。
你要是拿着实验室里99%精度的模型要求车间里的实际运行效果,最后大概率会因为一点点的偏差就把整个系统弃用,白扔了前面花的时间和钱。靠谱的预测,不是追求绝对的零误差,是能把偏差控制在10%以内,给生产调度留出足够的调整空间,就够了。
💡 最后提个醒:上工业负荷预测系统的时候,别把权限全给IT部门。生产一线的主任、电气班的班长才是最懂现场负荷的人,让他们参与到模型的校准过程里,比找10个算法工程师在办公室里调参数有用10倍。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:别再瞎调峰了:2024年工业负荷预测在离散制造场景的落地真相 https://www.dachanpin.com/a/tg/71111.html