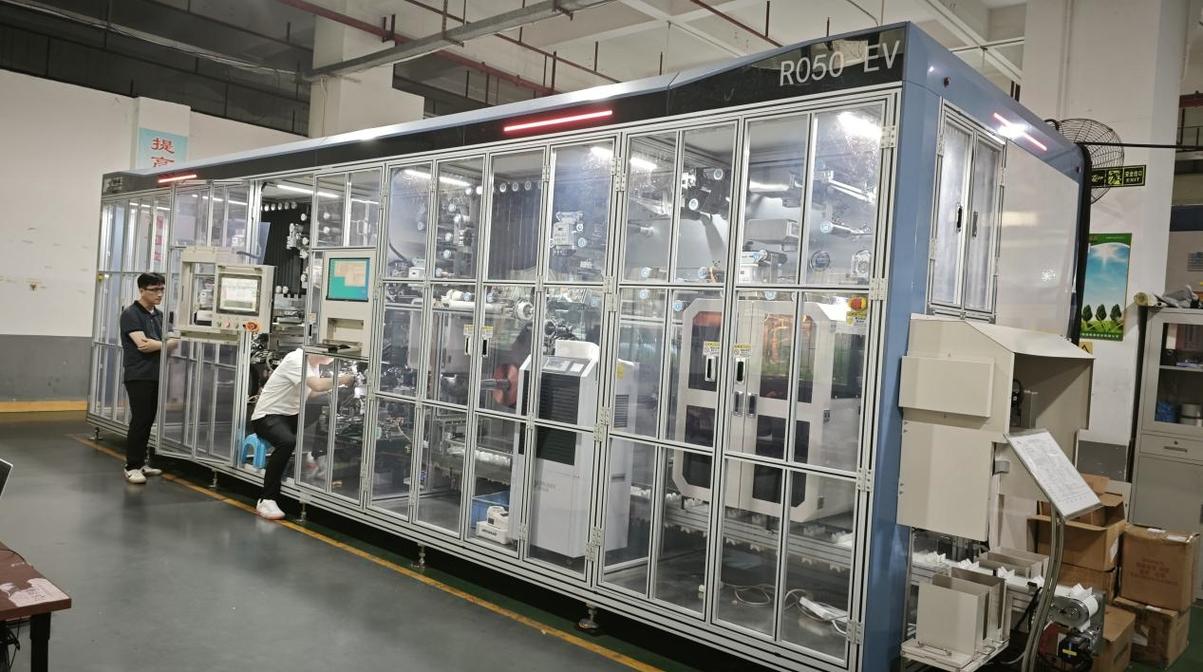
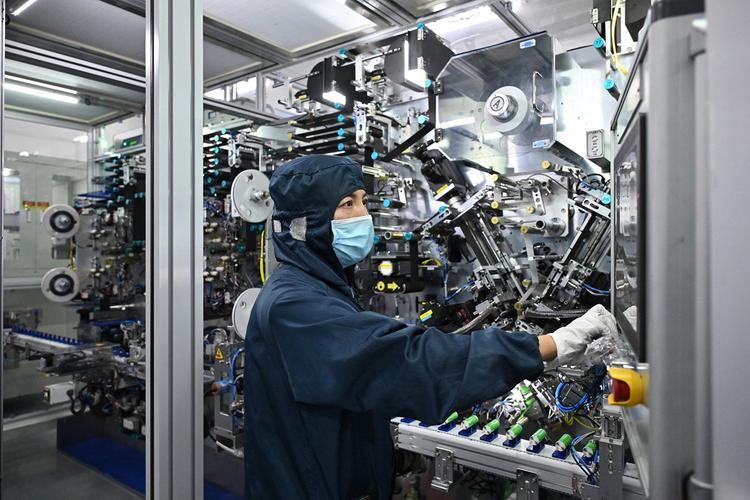
不是玄学,是产线”吃了亏”才攒出来的刚需
很多人对工业自适应控制的第一印象,是实验室里飘着的高级概念,离普通车间远得很。 之前跟一个做系统集成的朋友聊,他说前两年给江浙一带的制造企业推自适应控制方案,人家设备主管直接摆手——我们有干了二十年的老师傅,手往模腔上一摸就知道温度够不够,参数拧两下就调好,要那破系统干啥? 结果去年那家厂接了个多品种小批量的订单,单批次最多也就几百件,换型一次要重新调压力、温度、速度四个核心参数,全流程要4个多小时。两个老师傅连熬三个通宵,最后高血压犯了直接住院,说起来都让人心疼。现在反过来追着问,能不能把之前老师傅的经验变成系统的自动调整功能。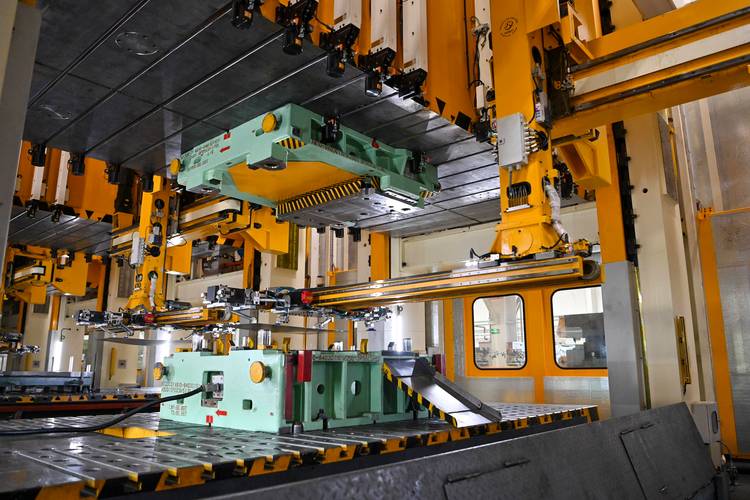
落地最容易踩的3个坑,太多企业交了冤枉学费
我跑了快一百家制造车间,见过太多企业上自适应控制的时候,钱花了大几百万,最后用不起来的。踩的坑翻来覆去就那几个。 ✅ 第一个坑:上来就堆最贵的传感器。 真的没必要。我见过一个做食品包装机械的厂,为了做封切环节的自适应控制,给每个封切工位装了三个千分之一精度的温度传感器,单工位成本涨了两千多。结果跑了三个月才发现,真正影响封切质量的根本不是传感器测的那零点几度的温差,是放卷环节的张力波动。钱花了,核心问题没解决。 ❗ 第二个坑:把模型搞得越复杂越好。 很多方案商上来就给你套个深度学习大模型,说要攒半年的运行数据才能训练出精准的模型,算一次参数调整量要好几秒。根本赶不上产线的实时变化。工业现场要的是稳,不是炫技。之前一个做高端纺织面料的客户,一开始上了个复杂度拉满的自适应模型,一碰到纱线批次变了,模型算出来的参数偏差比干了三十年的老师傅调的还大,最后退回到”参数梯度寻优+实时反馈”的简单逻辑,反而把断纱率降了40%。 💡 第三个坑:不管现场的”脏数据”。 车间里的环境是什么样的?油雾飘在传感器上,铁屑挡住信号,偶尔还有电磁干扰跳出来离谱的数值。你要是不做基础的数据清洗、异常值剔除,自适应系统直接跟着错误数据调参数,那不出乱子才怪。之前有个做锂电极片涂布的厂,就是因为传感器被溶剂雾气糊了,连续跳了三个小时的异常数据,系统自动调整的涂布速度偏了15%,整批极片厚度不合格,损失了近百万。
现在的工业自适应控制,早就不是大厂的专属玩具了
很多人对自适应控制的印象还停留在十年前,觉得只有冶金、化工这些大型流程工业,砸个大几百万才能玩得转。 真不是。 这两年边缘计算盒子的成本打下来了,很多中小离散制造的厂,几万块钱就能把核心工位的自适应改造做完。我今年春天接触的一个做酱料灌装的小厂,总共三条灌装机产线,之前每到夏天环境温度升上来,酱料的粘度变了,灌装机的灌装量误差就超标,每小时要出三四十瓶净含量不达标的产品。后来他们就在每个灌装头边上加了个低成本的粘度传感器,连了个几百块的边缘计算盒子,把之前老师傅总结的”温度每升1度,灌装压力降2%”的经验逻辑写进去,整个改造花了不到两万块,灌装精度直接稳定达标,一个月省的不合格品成本就把改造钱赚回来了。就这点小改造,比他们之前花十几万做的数字孪生大屏实用多了。 说实话,很多企业在做产线数字化的时候,总想着一步到位把所有设备、所有工位都接上系统,钱花了几千万,最后真正能帮一线解决实际问题的功能没几个,大部分屏幕上跳出来的数据,除了给领导参观的时候用,一线操作工根本不会多看一眼。 工业自适应控制从来不是什么用来撑门面的概念。 它最实在的价值,是让你不用再蹲在产线边上为了一点参数波动熬大夜,是让你换供应商、换物料批次的时候不用全产线重新调参数,是让你跑出来的每一个零件、每一瓶产品,精度都稳得像干了几十年的老师傅亲手做的。 别被那些绕来绕去的概念忽悠了。 能解决车间真问题的技术,才是好技术。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业自适应控制:从车间真实痛点出发的落地路径 https://www.dachanpin.com/a/tg/71137.html