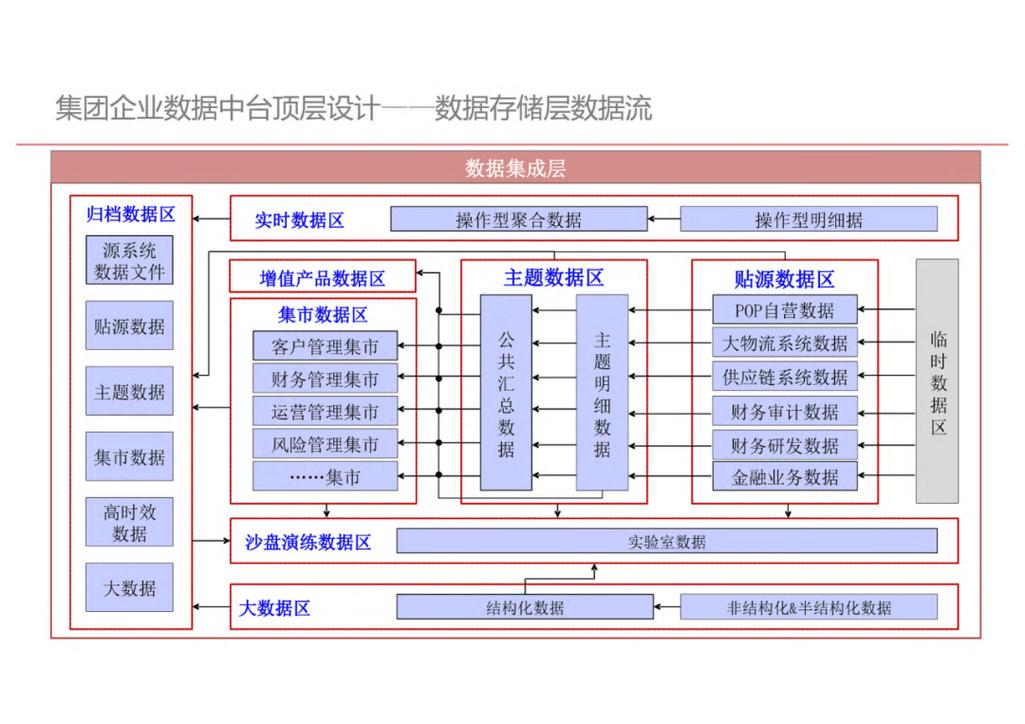
你去工厂转一圈就知道,现在哪个规模化车间没装几十个上百个传感器?一秒钟采集好几次数据,一年下来能堆几个TB,存都存不住。
之前大多工厂用传统关系型数据库存这些数据,那叫一个坑。
别拿普通关系型数据库遭工业数据的罪
传统关系型数据库设计之初,就是用来存交易数据、业务数据的,哪里扛得住工业时序数据这种“高并发写入、低价值密度、查询按时间范围”的特点?
写入吞吐量不够,一百个测点同时写还好,上万个测点同时写直接卡死。数据压缩率差,同样一百亿条数据,普通库要占五倍以上的存储空间。最要命的是查询,你要找三个月前某一小时某台设备的温度变化,能给你查好几分钟,别说实时分析了,能打开就不错了。
 传统关系型数据库存储工业时序数据性能对比图
很多工厂一开始不信邪,非要自己改MySQL凑合用,结果不到三个月,运维天天加班调性能,跑断腿都搞不定,老板才肯掏钱换专门的产品。
问:工业现场不就是存点温度压力转速数据?用普通云盘存csv不行吗?
答:真不行。你算笔账,一条中等规模产线1000个测点,1秒1次采样,一天就是8640万条数据,csv打开都要十分钟,更别说你要实时聚合算良率、找设备异常了,而且数据存多了备份、迁移都难,也就小作坊能凑活用,上规模的制造企业根本玩不起。
问:那我用开源的通用时序数据库行不行,非得用专门针对工业场景优化的
工业时序数据库?
答:这个得看你的规模。开源的适合几十上百个测点的轻量场景,真到工厂级别的上万甚至几十万个测点,工业现场有一堆特殊需求是开源产品满足不了的——比如断网时本地缓存数据、联网后自动补传,比如对缺失数据的智能插值,比如适配各种各样的工业协议直接输出,还有7*24小时不间断运行的稳定性,出问题有人给你售后。大工厂上百十万测点,开源库跑半年很容易崩,到时候丢了数据哭都没地方哭。
工业时序数据库真正的价值不止存数据
说实话,我见过太多企业,花大价钱买了工业时序数据库,就只拿来当数据存储柜用,太浪费了。
现在数字化转型喊得凶,很多企业费劲吧啦把数据采上来了,堆在库里落灰,根本没挖出来实际价值。其实合格的工业时序数据库,本身就内置了很多针对工业场景的计算能力,不用你自己拉数据写代码算,直接调用就行。
去年我去长三角一家做汽车底盘零部件的工厂,他们把三条冲压线所有传感器的振动、温度、压力数据,全存在自主研发的工业时序数据库里,系统不用额外对接BI工具,直接就能实时计算每台设备的OEE,还能通过数据波动提前预测部件磨损。后来他们提前三个月预测到一台主压机的滑块异常,安排在订单空档期大修,直接省了上百万的停机损失,这还不到半年就把买数据库的钱赚回来了。
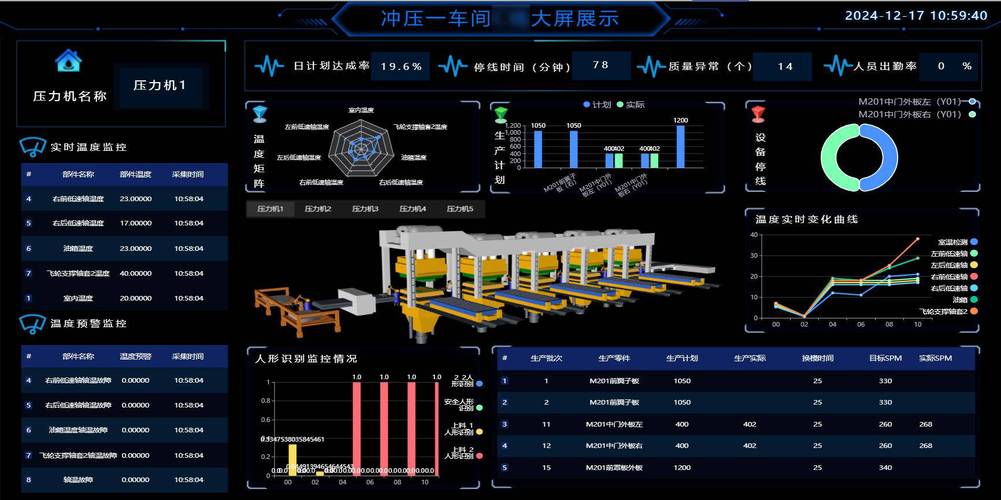 汽车冲压车间工业时序数据库数据监控大屏
不止制造工厂,现在陆上风场、分布式光伏,每台风机的振动数据、每块光伏板的发电数据,全靠工业时序数据库存,配合故障预警模型,能把风机的非计划停机率降三分之一以上,这已经是2024年新建新能源场站的标配了。
选工业时序数据库,得绕开这几个坑
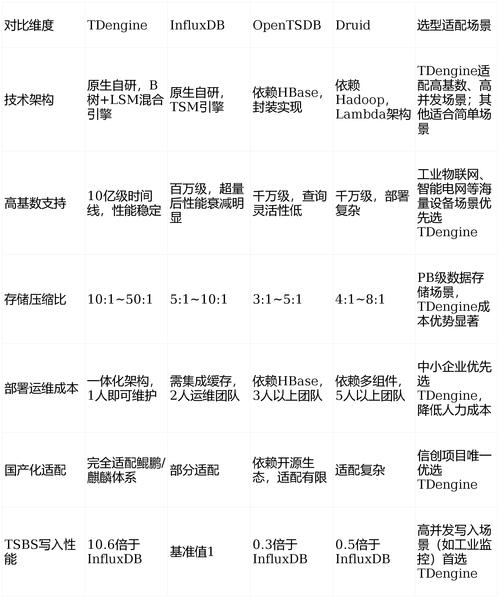 选工业时序数据库,得绕开这几个坑
我接触过几十家不同规模的制造企业,总结出来几个选品的坑,给大家提个醒:
💡 第一,别光看厂商给的峰值性能,要看长时间满负荷运行的稳定性。很多厂商测试的时候给你看百万点写入没问题,真跑半年,数据量上来了就开始卡顿丢数据,折腾死人。
❗ 第二,一定要提前确认适配你现有的工业协议。Modbus、OPC UA、PROFINET这些常用协议,如果对接还要自己写一半代码,那隐形成本直接翻番。
✅ 第三,要算清总拥有成本,别光看初始license便宜。很多厂商把存储扩容、计算节点都拆开收费,最后算下来,比一体式的工业时序数据库还贵,本来想省钱结果多花钱。
不过话说回来,这两年国内做工业时序数据库的厂商进步真的快,很多产品针对国内工厂的场景做了大量适配,价格比国外品牌便宜一半还多,稳定性也不差,我最近接触的五六个新建智能工厂,都换成国产的了,用着没毛病。
数字化转型的根子是数据,数据存不好,后面什么AI预测、智能分析都是空中楼阁。别舍不得这点投入,等你真的靠数据省下几十万上百万的损失,就知道这钱花得有多值。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业时序数据库:制造企业数字化转型的隐形核心 https://www.dachanpin.com/a/tg/69453.html