为什么制造企业现在才扎堆上计算机视觉(CV)质检?
早十年前工业CV就吹得很火了,那时候为什么大部分工厂都用不起来? 说实话,那时候技术真不到位。算法准确率不够,换个批次工件就要重新训模型,还要专门配几十万的服务器,出一次错停线半小时,损失比人工质检还大。我前五年接触的相关项目,十个有六个死在上线前调试,剩下三个用了半年就被工人拔了电源,扔车间角落吃灰。 现在完全不一样了。Transformer架构普及后,小样本学习就能训出可用的模型,边缘端推理卡一千多块就能稳定跑,普通零部件缺陷检测准确率能做到99.95%以上,完全满足工业要求。成本降了一大半,准确率提了好几个档次,自然就扎堆上了。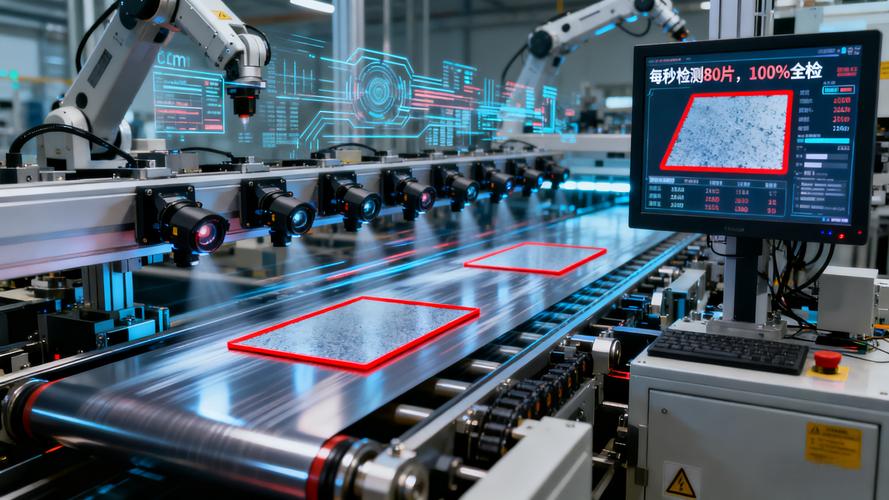
工业级计算机视觉(CV)落地,最容易踩的三个坑
我见过太多钱花了效果出不来的项目,大部分都是踩了这几个坑: ❗ 坑一:为了省钱凑活用旧电脑跑推理 很多老板觉得,不就是跑个检测算法吗?厂里淘汰的办公电脑剩下来装上就能用,能省则省。结果呢?推理延迟高,帧率上不去,漏检率蹭蹭往上涨,出了问题还甩锅给CV不准。其实一千多块的边缘推理卡就能稳定跑三四个相机的检测任务,千万别省这个钱。 💡 坑二:要求算法100%不出错 说实话,做不到啊。哪怕是干了十几年的熟练质检工,漏检率也有0.2%左右啊。正确的玩法是,计算机视觉(CV)把明显不合格的工件直接挑出来,把模棱两可的疑似异常件分拣出来给人工复检,这样已经能省掉80%以上的人工,投入产出比已经非常好看了,非要追求零失误,纯粹是给自己找麻烦。 ✅ 坑三:不存标注数据,工艺变了模型废了 工厂生产线换个打磨工艺,或者换了一批原材料,工件表面纹理变了,原来训练好的CV模型准确率能掉一半。很多工厂之前没存标注数据,只能重新拍重新标,耽误大半个月生产。你只要把每个批次的标注数据分类存好,改模型的时候随时调出来增量训练,半天就能恢复正常,不至于手忙脚乱。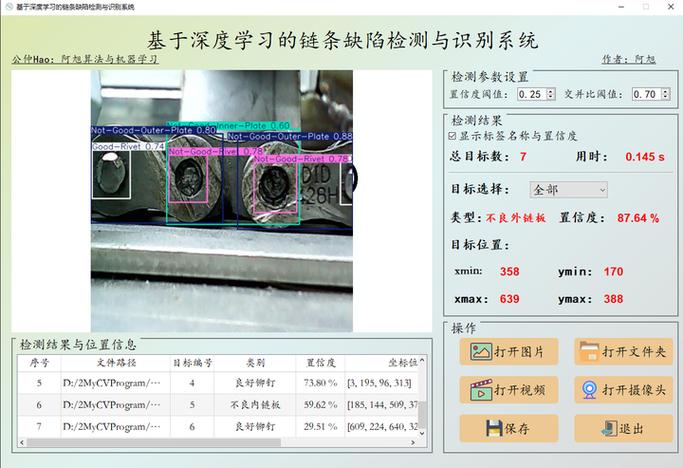
接下来,工业CV还有哪些新玩法可以试
相关推荐
-
精细化服务与技术赋能:新时代物业管理的破局之路
物业管理作为城市治理体系的重要组成部分,直接关系到千万业主的居住体验与资产价值,更承载着社区和谐稳定的基础功能。随着城市化进程加速与居民需求升级,传统管理模式中的粗放运营、响应滞后等问题日益凸显,行业正迎来从 “基础服务” 向 “价值创造” 的关键转型期。如何通过服务优化与技术创新破解发展瓶颈,成为所有物业服务企业必须面对的核心课题。 优质的物业管理不仅是房…
-
解锁电脑的核心奥秘:从部件到实用指南
电脑已深度融入现代生活的方方面面,无论是日常办公处理文档、线上学习观看课程,还是休闲娱乐玩游戏、编辑照片,都离不开它的支持。很多人每天与电脑朝夕相处,却对这个精密设备的内部构造和工作原理了解甚少。其实,电脑就像一个协同工作的 “小团队”,每个部件都有其独特的职责,只有各部件默契配合,才能保证设备稳定高效运行。了解电脑的核心部件功能、选购技巧以及日常维护方法,…
-
工业物联网(IIoT)的暗面:为什么90%的试点项目最终沦为“僵尸系统”?
前阵子去一家汽配厂,他们三年前轰轰烈烈上线的IIoT系统,现在屏幕还亮着,但没人看了。数据在跑,可车间主任依然靠吼、靠纸单——那100多万的投资,就换来几块电子看板。说实话,这场景你绝对不陌生。很多工厂搞工业物联网(IIoT),像极了菜鸟换新手机:功能用不上20%,却为剩余80%的“可能性”买了单。❗ 更荒诞的是,你随便参加个行业论坛,PPT里全是“预测性维…
-
过程控制系统(PCS)真的过时了吗?——现代工厂的隐形大脑
去年在华南一家化工厂,我看到主控室的屏幕墙还是十年前的WinCC界面,操作员却淡定得像在玩模拟城市。然后他告诉我,上个月系统刚扩容了IO点,控制器也升级了。说实话,PCS这玩意儿,大多数人以为它是一成不变的铁疙瘩,其实进化速度根本不讲理。 💡PCS不是PLC,也不是SCADA——但它都要 很多人把PCS和PLC混为一谈。错得离谱。PLC是控制器的核心,但PC…
-
阳光下的能量馈赠:探寻太阳能的奥秘与应用
太阳作为太阳系的中心天体,持续不断地向宇宙空间释放着巨大的能量,而其中极小一部分到达地球表面,便成为了人类可利用的宝贵资源 —— 太阳能。这种能量以光和热的形式存在,无需开采、运输,且在使用过程中几乎不产生污染物,与传统化石能源相比,展现出独特的环保优势。从远古时期人类利用阳光取暖、晒干食物,到现代社会将其转化为电能驱动机器运转,太阳能的开发与利用始终伴随着…