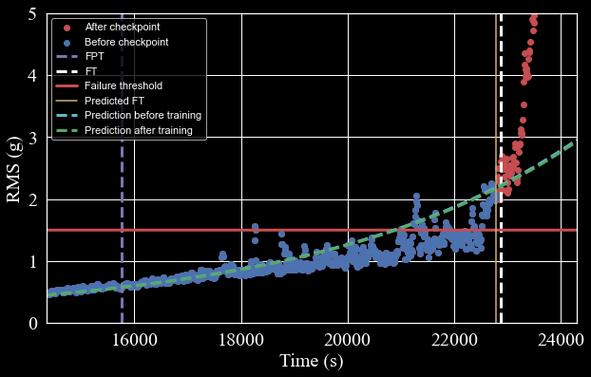
上个月去长三角跑了三家大型零部件加工厂,碰见一个老厂长拍着大腿骂。之前花了大几百万上了预测性维护系统,结果跑了半年,该坏的轴承还是突然坏了,停线一次损失二十多万,钱全打了水漂。为啥?核心问题出在,剩余使用寿命(RUL)算不准。
很多人上来就说RUL是从当前时刻到设备功能完全失效的剩余时间,定义没错,但那是教科书里的死东西。放到真实工业场景里,哪有这么简单。轴承的磨损失效,风机叶片的裂纹扩展,电机绝缘老化,每个场景的失效判定标准都天差地别,拿一套公式套所有设备,能准才怪。
问:普通的设备状态监测和RUL预测到底差在哪?
答:状态监测是告诉你“现在设备有问题,可能快要坏了”,剩余使用寿命(RUL)是明确告诉你“这台轴承还有176小时会达到失效阈值,你可以安排在本周六夜班停线更换,不用提前拆下来浪费寿命,也不用拖到白天生产时出事故”。差的可不是一点数据,是一整个精准决策的层啊。就这,很多做解决方案的公司都搞混,拿着普通状态监测当RUL产品卖,客户能不踩坑吗?
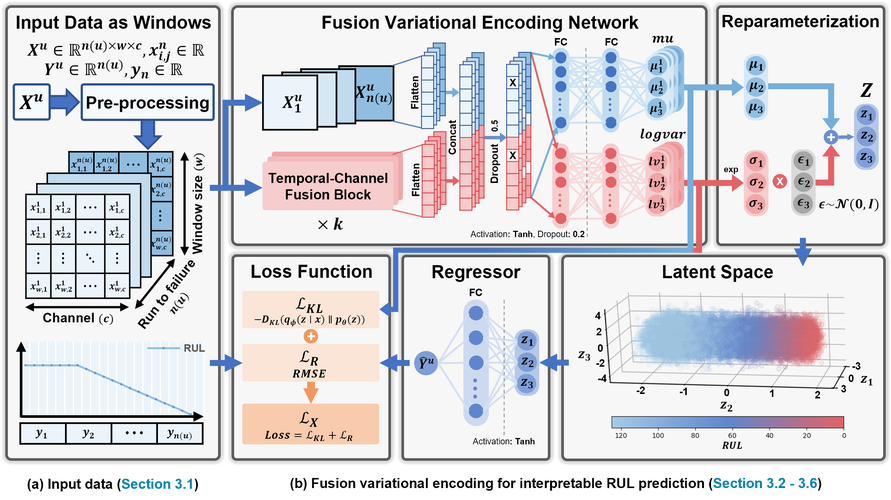
现在最新的行业实践,早就抛弃了早年纯数据驱动的黑箱模型思路,越来越多工厂开始用「机理+数据」融合的方案做RUL计算,准确率比纯AI模型提升不是一点半点。我之前接触过宝钢冷轧厂的冷轧辊RUL预测项目,团队把轧制力、轧制速度、磨损量的成熟机理模型,揉进轻量深度学习网络里,最终预测误差比纯数据模型缩小了42%,每年帮工厂少换几十根不必要提前更换的冷轧辊,省下几百万成本。
我跑过上百个工业项目,十个RUL项目八个死在同一个问题上:数据不合格。说出来你可能不信,很多工厂要做RUL,连完整标注的失效样本都拿不出来。设备刚出点异常振动,维修班就赶紧申请换了新件,根本等不到设备完全失效,哪来的全生命周期磨损数据给模型训练?
问:没有足够的全周期失效数据,就一定做不了RUL预测吗?
答:当然不是。这两年小样本学习、迁移学习在工业RUL领域的落地已经非常成熟了。同型号、同工况的设备,A工厂的全周期失效数据,可以通过迁移学习适配到B工厂的同型号设备上,再用B工厂几十小时的正常运行数据微调,准确率就能达到可用的程度。而且别死盯着传感器数据不放,设备的维保记录、换件时间、甚至操作工的手写异常记录,都是能用来标注RUL的有效信息,挖一挖总能用上。
还有一个常见的坑,就是盲目堆高精度传感器。很多方案商上来就忽悠客户,给每个螺丝都装进口振动传感器、温度传感器,一套下来几十万,其实根本没必要。我上个月看了江苏一家水泥厂的辊压机RUL项目,工程师只用了设备原有SCADA系统里的电流、压力数据,额外加了两个国产振动传感器,总投入不到十万,RUL预测准确率就做到了91%,不到半年就收回了成本,比原来那个报价一百万的全换传感器方案实用太多。
说实话,现在这个行业里,不少商家就是靠卖高价传感器赚钱,根本不帮客户算投入产出账,就是割韭菜,真要做RUL,得先算清楚:你这台核心设备停线一小时损失多少,提前换件浪费多少,再倒推需要什么精度的预测,配什么等级的传感器,不能人家说什么你都信。
最早RUL就是用来单台核心设备的故障预警,这两年不一样了,随着工业互联网平台的普及,RUL已经开始往整线、全厂层面走了。比如汽车厂的焊装线,几十台焊接机器人,每个关节减速机的RUL都算出来,运维团队可以一次性把所有寿命即将到期的减速机都换完,只停线一次,不用隔三差五停线换件,光是停线损失就能省一大笔。
还有现在火得不行的数字孪生,RUL是数字孪生里最实用的功能之一。把实时更新的RUL数据嵌到数字孪生模型里,你在大屏上点一下任意设备,直接就能看到它还剩多少寿命,还能模拟:如果接下来一周降10%负载赶订单,寿命会变成多少,能不能撑到订单完成再换件,决策太好做了。
珠三角有一家做新能源电池结构件的龙头工厂,去年给整条冲压线上了RUL预测系统,今年上半年统计下来,非计划停机时间降了37%,整体维保成本降了22%,不到10个月就收回了全部项目投入,这就是RUL真落地的效果。
💡 给想要做RUL的工厂提几个实用建议:
✅ 先从单台故障多、停线损失大的核心设备做试点,不要一上来就全工厂铺开,试成了再扩
✅ 一定要拉上有经验的运维老师傅一起参与,他们对设备故障的敏感度,比模型里的死数据值钱一百倍
✅ 不要追求100%的预测准确率,只要准确率比原来的经验判断高30%,就能帮你赚回项目成本,够用了
❗ 记住,工业技术从来都是能帮你赚钱的才是好技术,剩余使用寿命(RUL)这些年被吹得神乎其神,剥开外衣,其实就是帮你少停线、少浪费、多赚钱,就这么简单。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:剩余使用寿命(RUL):帮制造业省下亿级维保成本的核心技术 https://www.dachanpin.com/a/tg/70576.html