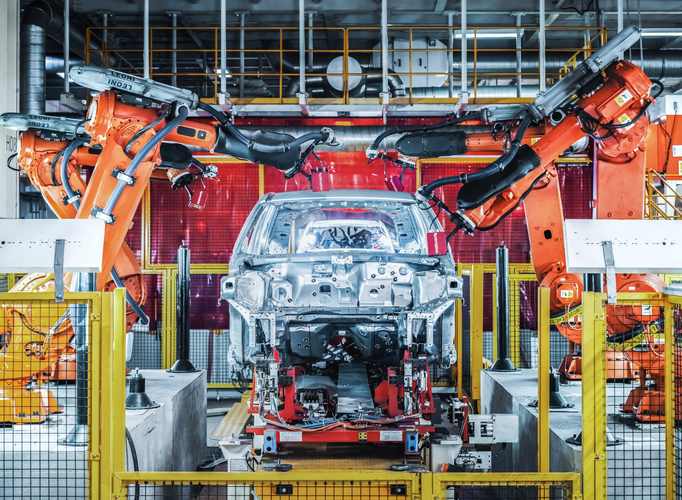
上个月在长三角的一家汽车焊装车间,我蹲了三天。亲眼看到一条生产线因为主减速机突然抱死,停了11个小时,损失快两百万。要是用对了预测性维护算法,这事本来能避免。
说实话,现在到处都在讲工业数字化,predictive maintenance吹得天花乱坠,很多工厂花了大几十万上系统,最后还是该坏坏,该停停。为什么?大部分情况不是传感器精度不够,也不是网络不行,是算法走错了方向。
很多团队上来就堆概念,要搞深度学习,要上大模型,端到端输出故障概率,数据标注标了大半年,花了几十万请外部团队调参,结果工厂换一批原材料,换了个倒班的操作习惯,模型直接准确率掉了三十个点,废了。
问:预测性维护算法是不是越复杂越准?
答:完全不是。我见过很多落地效果最好的项目,用的就是优化过的ARIMA时序模型加动态阈值判断,准确率比那些百万参数的大模型还高。工业现场的变量太杂了,电网电压波动、车间昼夜温湿度差、甚至铸件毛坯的硬度差两个点,都会改变传感器数据的分布。复杂模型对数据漂移的鲁棒性极差,换个工况直接歇菜,反而简单算法抓对了核心特征,适配性强得多,维护成本也低。
。渐变类故障,比如轴承磨损、齿轮腐蚀、管道结垢,都是慢慢发展的,用基于统计的时序异常检测就够,比如优化后的孤立森林、One-Class SVM,参数调对了,出问题提前一两周就能预警。突发类故障?比如密封突然失效、螺栓断裂,大部分算法其实很难提前太久预测,不如搭配压力、温度突变的硬阈值报警,和算法互补就够。💡 别想着一包药治所有病,工业现场没这好事。
第二个,
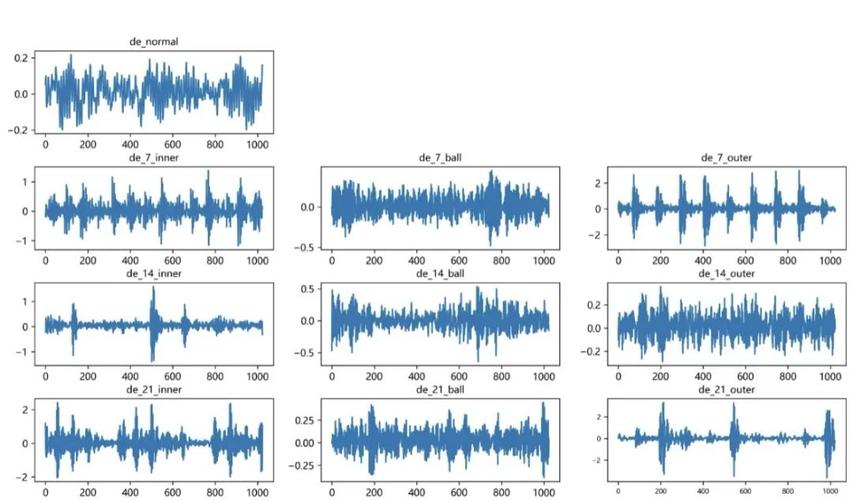
。很多新手上来就把原始振动、电流数据直接喂给模型,折腾半天出不了效果。为什么?原始数据里噪音比有效信号多十倍,模型学半天学的都是干扰。拿最常见的轴承故障来说,你得从原始振动数据里提时域特征:峰值、均方根、偏度、峭度,再转频域提频谱峰值位置、边带能量,这些特征才是对应磨损程度的核心信息,把这些喂给模型,准确率直接翻番。
。很多工厂没有那么多历史故障数据,别硬往深度学习上凑。
问:小工厂数据少,能不能跑预测性维护算法?
答:当然能。很多人觉得预测性维护算法要百万级标注数据才能训练,其实早就不是这样了。现在有很多成熟的小样本方案,比如基于迁移学习的预训练模型,用公开的工业设备故障数据集预训练完,拿你工厂几十个正常样本微调一下,就能达到可用的准确率。就算只有十几个样本,用物理模型加数据修正的混合算法,结合设备原厂给的磨损曲线,再加少量现场数据修正,准确率能到90%以上。反而那些攒了好几年数据没整理,标注错一半的,训出来模型全是错的,根本用不了。
开始普及。以前大部分算法都跑在云端,不仅延迟高,还怕工厂断网,一旦网断了预警就没了。现在几十块钱的边缘AI芯片,就能跑量化后的轻量预测算法,本地就能输出预警结果,断网也不影响工作。我在东莞一家中小型五金加工厂看到,他们给一百台冲床装的边缘监测方案,单台设备的改造成本不到一千块,运行半年就因为避免了三次停机,收回了全部成本。太香了❗
第二个是
成了新设备的标配。现在很多新的自动化生产线,出厂的时候就带原厂的数字孪生模型,预测性维护算法直接跑在孪生模型上,实时对比实际运行数据和孪生模型的模拟参数差,差值超过阈值直接预警。不用工厂自己攒两三年的历史故障数据,新设备上线就能用。这个解决了多少新工厂的痛点?以前新设备要等出好几次故障,攒够数据才能训模型,现在开箱就能用,直接省了两三年的等待期。
最后,说点掏心窝子的。很多工厂老板上来就问,你这算法准确率能不能到99%?哪有那么完美的事?预测性维护本来就是降风险,不是消灭风险。能做到85%以上的准确率,提前三到七天预警,就能帮工厂省出十倍百倍的投入,已经赚翻了。
很多项目死在追求一步到位,一开始就要全工厂所有设备都上,结果钱砸了几百万,拖两三年出不了效果,领导一换项目直接砍了。不如先挑一条故障最多、停机损失最大的生产线试,跑通了验证了效果再慢慢扩,半年就能看到回报,后面推起来顺多了。✅
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:预测性维护算法:工厂落地避坑与实战指南 https://www.dachanpin.com/a/tg/70961.html