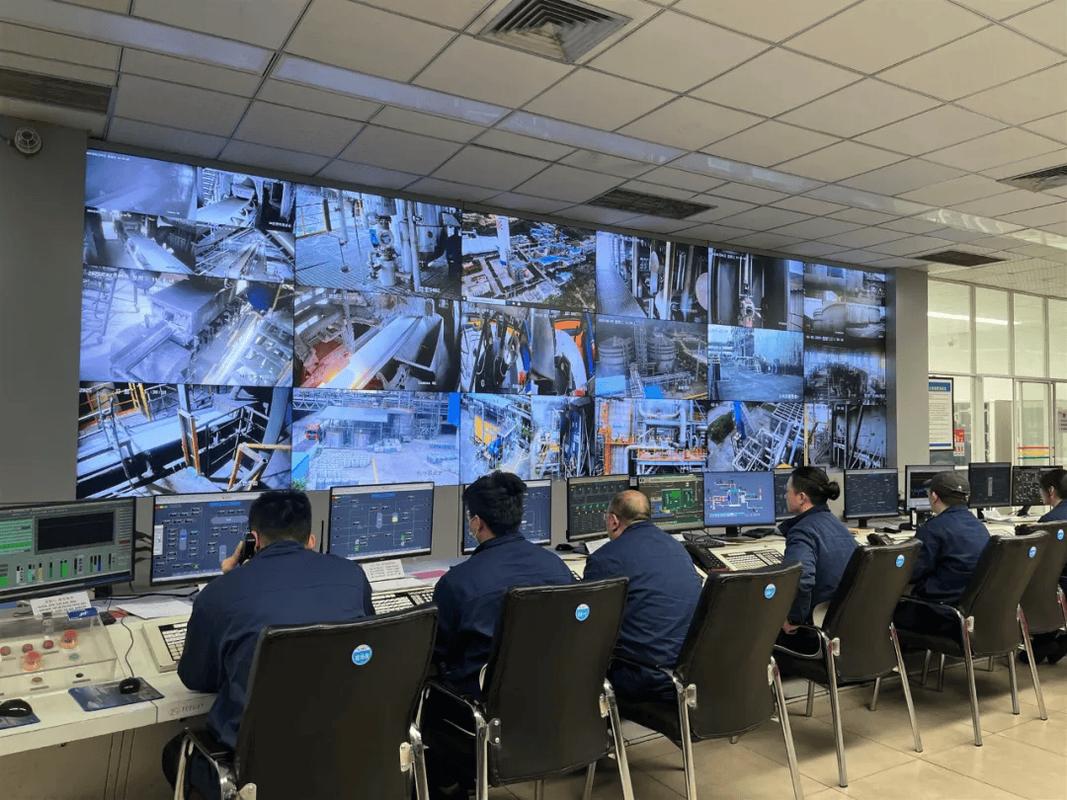
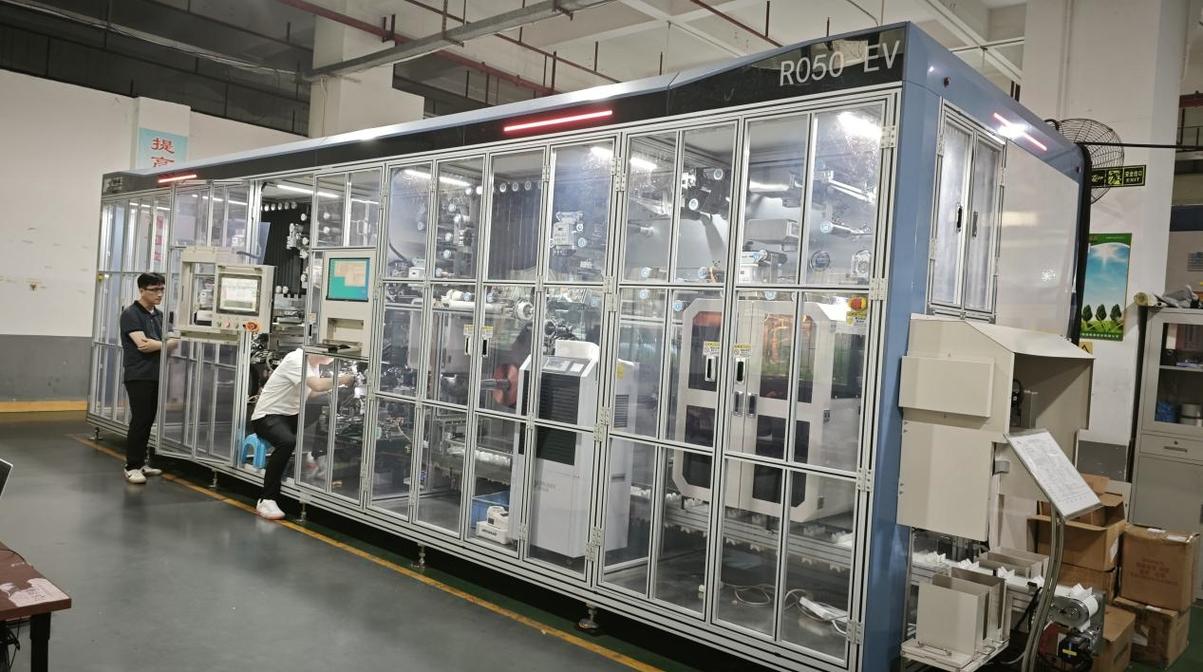
上周去苏州一家做汽车零部件的工厂调试,现场工程师蹲在控制柜旁边抽烟,说之前花了80万上的整套联动系统,现在有三分之一的功能是摆设——线体转起来就乱触发报警,换个型号要调俩小时,合着花了钱买了个祖宗?
这种情况我见得太多了。很多人对工业联动控制的认知还停留在“把设备用线连起来,设个固定时序启动就算完”,结果真到生产现场,不是误触发就是响应慢,钱花了,效果没出来。
为什么你家的工业联动控制,总比隔壁厂慢半拍?
说白了,大部分厂里的联动系统,从根上就错了。我之前在广东一家做休闲食品的包装线见过,他们的联动逻辑写得特别“规整”:传送带启动→延时3秒→封箱机启动→再延时2秒→喷码机启动,完全照着固定时序走,半点儿灵活度都没有。结果有次包装袋在传送带上卡了10秒,后面的封箱机、喷码机全在空转,一天下来废膜多了半吨,光材料损失就小两万。
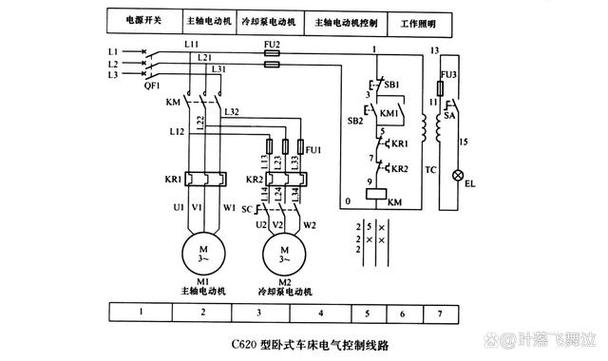
总有人觉得联动慢是因为通讯带宽不够,要换万兆以太网,要上最贵的PLC。其实根本不是——你逻辑里连“传感器有没有检测到物料”这个最基础的校验都没有,就算把通讯速度提到10G,该慢还是慢,该错还是错。
经常有做设备维护的读者私信问我最基础的问题,我干脆把这些高频问题整理出来,省得大家踩一样的坑:
问:是不是只要把所有设备的通讯协议统一成Modbus TCP,就能跑通工业联动控制了?
答:大错特错。我去年在佛山一家做陶瓷卫浴的工厂见过,全车间设备都是统一的Profinet协议,结果联动逻辑里没有加状态校验——只要某台设备的通讯模块闪断了100ms,整条线就直接触发急停,一个月下来因为通讯闪断停线的时间比设备故障停的还多。协议统一只是入场券,真正的联动核心是状态触发的时序颗粒度、异常分支的兜底逻辑、不同工况下的参数自适应,这三样缺一个,你就算用最顶尖的工业以太网,也跑不出顺畅的联动效果。
2024年真正能用的工业联动控制,根本不是靠硬写梯形图
说实话,我最烦那种上来就说要做“全车间数字孪生联动”的方案商,连现场的粉尘会堵哪个接近开关都没摸清楚,就敢报几百万的方案,最后落地的时候,数字孪生屏幕上跑的溜得很,现实里的线体一卡就全停,这不纯纯搞形式主义吗!
现在真正在一线落地的成熟方案,早就不是把所有逻辑都写在中心PLC里、靠中心节点给所有设备发指令的老路子了。大家都在把联动的决策节点拆到离设备最近的位置——也就是装在设备旁边的边缘计算网关里。比如宁德时代的锂电卷绕车间,之前的联动逻辑全靠中心PLC运算,从传感器检测到物料到位,到执行器收到启动指令,响应时间是120ms;去年他们把核心的联动逻辑下放到边缘节点,就近处理相邻设备的信号交互,响应时间直接压到18ms,整条卷绕线的良率直接涨了2.3个百分点。这不是靠堆硬件堆出来的,是把之前绕远路的通讯链路给砍了。
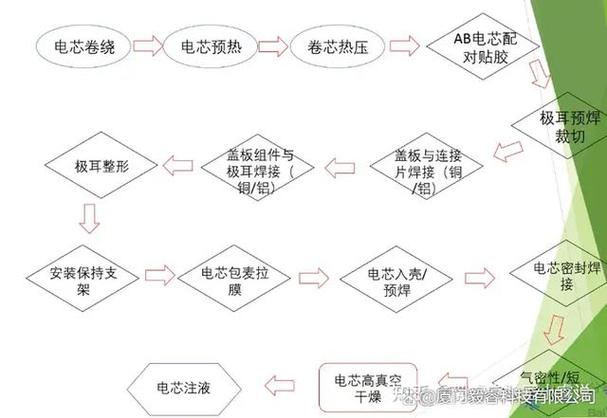
当然,拆节点也不是乱拆的。我之前碰到过一个老工程师,在厂里干了快20年,对这种新的边缘联动方式特别抵触,说以前的逻辑都在PLC里,出问题了查梯形图就行,现在拆到边缘网关上,出问题都不知道去哪找。这话也不是没道理,但只要把逻辑分层做清楚,其实比之前的中心式联动好维护多了。
问:把联动逻辑拆到边缘节点,会不会出现不同节点的逻辑打架?比如我让冲压机完成动作后给传送带发启动信号,结果传送带那边的边缘节点先收到了上游包装机的停线信号,两边指令冲突了怎么办?
答:这个问题我在去年给重庆一家摩托车零部件厂做改造的时候真踩过坑。最开始我们把所有逻辑都往边缘节点塞,结果真出现了指令冲突——冲压机的边缘节点要发启动信号,传送带的边缘节点因为检测到下游码垛机的托盘没到位,直接把信号拦了,两边来回发指令,折腾了3分钟才稳定。后来我们加了个很简单的小规则:所有联动指令只认“设备实时状态的最高优先级”,谁的状态是真的、是影响物理动作的,就听谁的,不要靠预设的固定时序走。就这么个小改动,冲突的问题直接解决了,最后整条线的联动响应速度比之前快了近40%。
做工业联动控制最容易被忽略的三个细节
我做这行快15年了,见过太多花了大价钱做的联动系统,最后因为几个没注意到的小细节,成了生产线上的摆设。总结下来,有三个坑是90%的工厂都踩过的:
- ✅ 一定要给联动逻辑留“人工干预的逃生通道”。别搞那种一启动就锁死所有操作权限的逻辑,之前有个做家电注塑的厂,联动系统把注塑机的手动操作权限全锁了,结果模具出了点小问题,工程师要切手动调模,系统死活不让,硬生生等了20分钟把料全烤化在料筒里,损失了十几万。
- ❗ 换型的联动参数别存在中心服务器里。很多厂的联动参数是存在MES系统里的,换个产品型号,要从服务器把参数导到PLC里,网络抖一下就导错了。现在我们做项目,都是把常用的换型参数存在设备本地的存储模块里,换型的时候点一下就调出来,就算整个车间的网络断了,照样能跑生产。
- 💡 别追求100%的联动自动化。我见过太多厂为了追求“黑灯工厂”的噱头,把所有能连的设备全串在一条联动链上,结果某个不起眼的辅助设备出点小问题,整条线全停。合理的做法是把联动链拆成3-4个独立的小段,每一段的异常不会影响其他段的运行,就算某一段停了,其他段照样能攒着料等修复,不会一停就是全线瘫痪。
说真的,从来没有什么放之四海而皆准的联动方案。你在教科书上看到的完美逻辑,到了现场可能连一个班都跑不下来,毕竟车间里的温度会变、工人的操作习惯会变、设备的磨损程度会变,你总不能要求现场的所有条件都按照教科书的理想状态来跑对吧?
2024年我接触的几个项目里,大家现在都不追求什么“最先进的联动技术”了,反而开始用很轻量的方式做优化——比如把过去半年的线体运行数据喂给一个本地部署的轻量AI小模型,让它自己找最适合的联动时序。之前在昆山一家做连接器的厂,之前的联动时序是靠干了十几年的老工程师一点点摸出来的,跑了半年,AI小模型算出来的最优时序,能把整条线的节拍再提8%,还能减少12%的设备空转。这东西不是什么高大上的黑科技,就是把之前靠人攒的经验,用数据算得更准一点而已。
别总想着一步到位搞个全车间的联动大系统。先把相邻的两三台设备的联动逻辑跑顺了,把响应时间压下来,把异常情况的兜底逻辑做扎实,比什么花里胡哨的概念都有用。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:别再硬堆PLC了:工业联动控制的落地坑与2024年实战经验 https://www.dachanpin.com/a/tg/71135.html