32台注塑机的模温传感器,每15分钟攒一批数据存在本地硬盘。上个月出了三批尺寸超差的汽车内饰件,质量部翻了三天历史记录,才发现是第三号机的模温传感器在生产过程中飘了8℃。
整整飘了4个小时。
这要是把数据按流式的路子理清楚,从传感器采上来的第一毫秒就盯着温度变化率算,异常刚冒头的时候就触发提醒,哪会等到攒了三批废品才反应过来?说白了,好多厂手里攥着一堆有价值的工业数据,根本没把流式数据处理的思路用对地方。
为什么工业场景的流式数据处理,和互联网的那套完全不是一回事
好多技术人员上来就把互联网圈那套流处理架构往工业场景搬,结果踩得头破血流。互联网的流式数据是什么?是用户的点击流、订单支付流,就算某条数据丢了、乱了,大不了重放就行,最多影响个报表统计,不会造成什么实际损失。
工业的流不一样。
是机床主轴每秒2000次的振动采样,是高炉壁上连续监测的温度梯度,是冲压机每一次冲程的压力峰值——这东西断一秒、错一位,可能就是几十万的设备撞刀损失,甚至是安全事故。
说真的,我见过最离谱的一个项目,直接照搬互联网的Flink默认配置,开了5秒的乱序容忍窗口。结果车间里的伺服电机一启动,电磁干扰导致传感器数据包经常延迟个3、4秒才到,直接把本来正常的温度波动算成了超限报警,硬生生把正在生产的线给停了。现场操作工对着屏幕骂了半小时街,最后直接把报警插件给卸载了。
问:我们厂已经上了传统的SCADA系统,为什么还要单独搭流式数据处理链路?
答:别拿SCADA当万能药。我见过太多厂的SCADA,本质上就是个带可视化大屏的历史数据库,所有数据攒够5分钟才做一次阈值判断,别说预测性维护了,等它报警的时候,设备已经卡了快半分钟。真正的流式数据处理,是从传感器采上来的第一毫秒就开始算:振动的FFT频谱、温度的变化率、相邻工序的节拍差,所有计算在数据流动的过程中就完成,根本不需要等攒批。
现在工业圈玩得最顺的流式数据处理落地路径,根本不是上来就搭大集群
前两年大家跟风搞“工业大数据上云”,恨不得把所有传感器的原始数据全传到云端集群里算,算到最后发现账根本算不过来。一台机床10个传感器,每个传感器每秒采100个点,一个厂200台机床,一天传上来的原始数据就是几个T,光专线带宽费一个月就大几万,纯纯的冤大头。这两年行业的思路早就转了——把流式计算的能力往边缘侧下沉。
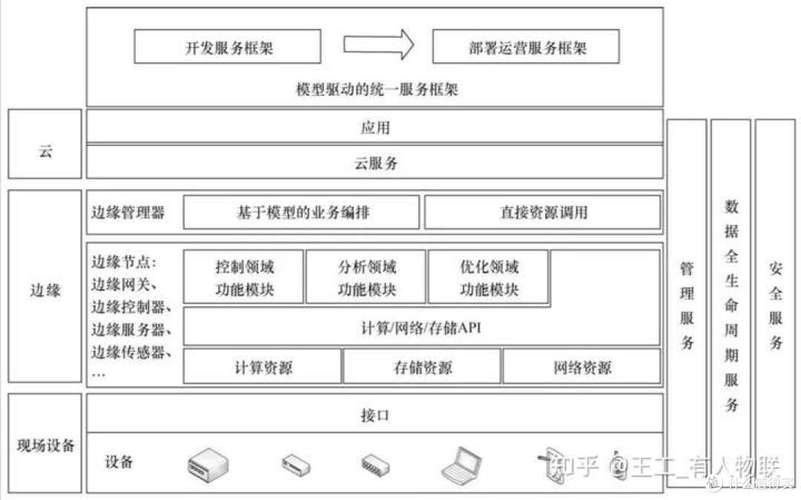
在机床旁边的边缘网关里就跑轻量的流处理引擎,把80%的高频数据在本地就做过滤、特征提取,只把有异常的片段、算出来的特征值传到云端。既省了带宽,又把延迟压到了毫秒级,根本不会受车间网络波动的影响。
问:我们厂IT团队就3个人,根本维护不了复杂的流处理平台,有没有落地门槛低的方案?
答:真没必要硬上原生的Flink集群。现在好多工业级的边缘计算盒子,出厂就内置了适配Modbus、OPC UA协议的流处理算子,你要做温度超限报警、振动特征提取、节拍统计,直接在可视化界面上把算子拖出来连上线就行,根本不用写代码。我上个月帮宁波一家做五金冲压的小厂搭的链路,从接传感器到出第一个报警,总共花了不到4个小时,比他们之前请人做SCADA定制开发快了10倍都不止。
别踩这些我见过几十次的坑
做工业场景的流式数据处理,从来不是把数据通起来就算完事,好多看起来顺的链路,用不了三个月就成了摆设。我把这几年踩过的坑列出来,大家照着避就行:✅ 第一个坑:把所有数据都当“流”来算。比如一年才变一次的设备铭牌参数、换模的固定参数,根本不需要走流式链路,存在配置数据库里就行,硬塞进去只会白白占计算资源。
❗ 第二个坑:不做数据质量前置校验就直接算。车间里的传感器今天被叉车碰歪了,明天接线松了,采上来的数据飘到天上去,你直接拿这个算的话,报警比真的故障还多,用不了半个月现场操作工就会把所有报警提示全关了——到时候系统等于白搭。
💡 第三个坑:算完的结果不落地到生产系统。好多厂做流式处理,算出来异常了只在自己的平台上弹个窗,根本不连到MES系统的工单模块,等操作工看到弹窗,对应的工件已经流到下一道工序了,溯源的时候还要翻半天记录,纯纯的自嗨。
我上次去常州的新能源电池厂,看他们的流式数据处理链路做的是真的顺。涂布机的厚度传感器数据,从采上来、算偏差、触发辊缝调整,整个过程120毫秒。之前他们靠人工看偏差调辊缝,一次调整要30秒,废品率能到1.2%,现在调完之后废品率压到了0.15%——算下来一年省的材料钱就有两百多万。
技术从来不是什么高大上的概念。
能帮厂里真金白银省钱,能让现场的师傅少加两个班,这流式数据处理的事,就算做对了。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业现场的流式数据处理:别再让传感器数据躺在硬盘里睡大觉 https://www.dachanpin.com/a/tg/71387.html