为什么普通数据库扛不住工业现场的量?
工业现场一个标准机台,光振动、温度、电流、转速、压力这些采集点就有几十个,稍微高端点的数控设备,采集点能破百。按1秒采集1次的频率算,100台机一天产生的时间序列数据,就有8.64亿条。 普通关系库的B+树索引,是为了灵活的业务查询设计的,面对这种持续递增、带时间戳的海量写入,索引的维护成本会随着数据量增长指数级上升。更别说工业场景的核心查询需求,大多是按时间范围拉取数据、做聚合统计,根本不需要那种复杂的多表关联。这种速度,等结果出来,设备都修完了,对吧?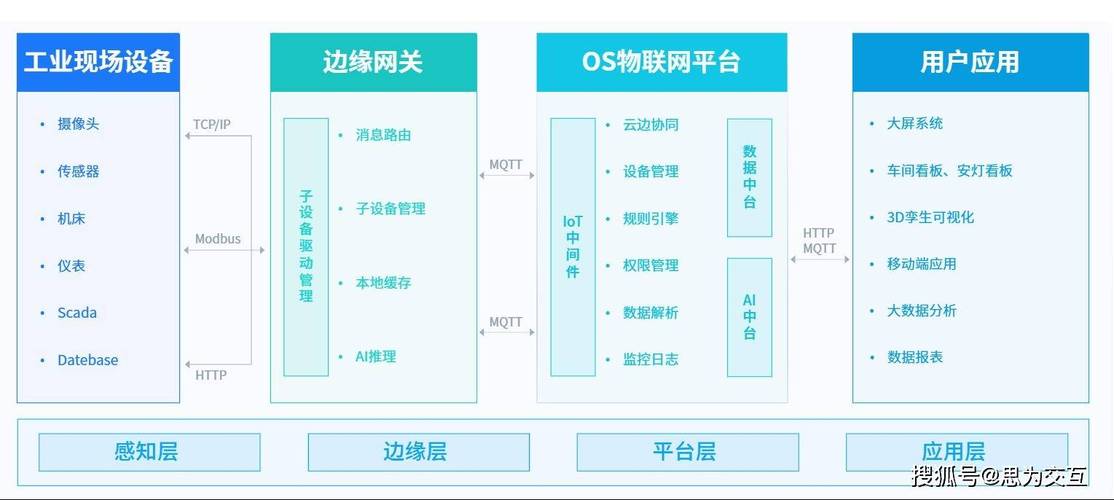
选工业时序数据库最容易踩的3个坑
我见过太多工厂选型的时候被厂商的宣传带偏,花了大价钱上的系统,到现场根本用不起来。踩来踩去就那三个坑: ✅ 第一个坑:只看开源社区热度,不看工业协议适配能力。 很多开源时序库的火爆,是因为服务互联网公司的服务器监控场景。这类场景的接入协议都是通用的HTTP、MQTT,但是到了工业现场,你要接Modbus、OPC UA、Profinet、CC-Link这些工业专属协议,很多库根本没有现成的适配层,还要自己写开发接口,光调试就能耗掉3个月。真正能用在工业现场的时序库,必须自带常见工业协议的解析插件,不用自己从零造轮子。 ❗ 第二个坑:把压缩率当成唯一评判标准。 很多厂商宣传自己能把数据压缩到1:100的比例,听起来很厉害。结果实际用的时候,为了追求极端压缩率,查询的时候要先解压一大块冷数据,本来要查10秒的数,光解压就花了8秒,这不是本末倒置吗?之前见过某厂商的产品,压缩率吹得天花乱坠,实际现场用的时候,算个OEE的小时级聚合,要等1分多钟,产线的实时看板都卡成静态图了,根本没用。 💡 第三个坑:忽略边缘侧的部署能力。 现在很多工厂的车间网络条件根本达不到全量上云的要求,车间到机房的网络时不时就断。如果你的工业时序数据库只能在中心机房跑,那断网的时候采的数据全丢,等网络恢复了还要补传,光数据补全的工作量就能把运维逼走。现在靠谱的方案都是边缘-中心两级部署,边缘侧先存7-30天的本地数据,网络通了自动同步到中心,断网也不丢数。
现在工业时序数据库的落地新趋势
说实话,这两年我看到的工业时序数据库,早就不是单纯的“数据存储仓库”了。 之前的传统流程是:时序库存数据——把数据导到数仓——再导到BI工具——最后做异常检测、OEE计算。整个链路长,延迟高,等数据导出来算完,可能产线已经因为异常停机半小时了。 现在新的落地实践,都是直接把计算能力下沉到时序数据库内部。采到数据的同时,库内的流计算引擎就能实时算OEE,识别轴承的异常振动频率,甚至直接触发告警,把数据处理的链路缩短到1跳。 太爽了。 上个月接触的长三角一家做精密注塑的工厂,之前用老的架构,每天要花2个小时导出模具的历史温度数据,手动分析哪个时段的温度波动导致了产品不良。换了带内置计算能力的工业时序数据库之后,同样的分析10秒就能出结果,去年靠这个能力定位到3次模具温度异常导致的批量不良,省了快20万的返工成本。 很多人说工业数字化是个玄学,其实哪有那么复杂。你把现场产生的时序数据存好、算快、不丢,能实实在在帮工厂少出不良、少停机、省人工,这就是有价值的系统。 别搞那些花里胡哨的概念。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:别再拿普通数据库硬扛工业现场了——工业时序数据库落地避坑指南 https://www.dachanpin.com/a/tg/71763.html