上个月去长三角一家做汽车零部件的工厂,厂长拉着我在中控室站了20分钟,指着满墙的监控屏叹气——17套独立系统,MES、ERP、SCADA、QMS、设备运维平台,每一套都花了几十万上线,结果现在要查某批次零件的全链路溯源,得安排三个实习生分别登三个系统导Excel,凑齐数据要等4小时。
这种场景我这两年见得太多了。很多制造企业的信息化投入,最后都变成了新的“数据竖井”:每个系统都是单独采购、单独上线的,数据格式不统一、接口不开放,你想跨系统拉个数,比登天还难。而工业数据编织,就是这两年从这些竖井里长出来的、真正能解决实际问题的路径。
为什么说工业数据编织不是“又一个新的IT噱头”?
很多人第一次听到这个概念,第一反应是:是不是又换个名头卖之前的数据中台?说实话,我最开始也有这个疑虑。毕竟过去十年,工业领域的概念换了一茬又一茬,从工业4.0到数字孪生,再到工业互联网平台,真正落到车间里能解决实际问题的,真没多少。
但真扎到一线项目里看,你会发现不一样。消费互联网领域提的数据编织,核心是把用户在各个平台的行为数据拼起来,给用户画个精准画像;但工业场景里的工业数据编织,根本不是那套逻辑。车间里产生的数据是什么?是机床的振动频率、焊接的电流曲线、仓储区的温湿度、质检环节的公差值,这些数据从诞生的那天起,就不是为了“被打通”设计的——10年前买的老机床用的是Modbus协议,新上的视觉检测系统存在厂商的私有云里,之前上线的每个信息化项目,做完就成了新的孤岛。
传统的打通思路是什么?建个大的数据仓库,要求所有系统把数据洗干净、格式统一了,全部搬到仓库里。结果呢?数据清洗的成本比上系统本身还贵,一线员工天天要花额外时间录数据、改格式,最后怨声载道,仓库建了一半就闲置了。
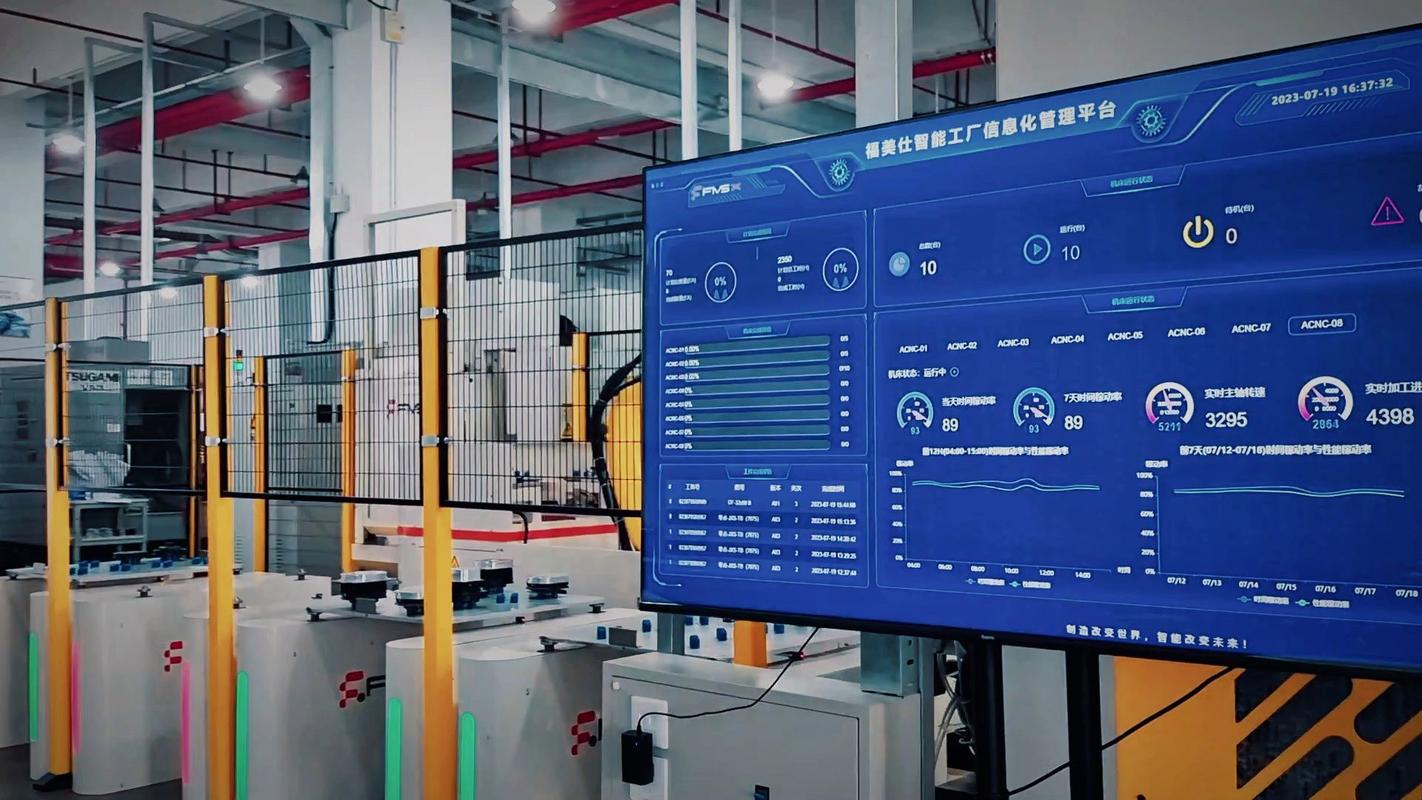
工业数据编织的思路完全反过来。它不要求你把所有数据都搬到同一个池子里,而是在所有分散的数据源上方,织一层动态的、可自我适配的逻辑网络——给每个数据源打一个统一的、可识别的“身份标签”,需要什么数据的时候,系统自动顺着标签去对应源头拉取需要的字段,算完就释放资源,根本不需要长期占用本地存储。
说到这,肯定有人要问我之前踩过的坑,索性直接把大家最关心的问题摆出来:
问:我们厂之前花了上百万做数据中台,最后因为数据质量太差闲置了,工业数据编织会不会也是换个名头卖中台?
答:真不是。你之前踩的坑,本质是“先攒数据再用”的思路——要求车间把所有数据都清洗干净、格式统一了再灌到中台中,可车间一线哪有精力天天给你擦数据?工业数据编织的逻辑反过来:它先适配你现有的数据源,哪怕是老设备传上来的半结构化日志、Excel里记的手动点检值,它都能识别,不需要一线额外做录入工作。就像你织毛衣,不用把所有毛线都拆成一样粗的再织,不同粗细、不同颜色的线,只要能挂上针,就能织成完整的片。
2025年落地工业数据编织,别上来就搞全车间覆盖
这是我见过最多的误区。很多厂商一上来就给你推全工厂的工业数据编织方案,报价大几百万,说要给你打通从原料入厂到成品出库的全链路数据。听着特别美好,实际跑起来,半年都见不到实际效果,钱花了一堆,一线根本没感知。
💡 现在国内落地最顺的工业数据编织项目,全是从最痛的单点切入的。比如哪个环节的溯源要花最多时间,哪个环节的设备非计划停机损失最大,就先在那个小范围织第一片“网”,跑通了再慢慢往外扩,根本不存在一上来就全厂覆盖的好事。
珠三角有个做精密轴承的客户,之前最大的痛点是设备换型时间太长——每次换产,要调参数、查之前的换型记录、核对物料批次,平均每次换型要2小时,一个月下来光换型耽误的产能就有十几万。他们没有搞全车间改造,就先把换型环节涉及的三个数据源:设备的历史参数库、物料批次溯源系统、过往的换型工单记录,用工业数据编织的逻辑连起来。现在换型的时候,系统自动匹配同型号产品的最优加工参数、对应批次的物料库位、之前换型容易出问题的点位提醒,换型时间直接压到35分钟。
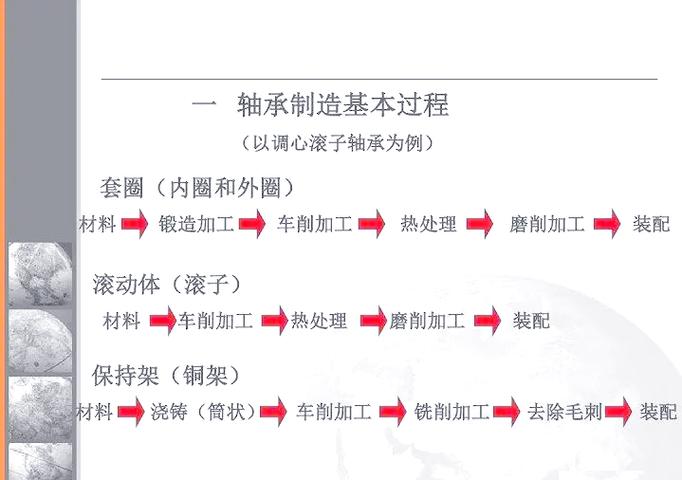
这种小范围的切入,投入往往只有全平台方案的1/5,见效却快得多。很多人觉得搞工业数据编织就要大投入、大改造,其实根本不是。
说到老设备兼容性的问题,也是很多厂的顾虑,索性再答一个大家问得最多的:
问:工业数据编织对老设备的兼容性到底怎么样?我们车间有一半的机床是2015年之前买的,连以太网接口都没有,能接吗?
答:太能了。我上个月接触的一个纺织厂,车间里的老细纱机是上世纪90年代的,连个数据接口都没有,之前要统计停机时间,全靠班长每小时去现场抄表。现在用工业数据编织的方案,根本不需要拆机床改线路——就在机床旁边装个带振动传感器的小盒子,采集机床开停的信号,给这个信号源打个“细纱机运行状态”的标签,直接纳入编织网络。系统会自动把这个信号和对应的机台台账、挡车工的巡检记录、维修工单串起来,一旦发现非计划停机,自动给对应的维修师傅派单,根本不需要给老机床换整套控制系统。
别把工业数据编织当成IT部门的单独项目
这又是个踩过无数次的坑。很多工厂一提到搞数据相关的项目,直接丢给IT部全权负责,结果IT部和车间完全脱节,做出来的东西一线根本不用。
之前遇到个做食品加工的厂,IT部花了3个月把所有系统的接口都拉通了,做了个超大的可视化大屏,上面滚动着全车间的实时产能、能耗、设备状态数据,领导来参观的时候都夸做得好。结果车间主任根本不看这个大屏——他要的是“哪台包装机今天出的产品封口不达标,是哪个参数飘了”,结果大屏上只显示“设备综合效率87%”,半毛钱实际帮助都没有。
说真的,这种项目我见得太多了。IT部门觉得自己把接口打通了就是完成任务,一线觉得你搞的这些东西是给领导看的,最后钱花了,网织了半拉,没人用。
❗ 判断你的工业数据编织项目有没有走偏,就看一个硬指标:上线3个月后,一线员工每天主动打开系统查数据的次数有多少。如果这个数不到10次,不管IT部给的报告写得多么漂亮,这个项目本质就是失败的。
真正能跑通的项目,全是从一线的真实需求倒推的:质量问题溯源要花2天、设备坏了维修师傅找半天找不到故障原因、月底各个部门报的产能数对不上——这些大家天天吐槽的痛点,才是工业数据编织的核心节点,不是为了“打通数据”而打通,是为了减少一线的重复劳动而织网。
现在行业里的趋势也在变。2025年开始,很多工业软件厂商已经不再推“大而全的数字孪生平台”了,反而开始推轻量化的工业数据编织组件——不需要你换现有系统,只要在现有系统上面加一层轻量的适配层,就能把分散的数据串起来。之前要做一个跨系统的溯源报表,得找开发写一周的接口,现在用工业数据编织的逻辑,业务人员自己拖几个标签,5分钟就能生成对应的报表,根本不需要等IT排期。
这才是真的有用。
上周和那个长三角的汽车零部件厂厂长通电话,他说现在先在质量溯源的环节试了工业数据编织,之前4小时的溯源流程,现在10分钟就能出结果。他没搞大投入的全车间改造,就花了之前做数据中台1/5的钱,先把最痛的那个点解决了。
其实做工业的人都懂,哪有什么一步到位的万能方案。
适合自己的,才是真的。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业数据编织:制造企业破局数据孤岛的2025落地指南 https://www.dachanpin.com/a/tg/71765.html