别被厂商PPT骗了:状态监测(CMS)的核心从来不是传感器数量
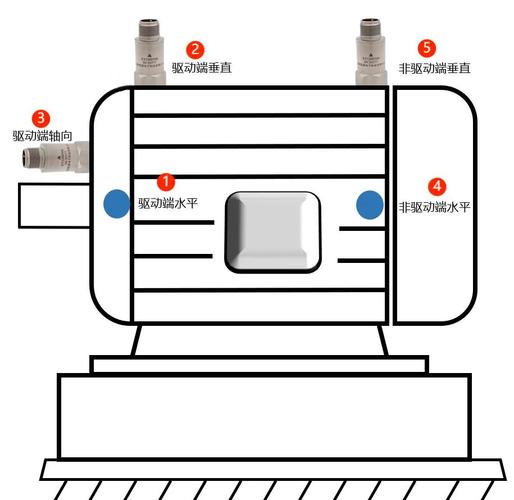
很多厂商推产品的时候,总爱把”多少通道””多少采样率””多少个监测点”放在PPT最显眼的位置,好像点装得越多,系统就越厉害。我前两年去南方一家水泥厂做诊断,他们前前后后装了120多个振动测点,最后捋了一遍发现,最容易磨断的窑托轮传动端轴承,连个温度探头都没有——所有传感器全装在电机的驱动端,离真正的故障高发区隔了整个联轴器。
别上来就全车间铺:老厂上CMS最容易踩的2个钱坑
我接触过的上CMS系统最后成了摆设的厂,10个里有8个是从一开始的思路就错了——刚立项就想全车间一次性覆盖,从主生产线到输送皮带,所有设备都要装传感器,最后预算花出去大几百万,日常运维的人根本盯不过来那么多报警,最后干脆把系统弹窗全关了。 这里面其实藏着两个最容易踩的坑: ✅ 第一个坑:无差别堆高精度硬件。很多厂一上来就给所有设备配最高精度的有线振动传感器,连价值几万块的辅机输送泵都不放过,最后算下来,单台辅机的监测硬件成本比设备本身还贵。实际上只要优先级排对:先抓一次故障停线损失超50万的核心设备,比如主风机、高压电机、齿轮箱、连铸拉矫机,给这些配高精度有线监测点;那些价值低、故障影响小的辅机,用低成本的无线温振节点就行,没必要硬上高配置。 ❗ 第二个坑:装完就不管,靠系统自动设报警阈值。很多厂商装完设备就撤场,留个空平台让运维自己设报警值。你刚开机的新设备,轴承温度45度,你设个50度的报警线,夏天车间温度一高,轴承温度升到52度,系统天天误报,报的多了,大家自然就不当回事了。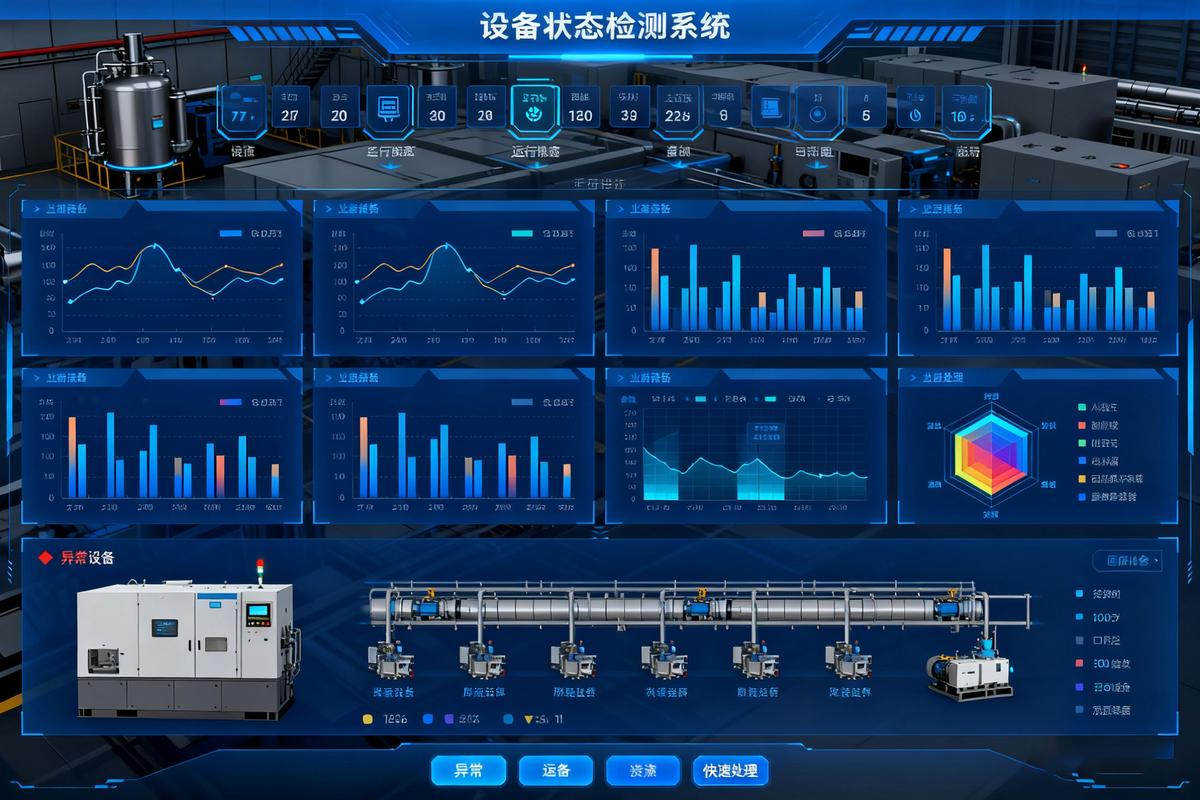
2024年之后的CMS,早就不是你印象里的老系统了
说实话,前几年的CMS系统,确实有很多不尽人意的地方:数据要全传到本地服务器,分析全靠人工盯报表,延迟高,误报多。但这两年的新实践,早就把这些老问题改得差不多了。 现在的主流CMS方案,已经把大部分计算能力下沉到边缘端的智能节点上了——不用把所有振动数据都传到云端,在传感器旁边的边缘盒子里就能算频谱、识别常见故障,报警延迟从以前的几十秒降到了毫秒级。很多新上的系统,还直接跟厂里的检修工单系统打通了:系统识别到异常,自动生成检修工单,派给对应的运维班组,现场处理完之后,再把故障原因回传给系统,慢慢把适配自己厂的故障模型养出来。 之前我也觉得CMS是个”看起来很美”的面子工程,直到去年去宝武的一个冷轧线参观,看到他们的传动系统连续3年没有发生过非计划停机。不是他们的设备比别人的结实,是人家从一开始就没把这套系统当领导参观的展示品——每个运维班的人,每天上班第一件事,就是先看CMS报的异常点,跑现场核对,慢慢把系统磨成了自己的”设备日常体检表”。 别信什么”AI大模型能100%预测所有故障”的宣传,工业现场的环境太复杂了,天车路过的振动、附近设备的电磁干扰、季节变化带来的温度波动,这些干扰没有个1-2年的现场数据积累,什么模型都不准。说白了,状态监测(CMS)本质上就是给设备装了个24小时不眨眼的值班护士,不是买了护士就万事大吉,你得让她真的能摸到设备的脉搏,听得见轴承的心跳,而不是把她安排在离病床30米的值班室里,隔着墙给你报体温。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:状态监测(CMS)装完就吃灰?干了10年设备运维的人掏了实底 https://www.dachanpin.com/a/tg/72125.html