别被PPT骗了:预测性维护算法的核心根本不是算得准
很多厂商的销售上来就给你放PPT,说他们的算法用了最新的大模型,故障识别准确率99%,比老师傅的经验还准。 真到现场你就会发现,实验室里算出来的99%精度,根本经不住车间里的温度波动、切削液飞溅、电网电压不稳这些杂七杂八的干扰。 我见过最离谱的一个项目,算法模型在测试集上准确率98%,上线之后因为车间夏天温度比训练的时候高了4度,所有机台的温度采样值整体飘了2度,算法直接把所有正常运行的设备全判成“异常”,一上午弹了两百多个报警,运维团队直接关了算法权限。
现在落地最稳的三类预测性维护算法,别乱追新
我这三年跑了快40家制造工厂,见过太多为了追新技术花冤枉钱的项目,其实现在真能在生产线上扎下根的算法,就三类。 ✅ 第一类:基于阈值+趋势外推的传统算法。别笑,现在国内70%以上的中型制造工厂,用这个就够了。比如电机的温度、振动值,不是等到超过国标阈值才报警,而是看连续72小时的上升斜率,斜率超过历史同工况的3倍,就提前安排检修。成本极低,不需要买啥大算力的服务器,边缘网关就能跑,师傅也看得懂报警逻辑,不会有抵触情绪。 ❗ 第二类:基于孤立森林的异常检测算法。适合那些根本没有历史故障数据的新设备,比如刚上的进口五轴加工中心,之前从来没出过故障,你根本不知道啥叫“正常的运行状态”,孤立森林能把那些和绝大多数采样点不一样的异常点挑出来,比纯靠老师傅的经验瞎猜靠谱太多。 💡 第三类:基于小样本学习的故障溯源算法。这是2023年之后才慢慢在国内落地的新东西,之前的算法只能告诉你“这里不对”,现在能结合设备的历史维保记录、当前的加工参数,告诉你“大概率是上周换的轴承润滑脂加少了”,不用师傅拆半天找问题根源。
落地最容易踩的三个坑,我见过太多厂栽在这上面
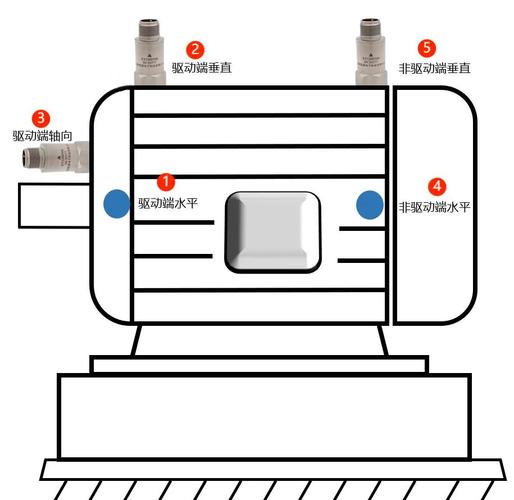
做了这么多年项目,我总结下来,预测性维护算法落地失败的原因,80%都不是算法本身不行,是前期规划的时候就踩了坑。 第一个坑:把算法当“万能超人”。很多老板觉得上了预测性维护算法,就可以把运维团队裁一半,结果算法一旦出问题,没人兜着,直接生产线停3小时,损失几十万。说实话,算法是给师傅搭把手的,不是替人的。真正能用的预测性维护算法,从来不是技术炫技,而是能落地、能让一线师傅愿意用的工具。 第二个坑:传感器乱装。之前见过个厂,为了凑数据量,在机台的外壳上贴了二十几个振动传感器,采回来的数据全是车间风扇吹的振动,算法再牛也算不出真故障。记住,传感器要装在离故障源最近的位置——比如主轴的轴承座上,别装在离轴承半米远的机架上,采回来的全是无效数据。 第三个坑:不做算法迭代。很多厂上算法的时候,拿半年前的训练模型,就扔在那不管了。车间的工况天天变啊,上个月加工的是铝件,这个月加工钢件,振动的正常范围本来就不一样,你不每个季度给算法喂点新的正常工况数据,它迟早给你乱报警。 前两周再去苏州那个轴承厂,张总说现在把算法的误报率压到每个机台每个月2次报警了,师傅们现在主动找算法要数据,因为不用天天半夜爬起来查设备了。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:别再瞎换备件了:落地3年的预测性维护算法,到底帮工厂省了多少真金白银? https://www.dachanpin.com/a/tg/72123.html