为什么多数工厂的“协同”都是假协同
大部分工厂现在的协同,本质上还是“人当传声筒”的模式:中控室看到某个工位的参数飘了,拿起对讲机喊一嗓子,对应工段的工人手动去调设备参数。反应慢,误差大,遇到上下游的波动根本追不上。 就拿那个苏州老板的厂举例,之前冲压机的料厚偏差0.2mm,后面焊接工位的焊枪参数还是按之前的标准料厚设的,结果连续焊穿了300多件结构件,光材料成本就亏了三万多。他之前上的智慧系统,只能在大屏上弹出个“料厚异常”的红色报警,根本没法把调整指令同步传到下游的焊接工位。
现在真正落地的工业协同控制,到底在玩什么
别拿十年前的老方案说事了。2024年真正能跑通的工业协同控制,早就不是那种靠中心化大服务器算完全部逻辑的模式了——现在主流的落地路径,是边缘侧的分布式协同。 简单说,就是每个工位的边缘控制器,和相邻工位的控制器直接通过工业以太网通消息,不用把所有原始数据都传到云端或者中心服务器再算一遍,延迟直接压到毫秒级。比如现在国内头部锂电厂商的产线,辊压、分切、卷绕三个核心工段,就是靠这种分布式协同跑的:辊压出来的极片厚度出现0.01mm的波动,分切工位的张力会自动跟着匹配调整,卷绕工位的拉力参数也会同步校准,根本不用人盯着调。 💡 别信那些说要全栈替换现有设备的服务商——真做过项目的都知道,90%的老设备只要加个边缘IO模块,就能接入协同控制网络,根本不用换PLC,省下来的预算够给产线加两套视觉检测系统了。我最烦上来就让你把所有老设备全换的销售,张嘴就是百万级的预算,本质就是赚信息差的钱。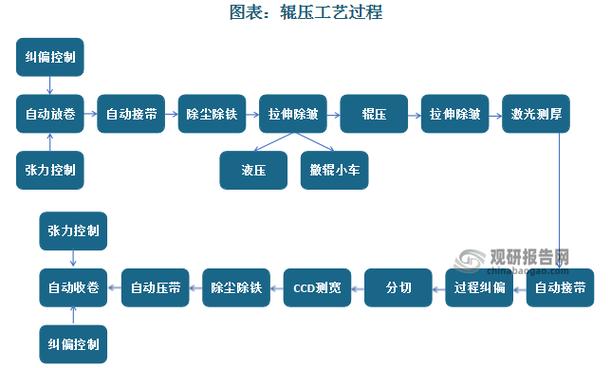
落地的时候最容易踩的三个坑
✅ 第一坑:把协同做成“单向指令传递”。很多人以为协同就是中控给各工段发指令,实际上真正的协同是双向的信息交互——下游工位遇到的问题,要能反向给上游发调整请求。比如总装工位发现前面冲压的零件孔位偏了0.1mm,系统要自动给冲压工位发信号,调整下一模的冲孔位置,而不是等攒了一批废件才被人发现。 ❗ 第二坑:网络带宽留不够。很多厂一开始做协同的时候,只想着传简单的控制指令,结果后面要接视觉检测的实时数据,网线还是用的十年前的百兆线,一到数据量大的时候就卡,控制指令延迟个两秒,够出半批废品了。我们现在做项目,所有协同控制的网络段,至少给千兆冗余带宽,宁可前期多花几千块,也别后面因为卡壳赔钱。 💡 第三坑:不给一线操作工人留人工干预的口子。之前碰到过一个项目,服务商把系统做的全自动化,结果遇到个特殊批次的材料,系统识别不出来,工人想手动调参数都被锁了,最后眼睁睁看着整批料焊废。记住,工业协同控制是给人搭辅助的,不是把人完全踢出去,所有的控制逻辑,都要给一线留最便捷的人工override通道。 上周和那个苏州的老板通电话,他说按照我们给的方案,先从冲压和焊接两个相邻工段做小范围的工业协同控制试点,花了不到15万,现在换产时间从40分钟压到10分钟,废品率掉了两个点。他说早知道这么简单,之前就不花那两百万买那些花架子系统了。 其实真的,工业协同控制从来不是什么玄乎的黑科技。它就是把之前各干各的设备,用最低的成本连起来,让它们能互相搭把手,少出点废品,少停点产,多赚点钱而已。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业协同控制落地指南:从产线孤岛到毫秒级响应的真实路径 https://www.dachanpin.com/a/tg/72306.html