为什么传统视觉检测总在“卡脖子”
很多人对自动检测的认知,还停留在十年前的传统机器视觉方案上。说白了,那套东西的核心逻辑就是人把检测规则写死:比如“灰度差超过5个值就算划痕”“边缘轮廓偏差超过1毫米就算变形”,程序照着规则跑就行。 这套东西用在规则明确的场景里确实好使,比如检测零件有没有装错螺丝,有没有缺件。但一遇到那种形态随机、没有固定规律的表面缺陷——比如注塑件的缩痕、金属表面的细微划痕、极片上的漏箔,直接就卡壳了。之前有个做3C外壳的客户,检测注塑件的缩痕,传统视觉方案调了3个月参数,车间一换灯的色温,整个检测准确率直接掉20%,工程师蹲在车间调了一周,人都麻了。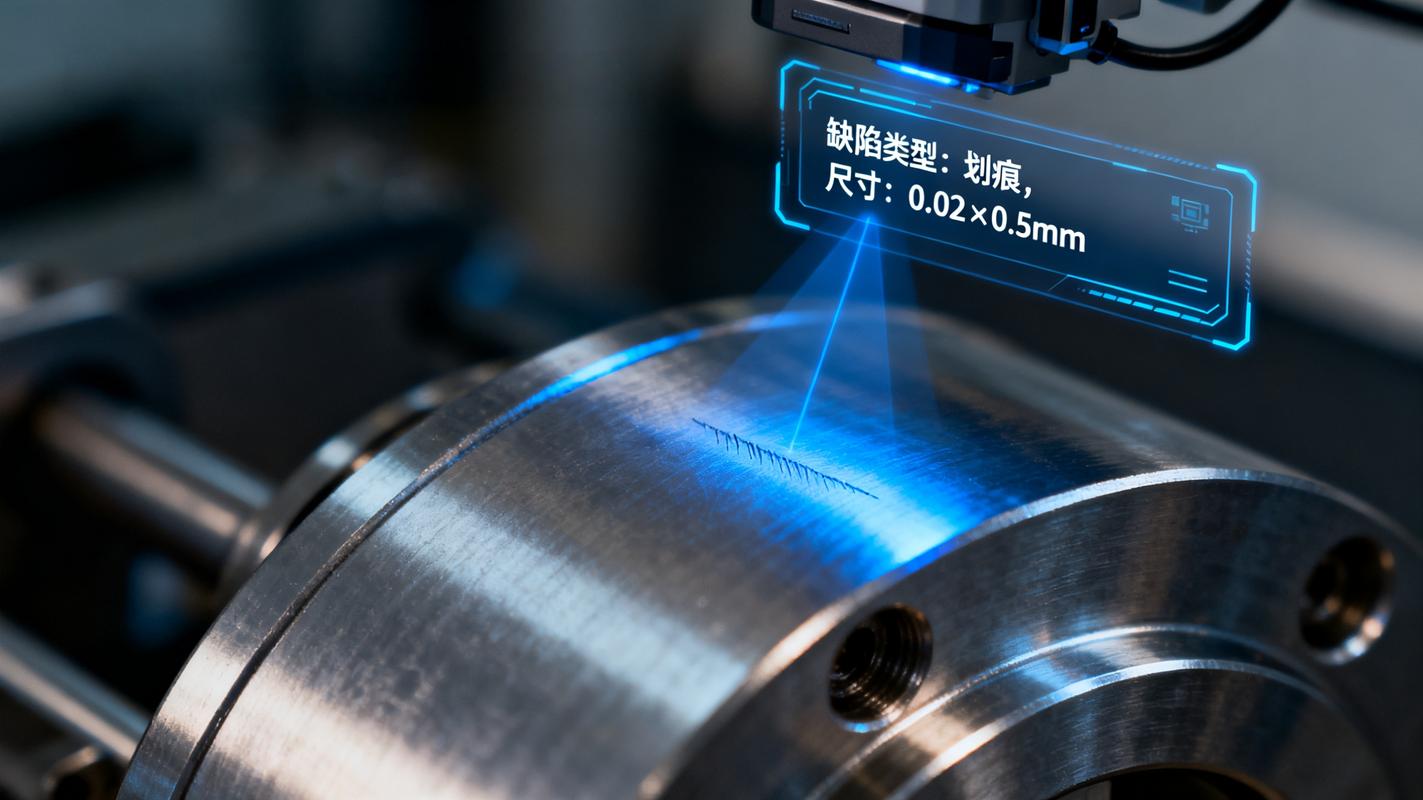
别信“大模型万能”,工业场景的落地全是细节
这两年视觉大模型火,不少销售跑工厂吹,说我们的通用大模型啥都能测,不用训练,拿过来就能用。 听着就离谱。 2024年我们接触的6个相关项目里,有3个厂一开始踩了这个坑。直接拿开源的通用视觉大模型测自家产品的缺陷,跑起来才发现,模型把零件上的一点正常加工纹理当成裂纹,把抛光留下的细微痕迹当成色差,误报率高到产线根本不敢用。之前有个做锂电极片的客户,一开始直接拿通用大模型测极片的漏箔缺陷,模型把极片上的正常涂层厚度波动全判成了漏箔,误报率40%,产线每出10个片子就有4个被挑出来复检,比人工还慢。 💡 这里必须提一句:工业场景的机器学习检测,从来不是拿通用大模型硬套。通用大模型训练用的是互联网上的海量公开图片,根本没见过工业零件上那些细碎的、专业的缺陷形态。真正落地有效的方案,是拿已经在工业场景做了百万级样本预训练的视觉基础模型,用客户自己产线拍的几十张缺陷图做轻量微调,不是从零开始训大模型,也不是直接拿通用模型硬上。
真正决定检测效果的,从来不是算法精度
我见过太多厂商把PPT上的99.9%准确率吹上天,根本不提现场的环境干扰。 说真的,工厂车间哪有实验室里那么恒温恒湿?灰尘飘在镜头上,工人搬东西碰了下光源的角度,夏天车间温度高了光源亮度掉个10%,这些细碎的破事,才是决定你这套系统能不能真的用起来的核心。去年有个做汽车密封条的客户,上的检测系统模型在实验室测的时候准确率是99.5%,结果跑了一个月,因为车间夏天温度高,光源的亮度掉了15%,模型把正常的密封条表面的纹理全判成了开裂,整个系统直接停摆。后来我们给他们加了个每周自动校准的模块,每天开机的时候自动拍一张标准的校准卡,把光源、相机的参数自动调回最优值,跑了半年都没出过类似的问题。 还有个很多人容易忽略的点,就是人在回路的迭代机制。别指望模型刚训完就一劳永逸。现在好用的检测系统,都会留一个简单的操作入口:模型遇到拿不准的边界样本,自动推给当班的检测员,人点一下是合格还是不合格,这个样本就自动进到训练集里,模型每周自动迭代一次,越用越准。那个苏州的轴承厂,刚上系统的时候,每天要处理大概20个边界样本,跑了3个月,每天要处理的边界样本降到2个,模型的准确率从一开始的96%涨到了99.92%,根本不用专门的算法工程师蹲在厂子里维护。 上周跟那个轴承厂的厂长吃饭,他说之前总觉得机器学习是互联网公司玩的东西,跟自己这种开了十几年的传统制造厂没关系。现在算下来,一年光售后赔偿的钱,就比之前省了两百多万。 说句实在的,哪有什么高大上的技术啊。 能帮你把漏检的次品拦在厂里,能少赔点冤枉钱,能让检测员不用熬着通红的眼睛看一天零件,就是好技术。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:机器学习质量检测:从产线漏检率30%到0.1%的落地真相 https://www.dachanpin.com/a/tg/72527.html