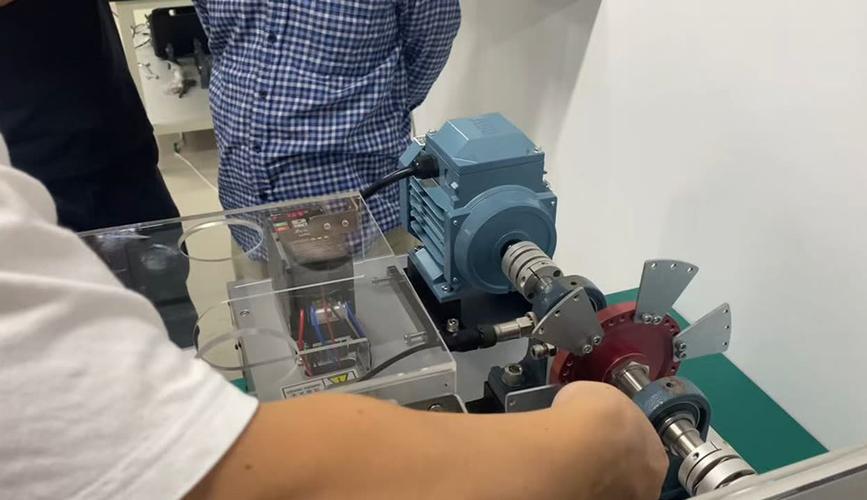
上周去一家做精密减速器的厂子,车间主任老周拉着我看他们刚上线半年的数据平台。大屏挺漂亮。花花绿绿的曲线,实时跳动的数字。他叹了口气说,这玩意儿花了八百多万,现在最大的用处是给客户参观。
我当时没接话。类似的事我见过太多。
数据量从来不是问题,能用才是

工业大数据的第一个误区,是把它当成“海量数据”的同义词。不对。一家中型汽车零部件厂,单条焊装线一天产生的数据量可能就有几十个G,一年下来是PB级别。但这些数据里,真正进入分析管线、真正影响到决策的,百分之几?
我认识的一位做注塑工艺的老工程师说得更直接:我们厂MES里躺着的参数跟车间实际跑的工况对不上。你去问现场操作工,他们随手改两个参数根本不会往系统里录。
这段话背后藏着一个残酷事实。数据质量的问题,远比数据体量的问题要命。
缺失值、时间戳对不齐、不同设备厂商的协议各说各话、编码规范每家一套……这些琐碎的破事儿,占掉了工业大数据项目80%以上的工作量。而算法工程师最不愿意干的,恰恰就是这些。
说实话,我见过太多团队,发布会上讲的是深度学习,实际干的是数据清洗。
三层数据,分清主次
工业场景里的数据,粗略可以拆成三层。
最底下是设备层数据。振动、温度、电流、压力、位移。来源是PLC、传感器、变频器。采样频率高,动不动就是kHz级别。这类数据的特点是噪声大、价值密度低,但里面藏着设备健康状态的信号。
中间是过程层数据。工艺参数、节拍、批次、工单。MES、SCADA、QMS里那些结构化数据。它们回答的是“这批活是怎么干出来的”。
最上面是业务层数据。订单、成本、交付、售后。ERP和CRM的地盘。这层数据的价值最直接,但往往跟下面两层断开了。
问题就在这儿。三层数据如果对不上号,你做出的分析就是空中楼阁。

举个例子。同一批零件出现尺寸超差。从业务层看,是客户投诉。从过程层看,是某台机床某个时间段的加工记录。从设备层看,可能是那台机床主轴轴承在三天前就开始出现异常振动。
能把这三层串起来的工厂,屈指可数。
问:我们厂设备品牌杂,西门子、发那科、三菱都有,协议完全不统一,做工业大数据是不是得先把设备全换一遍?
答:千万别。换设备是成本最高、见效最慢的路子。现实做法是在中间加一层数据采集网关或者边缘计算盒子,通过OPC UA、Modbus、Profinet这些协议做统一接入,再往上对接统一的数据模型。设备层保持原样,别动。改造的重点应该放在网关和上层的数据中台,而不是产线上的铁疙瘩。另外提一句,很多老设备本身没有数字化接口,加装外置传感器反而是性价比更高的选择。
边缘计算,别急着上云
有个现象挺有意思。不少工厂搞数字化,第一反应是“上云”。数据全推到云端,算法全在云上跑。
然后呢?一条冲压线每分钟几十次行程,每次行程几百个数据点,你把这些全推到云上去处理,光带宽成本就够呛。更别说延迟。
产线上的实时质量判定,响应时间要求可能是几十毫秒。云端往返一趟早就超了。
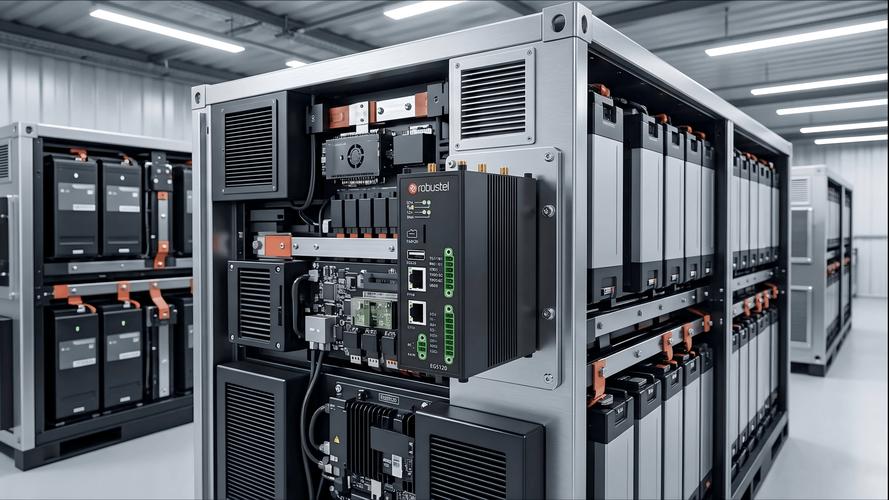
所以现在越来越多项目走的是边缘侧处理加云端训练的路线。边缘盒子在本地做实时推理、做数据过滤、做异常初筛,只把有价值的数据和特征上传。云端负责模型训练、跨厂区横向对比、长周期趋势分析。
💡 一个经验判断:需要毫秒级响应的,放边缘;需要跨设备跨厂区对比的,放云端。
这两者之间怎么划界,得看具体业务。没有标准答案。
工艺优化才是真金白银
设备预测性维护,是工业大数据里被讲得最多的场景。但我要说句可能得罪人的话:纯粹的预测性维护,ROI算下来并不总是划算。
原因很简单。关键设备的故障停机损失确实大,但这类设备的故障率本来就低。你花大力气建模型,可能一年也就躲过两三次非计划停机。而模型的维护成本、传感器成本、人力成本摆在那儿。
相比之下,工艺参数优化的回报更直接,也更持续。
举个真实的例子。铝合金压铸。同一台压铸机,同样的模具,不同班次做出来的件,气孔率能差出一倍。为什么?压射速度、模具温度、铝液温度、保压时间,这些参数之间是耦合的。老师傅凭经验调,能调到一个不错的状态,但换个人、换个班次,就飘了。
把历史工艺参数和质检结果放一起做分析,找出一组参数的最优区间,固化到MES里,让设备自动按这个区间走。这个动作带来的良率提升,通常就是几个点。对压铸厂来说,几个点就是几百万。
这类项目的好处是,不需要新增大规模硬件投入。数据本来就有,只是没人去挖。
问:我们做的是小批量多品种,每个订单的工艺参数都不一样,这种场景下大数据还有用吗?
答:有用,但思路要变。大批量场景下你做的是同一工艺的深度优化;小批量多品种场景下,你做的更多是相似工艺的检索和复用。把历史订单的工艺参数、材料、设备、质检结果建成特征向量,新订单一来,先检索历史上最相似的几批,把他们的参数作为初始值推给工艺员。这能大幅缩短试制周期。另外,小批量场景下更要关注的是参数与质量之间的因果结构,而不是单纯的统计相关,否则容易过拟合到某一个特定批次上。
那些踩过的坑
写几条实际的。
坑一:上了平台没人用。 界面上指标一大堆,车间主任看不懂,操作工懒得看。数据平台最后变成了领导的参观道具。解决办法其实土得很:把分析结果推到现场看板,推到班组长的手机端,让数据追着人走,而不是让人去追数据。
坑二:追求大而全。 一上来就想把所有设备、所有工序、所有指标都接进来。结果两年过去了,还在做数据接入。正确姿势是选一个痛点明确、边界清晰的场景先跑通,比如某台关键设备的能耗分析,或者某道工序的良率波动归因。
坑三:算法团队不懂工艺。 这个太常见了。数据科学家拿着Excel表跑模型,跑出个R²等于0.95,兴冲冲去汇报,工艺工程师一看就说这变量根本不可能影响结果,是你们的数据采集有问题。❗ 工业大数据项目里,懂工艺的人比懂算法的人稀缺得多。
坑四:忽略数据的时间对齐。 设备数据是毫秒级,质检数据是小时级,订单数据是天级。这三个时间尺度上的数据要怎么对齐到同一个分析单元上,这个问题不解决,一切分析都是错的。
说点实在的
工业大数据这东西,不是买套软件、招几个算法工程师就能搞定的。它更像是一场持久的基础设施建设。
数据采集要稳。数据治理要细。业务理解要深。这三样缺一样,项目就会卡住。
至于那些动辄谈大模型、谈AI原生工业的……我不否认技术方向,但就当下的落地情况看,能把设备台账理清楚、能把工艺参数对齐好的工厂,已经跑赢一大半同行了。
别急。先把自家车间里那堆烂数据理明白。这一步过了,后面的事才有得谈。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业大数据落地真相:多数工厂的数据平台最后成了摆设 https://www.dachanpin.com/a/tg/72800.html