三年前我在一家做风电齿轮箱的厂子里待过两周。现场工程师把报警后台点开,屏幕上滚着两百多条“振动超标”。他耸耸肩:现在没人看了,全静音。
就是这么现实。报警疲劳这四个字在论文里轻飘飘的,落到车间就是一行静音设置。
所以每次有人问我预测性维护算法到底难在哪,我的答案从来不是“该选哪个模型”。难的是让算出来的结果被人当回事。
单纯设阈值这条路,早就走到头了
很多工厂的第一版方案是这么干的:振动烈度超过4.5 mm/s报黄,超过7.1报红。ISO 10816 那一套。简单、便宜、能过验收。
然后呢?
工况一变,全废。同一台泵,夏天高负荷、冬天低负荷,同样转速下振动值能差出三成。你拿一个固定阈值去卡,要么天天误报,要么真出事的时候它还在睡觉。
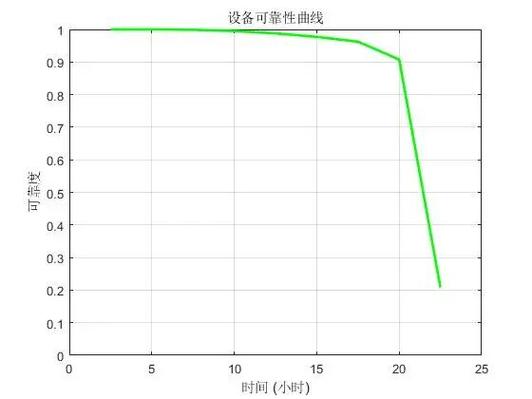
更要命的是,突发性故障根本不给你爬坡的时间。轴承内圈剥落,从第一个微观点蚀到抱轴,可能就几个小时的事。等阈值报警响起来,人已经在拆机了。
预测性维护算法要做的,是把“越线才响”变成“趋势在变,提前几天就该动手”。

真正能在产线上跑得动的几类算法
别被那些论文标题唬住。工业现场用得上手的其实就几类,而且分工很清楚。
第一类,无监督异常检测。自编码器、孤立森林,还有这几年火起来的对比学习。凭什么排第一?因为故障样本实在太少。一条产线一年坏三次,你哪来的训练集。无监督只学“正常长什么样”,偏离就报警,这个思路在工业界是刚需。
我个人更偏好基于重构误差的自编码器,再配一个动态阈值。理由很俗:好解释。重构误差变大,工程师能理解;你要是甩给他一张Transformer的注意力热力图,他只会皱眉。
第二类,退化建模与RUL预测。这才是预测性维护算法里真正的“预测”部分——剩余寿命。常见路子有LSTM、GRU这类循环网络,也有近几年流行的TCN和Transformer变体,再有就是传统的维纳过程、伽马过程和粒子滤波。
说句可能得罪人的话:在样本量不超过几千条的情况下,粒子滤波配一个物理退化模型,常常打得过LSTM。为什么?轴承退化是有物理规律的,你硬让网络从数据里学,它得先学一遍你早就知道的东西。数据不够,它连这个都学不会。
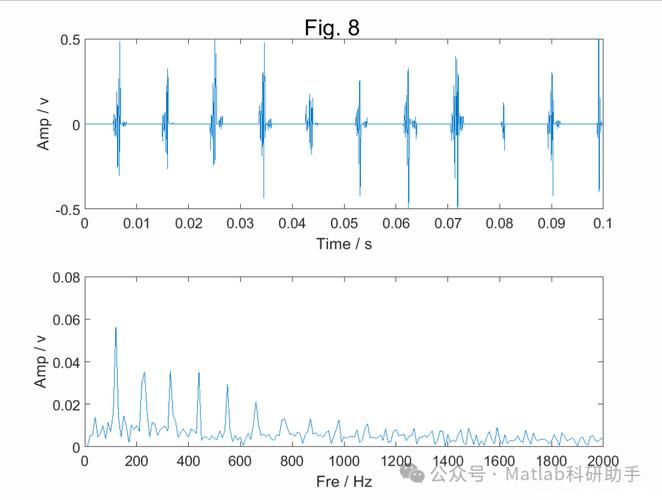
第三类,物理模型加数据驱动的混合方法。这是我最看好的一块。比如用动力学方程算出理论故障特征频率(BPFO、BPFI、2×BSF),再让算法只盯着这几个频带做能量追踪。搜索空间一下小了一个数量级,需要的样本量也跟着往下掉。
顺便一提,特征工程在工业界的重要性被严重低估了。很多人一上来就想着把原始振动信号喂给CNN。可以,能跑通,但你得有几万条带标签的样本。现实里你手里只有几十条。
时域的RMS、峭度、峰值因子,频域的阶次谱、包络谱、边带分析,时频的小波包能量——这些手工特征配上XGBoost,在中小数据集上的表现往往比端到端深度学习稳得多。别瞧不起它。
问:我们厂一年也就几次故障,数据量很小,还能不能做预测性维护算法?
答:能,但思路得换。别做监督学习,做无监督异常检测加机理特征提取。具体说,先挑关键设备(不要一上来全厂铺开,那不现实),采集至少三到六个月的正常运行数据,把工况分层——按转速、负载、温度分箱。然后在每个箱里建一个“正常基线”模型。新数据进来,先判断它落在哪个工况箱,再跟对应的基线比。
完全没标签怎么办?走迁移学习。公开数据集比如C-MAPSS、凯斯西储大学轴承数据,虽然不是你的设备,但预训练出来的特征提取器迁移到你自己的数据上,比从零训强得多。❗关键是要做域自适应,否则容易负迁移,越训越糟。
落地时最容易被低估的几个坑
算法写得漂亮,上线三个月被废弃——这种事我见得太多了。原因往往跟算法无关。
坑一:传感器装错位置。磁吸式加速度计贴在薄壁罩壳上,测到的全是罩壳共振,跟你关心的轴承故障隔着十万八千里。安装位置、耦合方式、采样率,这些是最基础的东西,却最常被跳过。
坑二:数据漂移没人管。模型是拿去年秋天的数据训的,今年换了原料、改了工艺参数,特征分布早飘了。预测性维护算法必须带在线监控和再训练机制,不然它只会安静地给你错误答案,比不报警还危险。
坑三:报警没有闭环。系统说“这台减速机未来7天有62%的概率故障”,然后呢?没然后了。没人建工单,没人复查,没人回填结果。三个月后这套系统就变成墙上的装饰品。
说实话,第三条比前两条致命得多。算法的价值不在于算得准,在于能牵动一次维修动作。
问:模型上线后准确率掉得厉害,一般是什么原因?
答:按我的经验,排查顺序是这样的。先看数据质量——传感器是不是松了、线缆有没有干扰、采样有没有丢点。这一步能解决三成的问题,而且最便宜。再看工况分布有没有变,做个简单的协变量偏移检测,比如KS检验,或者干脆训个小分类器去区分新旧数据。如果确实飘了,做增量训练,或者按工况重新分层建模。最后才去怀疑模型本身。
还有个特别容易被忽略的点:你的标签本身可能就是错的。维修记录里的“故障时间”经常是发现时间,不是发生时间,中间能差好几天。拿这种标签训出来的模型,能准才怪。
另外提一句边缘部署。现在不少厂子愿意把推理放在网关或者PLC边上跑,高采样率的振动信号不方便全量上云。这时候模型大小和推理延迟就是硬约束。一个精简的LSTM可能跑得动,一个大Transformer就未必。💡量化、剪枝、知识蒸馏这些在视觉领域用烂了的招数,放到工业边缘侧其实还挺管用。
一点个人判断

这个方向接下来会往哪走?我的看法是,纯数据驱动的故事已经讲得差不多了。物理机理提供归纳偏置、数据提供修正量,混合方法会是主流。大模型在工业里也有人试,但短期内替代不了针对性设计的小模型,边缘侧尤其如此。
还有一点,别再迷信“一个模型搞定全厂”。不同设备类型、不同失效模式用不同算法,这是常态。冲床的模具磨损和功率器件的击穿,压根不是一回事。
最后回到开头那位把报警后台静音的工程师。他后来跟我说了句话,我记到现在:“你们算法要是能少报两次假警,我就信你。”挺朴素的。可这就是预测性维护算法在工业现场真正的KPI。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:预测性维护算法落地实录:从阈值报警到RUL预测,哪些模型真能扛住产线 https://www.dachanpin.com/a/tg/72904.html