为什么工业负荷预测突然成了刚需?
放在十年前,没多少工厂关心这个。那时候电价差小,也没什么需求响应补贴,负荷多一点少一点,对总成本影响不大。 现在不一样了。 双碳目标下,新型电力系统要求工业用户侧削峰填谷,参与电网调节。你要拿补贴,就得提前报你的可调节负荷,预测不准,报多了调不出来要罚,报少了赚不到钱,两头不讨好。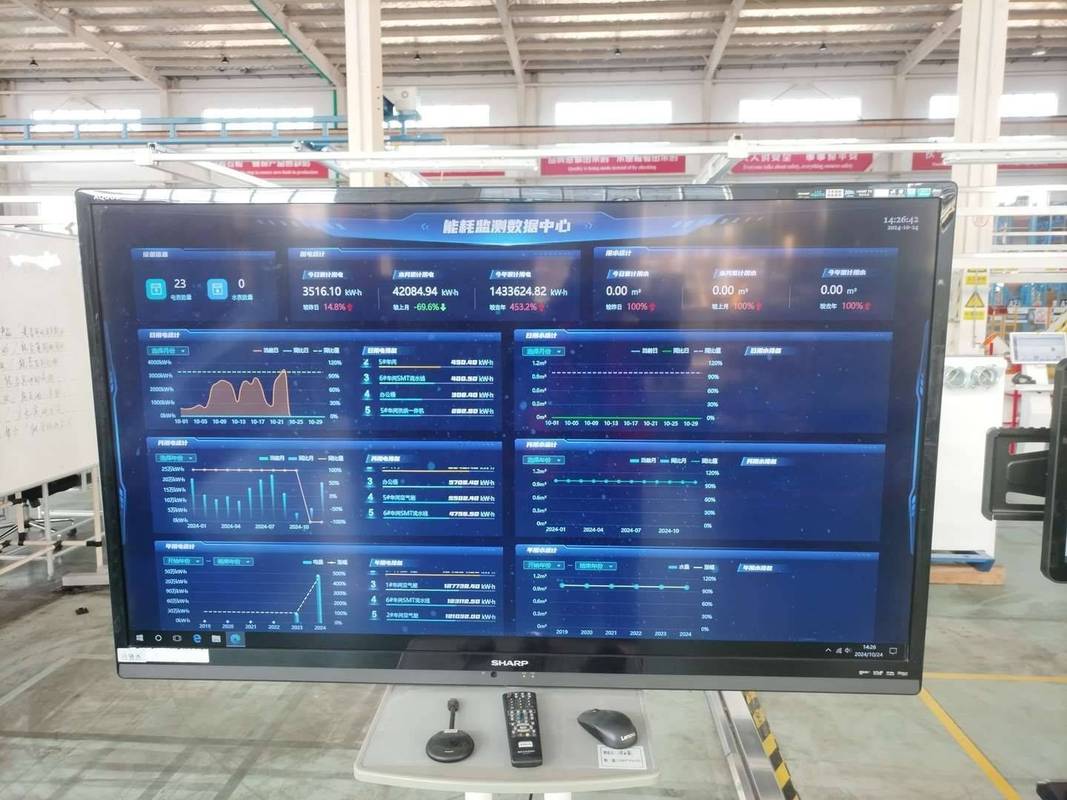
工业负荷预测的常见坑,十家有八家踩过
说实话,我见过太多工厂花了大价钱上预测系统,最后根本用不起来。要么误差大到离谱,要么根本不贴合工厂的生产实际,最后还是靠车间主任凭经验拍脑袋,钱全打了水漂。 最常见的坑是什么?就是拿民用负荷预测的模型直接改改就用。民用负荷是跟着居民作息走,规律稳定,工业负荷呢?完全不一样,今天有急单开十条线,明天设备检修只开一条线,负荷波动能差出去好几倍,通用模型根本抓不住这个规律。 第二个坑,只拿配电侧的历史数据建模,根本不接生产端的数据。很多工厂做预测,就把SCADA里存的历史负荷拉出来训练模型,根本不告诉模型明天的排班、订单、设备计划,那能准吗?相当于你让一个人算命,却不告诉他你今天要出门还是要在家,怎么可能算对。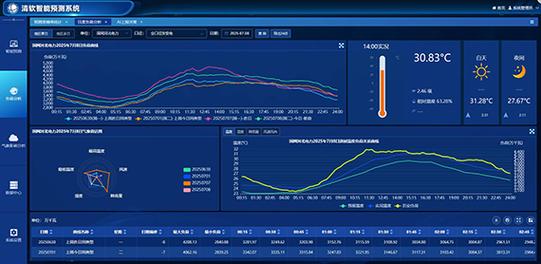
怎么做才能拿到能用的工业负荷预测结果
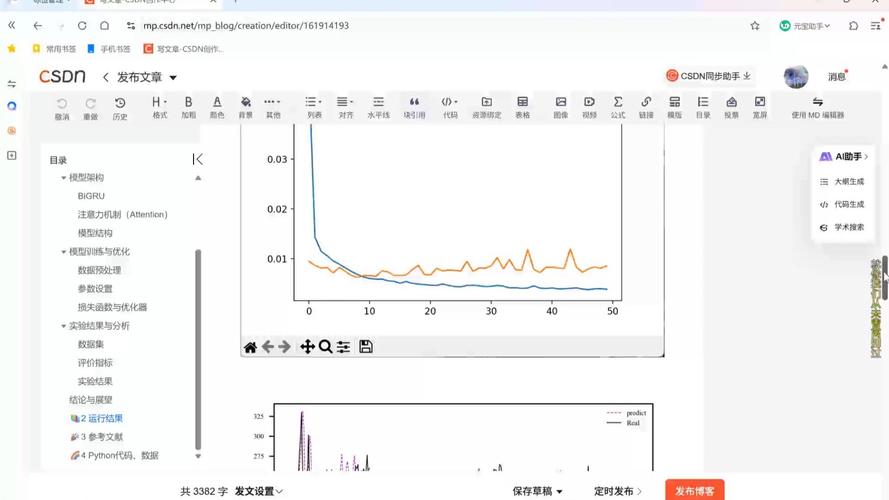
别只拿配电数据喂模型,一定要把生产端的数据接进来:订单量、排班计划、设备检修安排、甚至环境温度(夏天空压机、制冷设备的负荷就是比冬天高30%以上),多一个维度的数据,误差就能降好几个点。 ❗ 别搞大一统模型,分场景建模更准
一个工厂里,不同工序的负荷规律完全不一样:炼钢高炉是连续负荷,热处理是间歇负荷,办公区是稳定负荷,混在一起建模肯定不准。分开给每个工序建模,最后再加总,误差能直接降一半,亲测有效。 ✅ 给现场人员留调整空间,别做全闭环黑箱
生产现场永远有意外:临时插急单、设备突然故障、原材料晚点,这些情况模型没见过,肯定预测不准。一定要给车间调度留手动调整的入口,模型给基础预测,人再根据实际情况调,结果比纯模型准太多。 现在最新的实践,很多工厂都不用那种大参数的通用大模型了,反而用行业小模型做微调,成本低,精度还更高。毕竟工业负荷的规律就那些,不需要模型去学乱七八糟的通用知识,把行业规律吃透,就足够用了。 去年我接触过山东一家中型焦化企业,之前用通用模型预测,误差稳定在18%左右,后来调整了建模方式,把生产计划和焦炉的升温计划都接进去,误差直接降到了6%以内,一年下来,光省的电费加拿到的需求响应补贴,就多赚了200多万,整个项目的投入才不到20万,这回报率,真的没话说。 不过话说回来,也不是所有工厂都得砸几十万上定制系统。中小工厂,找那种针对工业场景优化过的标准化SaaS服务就行,按月付费,一个月几千块就能用,先跑三个月看看效果,确实省了钱再续约,风险小很多。 现在制造行业降本,能挖的显性成本都挖的差不多了,原材料、人工,能挤的空间越来越小。像工业负荷预测这种,藏在运营细节里的优化空间,其实就是没被挖透的金矿,就看你愿不愿意弯腰去捡了。
相关推荐
-
直接数字控制(DDC)实战:从接线到调参,那些没人告诉你的坑
一、这东西,早该改进了 我第一次接触直接数字控制(DDC)是在十年前的一个商业综合体项目。那时候觉得这玩意儿真神——一个小盒子,代替了成排的继电器。但说实话,这些年下来,槽点真的不少。比如某些品牌的底座接线端子,那叫一个紧!螺丝刀拧到手酸,手指头磨掉一层皮。❗ 不过话说回来,DDC的核心——直接数字控制——确实把暖通空调的控制带入了数字时代。传感器采集温度湿…
-
等离子切割:干了二十年,有些槽不吐不快
上礼拜去老李的车间,看见那台新买的等离子切割机,噗噗地冒着火花,切出来的板子边缘斜得跟狗啃的似的……老李居然还挺满意,说比以前用氧乙炔快多了。我上去按了个暂停,跟他说——你这割嘴已经烧穿了,还在用?他嘿嘿一笑,说没注意。没注意?这玩意儿烧穿以后,气流全乱了,切缝宽得能塞进一块钱硬币,还指望垂直度? 等离子切割这行当,说实话,入门门槛低得离谱,是个人培训两天就…
-
方向盘上的春秋:一位物流人的十年征途
老周的解放牌卡车刚驶进服务区,后斗里的猕猴桃就传来轻轻的碰撞声。他拉开车门跳下去,习惯性地绕到车尾检查篷布,指腹划过被雨水浸得发暗的帆布,忽然想起十年前第一次装货的情形。那时他还是副驾,跟着师傅跑广州到昆明的线路,如今自己也成了能独当一面的老把式,卡车仪表盘上的里程数早已突破百万。 车斗里的猕猴桃来自眉县的果园,凌晨三点刚从枝头摘下,带着晨露就被搬上了车。货…
-
传感器技术,为什么我劝你别再迷信“高精度”了?
干这行十几年了,传感器见过不少。从早期那种傻大黑粗的应变片,到现在指甲盖大小的MEMS芯片,东西是越来越精巧,参数也是越来越卷。 但说实话,最近几年我越来越觉得不对劲——很多人选传感器,开口就是“精度要0.01%”,闭口就是“响应速度要微秒级”。可你问他装在哪、测什么介质、环境温度多少……他懵了。 今天想聊点实在的。关于传感器技术,我劝你先别急着看参数表。 …
-
工业除尘系统选型避坑:别花几十万买个摆设
上个月刚给珠三角一家五金抛光厂改完除尘。老板蹲在车间门口抽烟,脸黑得跟锅底一样。前两年花42万装的工业除尘系统,环评刚过半年,就堵得没风了。车间里粉尘飘得看不见三米外的机床。工人干不到一个月就跑,招人的工价涨了两千都留不住。太坑了。 为什么很多工业除尘系统刚装完就废了 说出来你可能不信,八成以上的除尘效果差问题,不是设备质量差,是选型从根上就错了。 很多厂家…