
制造企业的数据老坑,为什么始终绕不开
原来的方案无非两种。要么建数据仓库,只存结构化好的业务数据,非结构化的振动波形、质检X光片根本存不了,就算强行存,查询一次的成本够你给产线买三箱冷却液。 要么建纯数据湖,什么数据都能扔进去,原始数据全留着,真要找某台设备2023年10月的故障数据,搜俩小时出不来,更别说跑模型训练了。 说白了,就是原来的架构,把湖和仓切成了两张皮,数据要来回搬,格式要反复转,折腾来折腾去,项目周期拖半年,预算超一半,最后还达不到效果。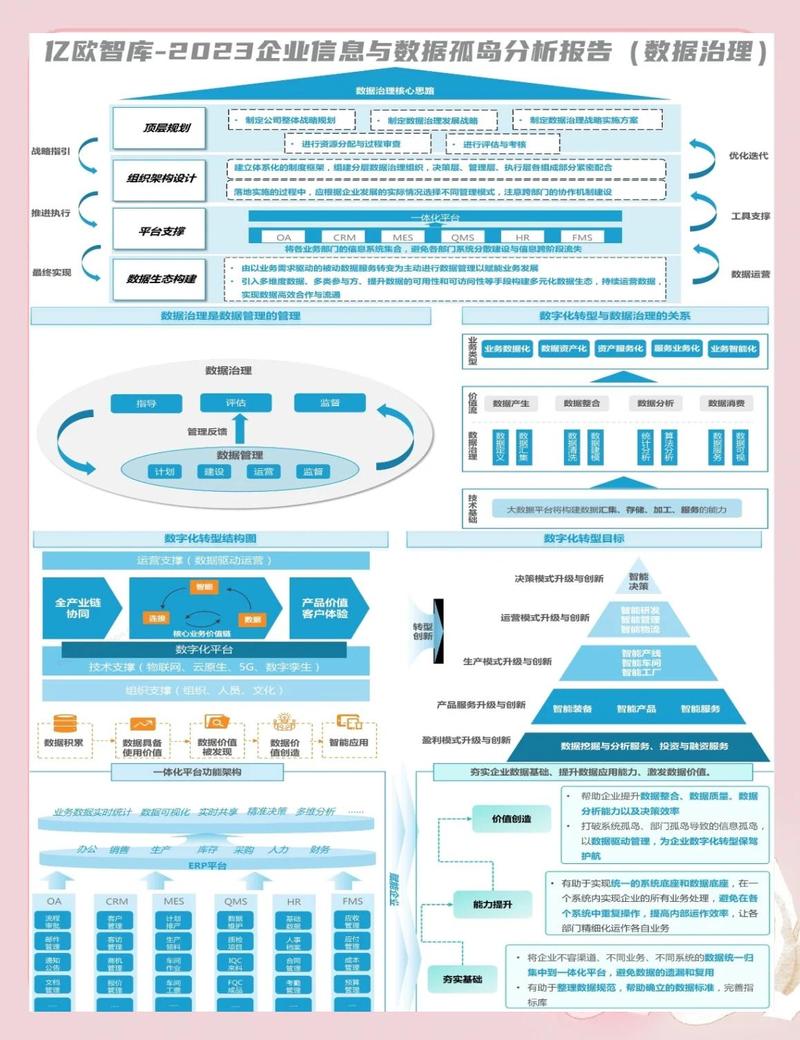
工业场景下的数据湖仓一体,落地逻辑是什么
说白了,数据湖仓一体不是把原来的湖和仓拼到一起卖的概念货。它是一套统一的架构,全量的原始多模态数据直接存在湖上,加工好的、面向业务分析的结构化数据存在仓里,用一套引擎就能查,不用搬来搬去转格式。 对工业来说,这个改变太重要了。工业数据是什么特点?量大,模态杂,十年的设备数据加起来几个TB甚至几个PB很正常,而且既有数字参数,又有波形、图像、文本这些非结构化数据。原来的架构根本hold不住。 现在新能源车企的电芯工厂,每一片电芯从涂布到封装,有上百个生产参数,还要存每一片的X光质检图像,用来做缺陷识别模型的训练。原来的方案,只能存一周的最新数据,旧数据要挪到离线磁带库,真要拿出来训模型,调数据就得花一周。用上数据湖仓一体之后,全量数据在线存储,要训模型直接拉取,几个小时就能跑完,模型更新的速度快了好几倍。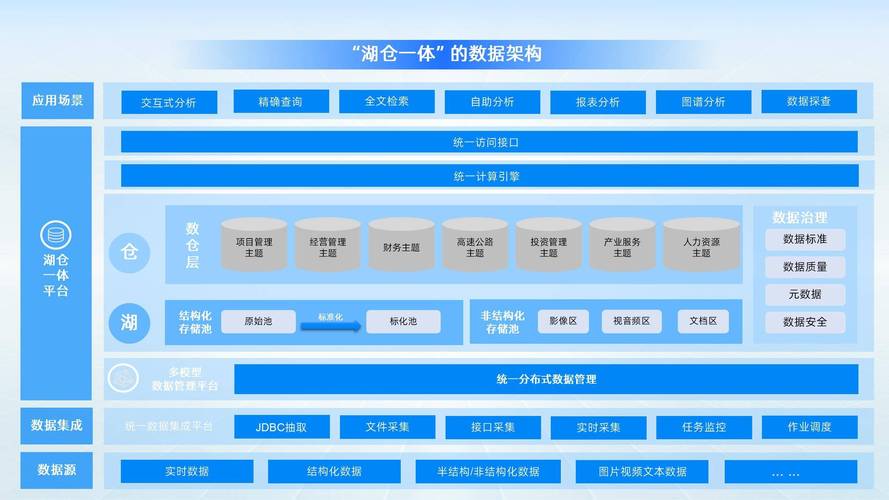
当前工业落地的避坑指南,都是踩过坑的经验
相关推荐
-
工业除尘系统选型避坑:别花几十万买个摆设
上个月刚给珠三角一家五金抛光厂改完除尘。老板蹲在车间门口抽烟,脸黑得跟锅底一样。前两年花42万装的工业除尘系统,环评刚过半年,就堵得没风了。车间里粉尘飘得看不见三米外的机床。工人干不到一个月就跑,招人的工价涨了两千都留不住。太坑了。 为什么很多工业除尘系统刚装完就废了 说出来你可能不信,八成以上的除尘效果差问题,不是设备质量差,是选型从根上就错了。 很多厂家…
-
白色病房里的生命微光
消毒水的气味总在推开医院大门的瞬间裹住每一个人,那味道里藏着太多复杂的情绪 —— 有人攥着病历本的指节泛白,有人在走廊尽头悄悄抹泪,还有人抱着刚打印出的检查单,反复确认上面的每一个字。这里是与生命距离最近的地方,冰冷的仪器声和温暖的话语交织,每天都在上演着关于坚持与守护的故事。 李阿姨躺在呼吸科病房的病床上时,窗外的梧桐树刚抽出新芽。她是个特别怕疼的人,就连…
-
车间里的帕累托分析:用二八法则揪出设备故障的“惯犯”
帕累托分析?说白了就是二八法则。但工业现场里,它可不是教科书上那个干巴巴的直方图。每次我在车间看到维修班长对着报修单画那个歪歪扭扭的柱状图,都会想起十几年前自己刚入行那会儿——觉得这玩意儿太简单了吧,能解决啥问题?结果被现实狠狠打脸。那时候一条产线每个月非计划停机二十多次,老板急得跳脚,我们一群人扑上去什么都修,结果越忙越乱。后来一个老师傅说,你们能不能先看…
-
二手车交易那些事儿:像拆盲盒但能少踩坑
身边总有人说买二手车像开盲盒,你永远不知道打开引擎盖会看到惊喜还是惊吓 —— 可能是保养得比自家沙发还干净的发动机,也可能是藏着三五个焊点的 “拼接艺术品”。作为一个帮三位朋友淘过车、自己也踩过两次坑的 “半吊子专家”,今天就来聊聊二手车交易里那些让人哭笑不得的事儿,顺便给想入坑的朋友支几招,争取让大家把盲盒变成 “明盒”。 首先得说说选车时的 “幻觉效应”…
-
科技之光:照亮文明演进的新征程
科技是人类文明进步的核心驱动力,它以无形的力量重塑着生产方式、生活形态与认知边界。从工业革命时期的蒸汽机轰鸣到数字时代的算力奔腾,每一次科技突破都为社会发展注入澎湃动能,推动人类从蒙昧走向开化,从地域隔绝迈向全球互联。现代科技体系的构建并非一蹴而就,而是无数科研工作者历经百年积淀的智慧结晶,其影响力已渗透到经济、医疗、生态等诸多关键领域。人工智能的深度学习算…
