为什么说工业数据编织不是换皮忽悠的新概念
之前接触过的做数据中台的工厂,三家里面两家烂尾,还有一家只能用用基础报表功能,根本做不到实时的全链路分析。为什么?因为工业数据太复杂了。老设备用的还是二十年前的私有协议,新设备又是各家厂商锁死了接口,你要把所有数据都抽出来统一存储,光是做适配就得大半年,抽出来的过程还丢了很多现场时序上下文,最后出来的数据就是死的,用不了。 工业数据编织不一样,它核心逻辑不是「搬数据」,是「织连接」。数据还留在原来的地方,不用动,只需要做一个统一的语义层,把各个数据源按照业务逻辑连在一起,要用的时候直接调用,不用挪窝。就像织一张网,每个节点就是你原来的数据源,网织好了,你要找哪个点,顺着线就能过去,不用把所有节点都搬到同一个地方。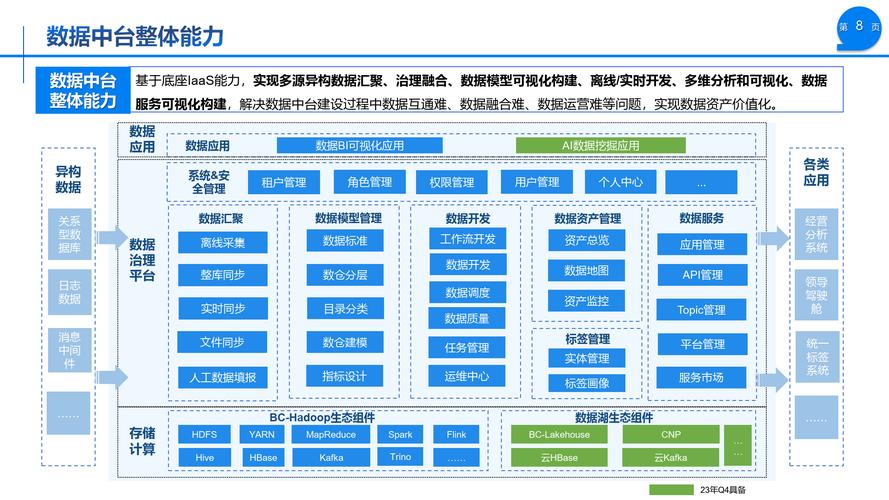
工厂落地工业数据编织,最先要踩实的三步
很多厂商销售一进门就说「我们全栈搞定,几百万上了马上见效」,说实话,十有八九是坑。落地工业数据编织,别上来就砸大钱搞平台,先把这三步踩实了: 1. ✅ 先画全你的数据源地图。把工厂里所有需要接入的数据源列得明明白白:哪台老机床带不带数据接口,MES是什么版本,ERP是谁家的,供应链数据多久更一次,每个数据源由哪个部门管,调数据需要什么权限,一条一条列清楚。别漏了非生产数据,比如办公系统里的设计图纸变更记录、供应商的来料检验报告,这些数据很多时候才是解决问题的关键。 2. ✅ 先从小场景试跑,别贪大。一上来就要覆盖全工厂所有业务,十有八九死在路上。找你工厂最痛的那个点,比如某条线不良率一直降不下来,或者换型调机时间太长,就围绕这一个场景做工业数据编织,把相关的十来个数据源连起来,跑通了,看到实实在在的降本增效了,再往其他场景扩。我见过太多工厂上来就要「一揽子解决所有问题」,做了一年多,各个部门需求都协调不完,最后项目搁置,大几百万打了水漂,太可惜了! 3. ✅ 提前统一业务语义。这个是最容易忽略,也最容易出问题的点。同一个词,不同部门定义完全不一样:生产部说「停机」就是停够10分钟以上才算,设备部算维护时长,停1分钟就算。把这两个数据织在一起,出来的OEE计算能差出20%,整个分析全错。所以接入之前,先拉上生产、设备、质量的老员工,把所有核心术语的定义统一好,再动手。 问:我们厂就是个两三百人的中小工厂,没多少钱投数字化,也能做工业数据编织吗? 答:当然能。又不是只有百万级的项目才叫工业数据编织。现在开源社区有很多成熟的工业连接框架,云服务也按流量付费,你先围绕一个小场景做,几万块甚至几千块就能先跑起来。比如你就是注塑车间的良率上不去,那就把设备、物料、环境三个数据织起来,找得到问题,赚回钱了再慢慢扩,完全没问题。对吧,饭要一口一口吃,哪有一口吃成胖子的。
2024年最新工业数据编织落地踩坑总结
相关推荐
-
晒晒太阳就能发电?光伏这玩意儿藏着不少惊喜
提到发电,不少人第一反应可能是冒着黑烟的大烟囱,或是轰隆隆转个不停的水电站。但其实现在有一种特别 “温柔” 的发电方式,就藏在我们身边的屋顶、停车场甚至手机充电宝里,它就是光伏。可能有人会觉得 “光伏” 这俩字听着挺专业,其实说白了就是靠晒太阳来生电,完全不用烧煤、不用开水,连噪音都没有,是不是很神奇? 咱们先聊聊光伏到底是咋工作的。核心秘密就藏在那些深蓝色…
-
ISO20000:构建高效服务管理体系的核心指南
ISO20000 作为国际标准化组织制定的服务管理体系标准,旨在为各类组织提供一套系统化、规范化的服务管理框架,帮助组织提升服务质量、优化服务流程并增强客户满意度。该标准并非局限于特定行业,无论是信息技术服务企业、金融机构,还是政府公共服务部门,均可通过导入 ISO20000 体系,实现服务管理的标准化与精细化。从本质而言,ISO20000 不仅是一套标准文…
-
物业那些事儿:藏在小区里的暖心日常
说起物业管理,可能很多人第一反应就是 “收物业费的”,或者偶尔家里漏水、楼下噪音时才会想起找他们。但其实啊,咱们每天在小区里的舒心生活,背后藏着物业团队不少细碎又用心的活儿。从清晨小区门口保安师傅的一句问候,到傍晚路灯准时亮起的暖光,再到周末花坛里新冒出的小雏菊,这些看似平常的瞬间,都离不开物业工作人员的默默打理。 就拿我住的小区来说吧,之前总觉得物业存在感…
-
Modbus协议:工业老炮的倔强,为什么我们还在用这个40年前的协议?
我第一次接触Modbus协议是在2003年,帮一家纺织厂接PLC。那时老板扔给我一块RS485通讯板,说:“小张,这玩意儿简单,485线一接,地址一设,波特率一对,数据就哗哗来了。” 我信了。结果三天没合眼,数据就是不动。发命令,没回应。那是我第一次领教Modbus的“简单”——简单到所有问题都得自己扛。二十年过去了,今天你随便走进一家工厂,Modbus还在…
-
工业维保服务化:从成本中心到利润增长点的转型逻辑
前阵子跟东莞做重型机床的老板喝茶,他说十年前一提到维保,头都大。纯纯的成本黑洞。自己养维保团队,淡季没事干养闲人,旺季设备炸了人手又不够,停线一天,十几万的损失就打了水漂。找第三方散修,修完就走人,再坏了找不到人,配件还卖你天价。谁受得了啊! 为什么工厂都在往工业维保服务化转 本质逻辑变了。过去维保是”坏了再修”的事后救火,现在工业维…