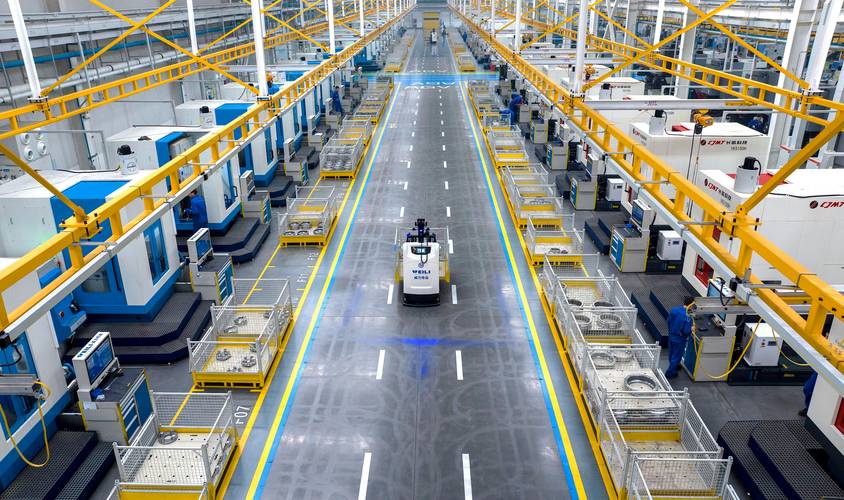
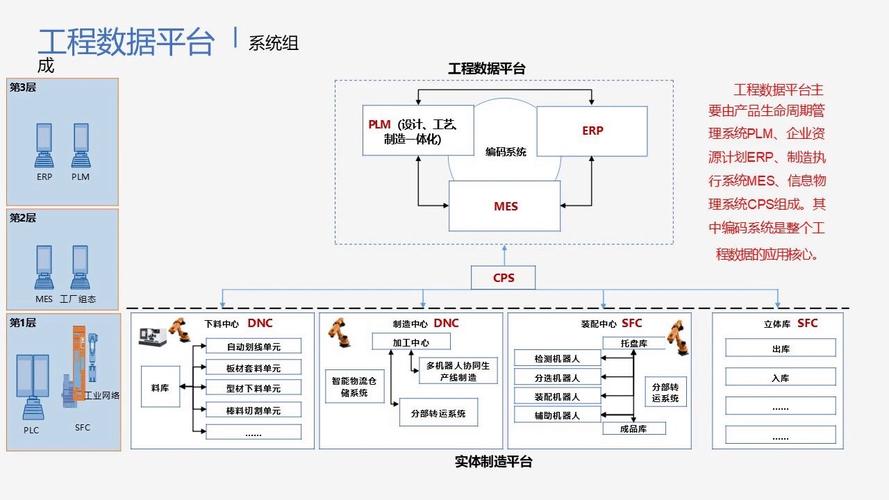
为什么现在OT数据治理突然变成刚需了?
前几年讲数字化,都是先上系统,先采数据,很少有人提治理。现在不一样了,能采的数采得差不多了,要往深用了,才发现源头全是乱的。 不同品牌的设备,协议不打通,同一个参数的命名乱七八糟,转速有的标r/min,有的写转每分钟,还有的直接只填数值不带单位。传感器受现场干扰,丢包、错采是常事,把一堆无效数据直接喂给模型,出来的结果能靠谱? 我去年接触长三角一家做发动机配件的工厂,砸了两百万上预测性维护系统,最后模型准确率不到30%,老板气得要打官司。拆开看问题,三分之一的训练数据是设备停机时候的空数据,直接混进去了,这不胡闹吗。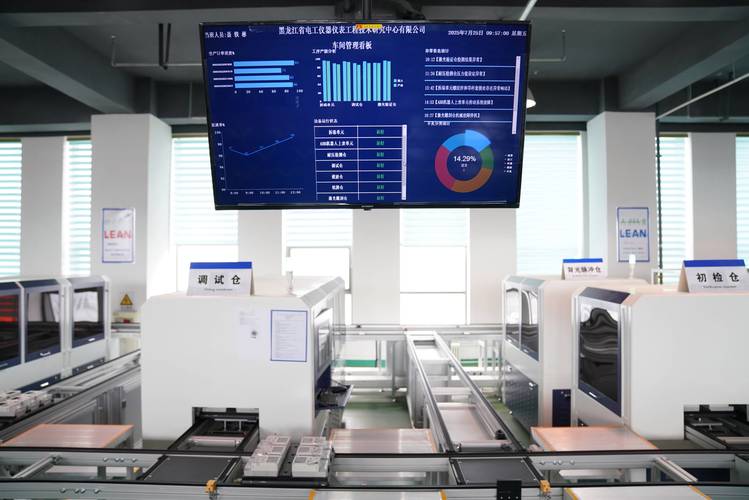
OT数据治理落地最容易踩的三个坑
我跑过上百家制造工厂,见过九成的项目栽在这几个坑里: ❗ 上来就搭大平台堆工具 很多解决方案商上来就推超大型工业数据中台,几百万砸进去,最后进场才发现,连不同品牌设备的协议都没打通,基础数据采不上来,治理个什么劲? ❗ 完全甩给IT部门,OT团队靠边站 OT数据是现场产线出来的,哪个传感器经常漂移不准,哪个工位的数据只有开机才有效,只有干了十几年的车间师傅门清。IT坐在办公室对着表格梳理,能理对才怪! ❗ 追求100%干净数据才敢用 很多项目卡半年一年动不了,就是非要把全工厂所有数据都理完才上线。工业数据哪来的100%完美?能满足当前场景用就够了,边用边迭代不比卡在原地强?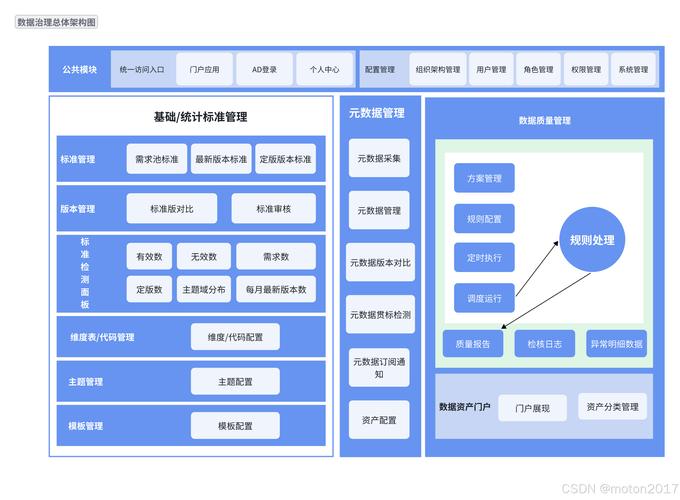
2024年OT数据治理的主流实践是什么?
说实话,这两年行业的思路变了太多,原来那套大而全的治理玩法没人玩了,现在大家都认轻量预治理,场景驱动。 💡 第一个新玩法:边缘侧预治理 不再是把所有 raw data 一股脑传到云端再洗,现在直接在车间边缘网关就把格式转换、异常数据过滤、单位对齐做完了,既省带宽,又不会把脏数据带到上层应用,成本还降了一大块。 💡 第二个新玩法:大模型辅助语义映射 原来工厂几千上万个数据点,要人工一条条梳理语义,写映射规则,一个项目光梳理就要两三个月。现在用工业大模型,自动识别不同设备的字段名称,自动匹配统一语义,准确率能到九成以上,原来三个月的活现在一周就干完了。 上个月我去珠三角一家做手机主板的电子厂看,他们三条SMT线要做焊点缺陷预测,原来数据乱七八糟,模型准确率只有62%,花了不到二十万做边缘侧OT数据治理,不到一个月,准确率直接升到91%,上线第一个月就减少了近百万的报废损失,太香了。 很多人说OT数据治理是赚服务商钱的噱头,不对。现在制造业的毛利越来越薄,你要降本、要提效,所有的决策都要靠数据,OT是工厂所有数据的源头,源头歪了,后面所有的数字化应用都是空中楼阁。 别听那些喊着要砸几百万上大项目的忽悠,小步快跑,先解决眼前的痛点,比什么都强。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:OT数据治理:制造业数字化绕不开的落地坎 https://www.dachanpin.com/a/tg/70596.html