为什么云端AI在车间根本“追不上”产线节奏
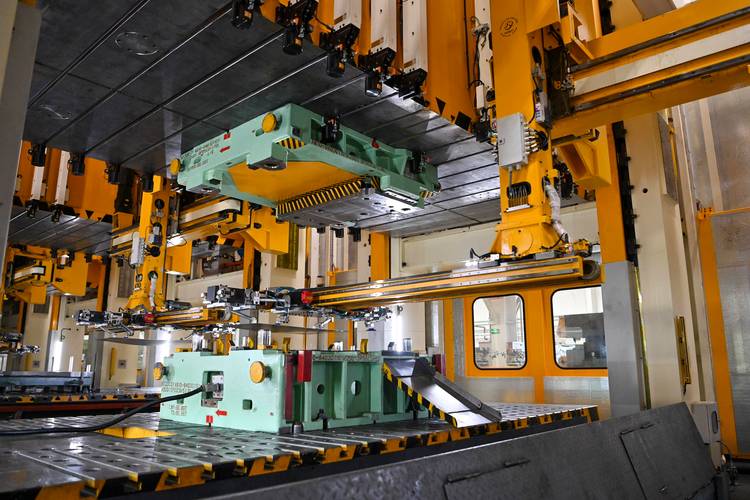
很多人对工业AI的认知还停留在“把模型训好,传到云上,车间拍个图传过去等结果就行”。 太天真了。 车间的电磁干扰、网络波动是家常便饭——上次那家零部件厂的师傅跟我吐槽,大夏天车间开着龙门铣,变频器一启动,旁边的工业网口直接断连3秒,云端的检测结果传不回来,整条线只能硬停,一次停线的损失就是大几万。 更别说响应延迟的硬伤。边缘AI推理的核心优势,从来不是厂商宣传的“省带宽”,而是把模型直接部署在离传感器、执行器几十厘米的边缘端盒子里,整个推理流程不碰公网,响应延迟能压到100毫秒以内。 就拿冲压件的裂纹检测来说,产线节拍是每秒完成一次冲压,要是检测结果晚个半秒,带裂纹的残件早就流到下一道工序了,后续的打磨、电镀工序全白做,废料率能直接飙到3%以上。 问:我们之前试过把模型塞在车间的工控机里,跑起来卡得不行,这也算边缘AI推理吗? 答:不算。 那种把通用工控机当推理服务器用的做法,本质上是“凑数的边缘计算”——工控机要同时跑MES系统、设备数据采集程序、车间看板,CPU被占得七七八八,跑个7B参数的视觉模型都要300多毫秒的延迟,遇到产线节拍快的场景根本顶不住。真正能用的工业级边缘AI推理盒子,是专门针对推理算力做了硬件加速的,哪怕跑上百路的视觉流,延迟也能稳在几十毫秒级,而且能扛住车间-10℃到60℃的温度波动、电磁干扰,不会随便死机。别盲目追大模型,车间要的是“够用就好”的小模型
说实话,这两年我见过太多厂商吹自己的边缘端能跑70B的大模型,吹得天花乱坠。 有啥用? 车间的场景根本不需要那种能写文案、能聊天的通用大模型。就拿焊缝检测、包装缺漏检测、设备振动异常识别这些固定场景来说,一个专门针对场景微调过的、参数在100M到1G之间的小模型,准确率不比大模型低,推理速度还能快好几倍。💡 这里给个真实的参考值:在工业级边缘盒子上跑一个微调过的YOLOv8n模型,单路1080P的视觉检测延迟能压到20毫秒以内,准确率能做到99.2%以上,完全覆盖绝大多数质检场景的需求。 我上次跟广东一家做食品包装的厂交流,他们之前被某厂商忽悠,花了十几万上了个能跑34B大模型的边缘盒子,结果实际用的时候发现,检测个包装袋有没有漏印生产日期,大模型的推理速度比之前的小模型慢了5倍,最后只能把模型重新蒸馏成小版本,钱全打了水漂。
别光看参数,实际落地要盯死这几个硬指标
很多人选边缘AI推理方案的时候,上来就问“这个盒子能跑多大参数的模型”。 完全搞反了重点。 ❗ 真正要盯的,是这几个跟生产强相关的指标: – 连续72小时满负载运行的稳定性:别信实验室里的测试数据,要让厂商把盒子拉到你的车间里,连续跑3天的满负载推理,看看会不会因为温度高、电磁干扰出现死机、丢包的情况。 – 推理延迟的波动值:别只看平均延迟,要看最坏情况下的延迟是多少——比如有时候因为内存占用变高,延迟突然跳到500毫秒,这种情况在快节拍的产线上是完全不能接受的。 – 后期模型更新的成本:很多边缘盒子的模型更新要返厂,或者要专门的工程师到现场导模型,一次更新就要花大半天,要是产线换了新的产品型号,检测模型要跟着改,这种高成本的方案根本没法长期用。 我去年接触过的一家做光伏组件的厂,之前选了个参数看起来很厉害的边缘推理盒子,结果夏天车间温度到55℃的时候,盒子的推理算力直接降了40%,检测延迟从100毫秒跳到了600多毫秒,最后只能给盒子单独装个小空调,额外花了两万多的改造费,说起来都是坑。 不过话说回来,边缘AI推理真的是这两年工业数字化里少有的、能实实在在算清投入产出比的技术。之前那家苏州的汽车零部件厂,把云端质检换成边缘端推理之后,漏检率从1.2%降到了0.05%,一次停线的时间从平均40分钟降到了2分钟,算下来半年就把之前投的钱收回来了。 别被那些飘在天上的概念忽悠了。 车间里的技术,永远是能解决实际问题的,才是好技术。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:车间现场的边缘AI推理:别被厂商的宣传PPT骗了 https://www.dachanpin.com/a/tg/71787.html