上周去江浙某汽配厂蹲现场,刚进门就撞见维修班班长蹲在离心风机旁边骂娘。
上周刚换的轴承。
跑了72小时,又晃得跟筛糠似的。
他说之前靠巡检员用测振仪每周测一次,等发现振动超标的时候,轴承滚道已经磨出了深浅不一的坑,拆下来换的时候,连轴上的配合面都被磨出了划痕,本来能撑3年的部件,硬生生半年就废了。
状态监测(CMS)根本不是装几个传感器就完事的面子工程
说实话我见太多了。
预算批了大几十万,传感器贴得满设备都是,后台系统装在中控室的角落,落的灰比屏幕上的波形线还厚。很多厂上CMS的初衷就错了——觉得这是要给客户审厂看的”数字化成果”,根本没想着要真的靠它降本。
真的CMS从来不是要你把所有振动、温度、转速数据全导到云里炫技,是要在故障萌芽的前3-7天,给你递个能落地的提醒,别等设备抱死停线。

刚聊到这,旁边凑过来个管设备的年轻工程师问了个问题:
问:我们厂小,总共20多台关键设备,真的有必要上全套状态监测(CMS)吗?
答:完全没必要上来就搞全量覆盖。先把单台每停1小时损失超5万的设备挑出来——比如空压机、主生产线的传送带驱动电机、给水泵,先在这些设备上装最基础的振动、温度采集单元,跑3个月攒够基线数据,比你一上来就给所有螺丝装传感器划算10倍。
现在行业里真能用的状态监测(CMS),早不是十年前那套离线抄表的老路子了
十年前的CMS是什么样?巡检员拿着手持测振仪,挨个设备测数值,抄在纸质本子上,月底再把数据录进Excel表,有没有异常全靠老师傅的经验判断。
现在呢?
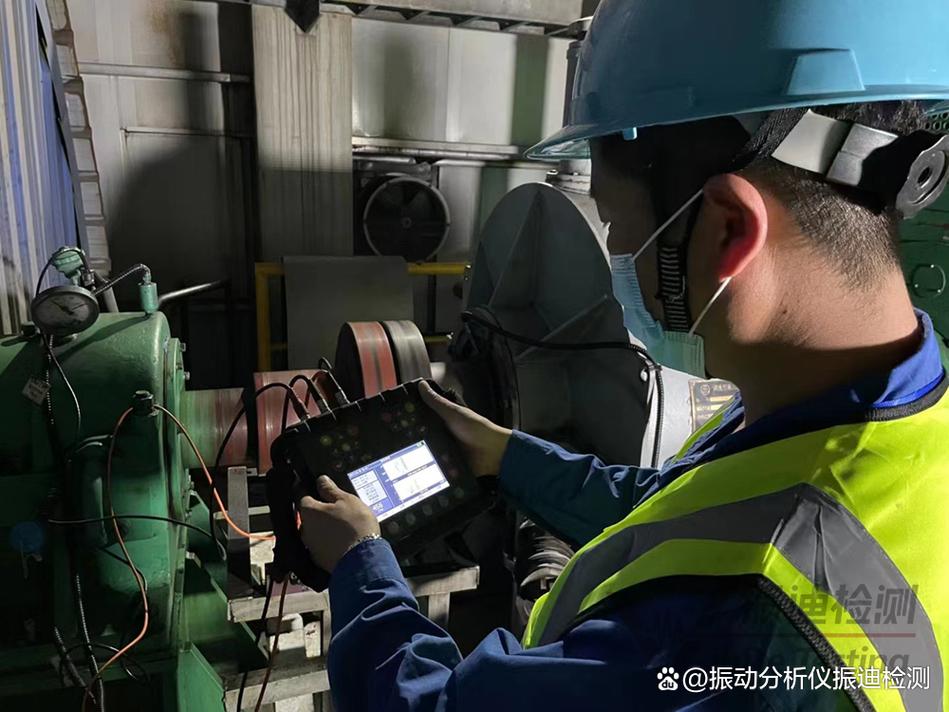
边缘计算网关就装在设备旁边的电控柜里,不用把所有原始数据都传到云端,就在本地跑阈值判断,异常了直接推微信给维修班的人,不用等中控室的人盯着屏幕24小时熬。去年在某钢铁厂见的方案,连巡检人员的防爆手机都能当采集端,走到设备旁边扫个码,10秒就能测完振动值,系统自动跟历史基线比对,偏差超了直接弹提醒。
❗ 别信销售跟你吹的”AI预测精度99%”,纯纯扯淡。
所有的预测模型,前提是你得有至少6个月的同工况运行数据当基线,没有基线的话,再好的算法也是瞎蒙。比如你夏天测的振动值,跟冬天低温下的数值本来就差不少,你拿固定阈值卡,没几天就给你误报一堆,最后维修班直接把报警推送关了,系统彻底成摆设。
上次在行业沙龙上,还有个做食品加工的老板追着问:
问:我们之前试过装CMS,误报太多,维修班嫌麻烦都不用,这问题咋解决?
答:两个办法。第一,别上来就搞绝对阈值,先跑1个月的”静默学习期”——系统只采集数据,不发报警,把不同工况、不同环境下的正常波动范围摸清楚,再设动态阈值。第二,报警分级。不是一有异常就打满电话给所有人,轻微异常推个企业微信消息,中等异常发个短信,严重到快影响生产了再打语音电话。我见过最离谱的方案,轴承温度涨了0.2摄氏度就给设备主任打越洋电话,人家在开董事会呢,能不烦吗?
真正能帮你省钱的状态监测(CMS),核心是要跟维修流程绑死
我见过太多厂的CMS,装完就成了独立的”数据孤岛”。系统弹了报警,没人派单,没人跟踪,最后数据攒了一堆,故障还是照样出。
某新能源电池厂之前就踩过这个坑。最早上CMS的时候,只装了传感器和数据大屏,结果跑了3个月,报警弹了170多条,实际跟进处理的不到20条,维修班还是按原来的”坏了再修”的节奏干活。后来他们调整了方案,直接把CMS系统跟自己的工单系统打通:系统检测到轴承振动值超了动态阈值,自动生成维修工单,推给对应的维修班班长,要求24小时内安排点检,处理完了还要把换下来的零件数据、实际故障原因填回系统,模型慢慢迭代得越来越准。
跑了1年,光主电机轴承这一项的维修成本就降了62%,停线时间少了近400小时。
💡 很多人算CMS的ROI的时候,只算买传感器和系统的钱,不算因为提前发现故障省下来的停线损失、维修加班成本、备件库存积压的钱——我见过最夸张的,某化工企业因为提前3天发现了泵的密封件磨损,避免了一次有毒介质泄漏,光这一次的风险规避价值,就抵得上他们3年的CMS运维成本。
不过话说回来,也别把CMS神化。
它不是万能的。你设备本身安装就不对,基础沉降都快5毫米了,你装再多传感器也没用,该晃还是晃。它本质上是给你的设备运维装了个24小时不眨眼的哨兵,不是替你把设备修好的魔法棒。
你要是在车间里见过那种因为轴承抱死导致整条线停转,维修班一群人满头大汗拆设备,生产主任在旁边盯着计时器算损失的场景,就知道这东西到底值多少钱。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:别再等设备炸了才修:制造业现场的状态监测(CMS)落地避坑指南 https://www.dachanpin.com/a/tg/72520.html