不是把数据凑到云端的老套玩法
之前的工业AI项目,逻辑其实特别简单:把各个厂区、车间、合作供应商的原始数据全传到统一的云服务器,集中清洗、训练模型,再把训练好的模型下发到各个生产端。 风险呢? 2023年长三角那家光伏支架厂的事,圈子里都传开了。就是因为把镀锌工艺的核心参数传到第三方云平台做防腐模型训练,数据被合作的设备供应商拷走,半年时间丢了三个年订单额超千万的核心客户。 工业联邦学习的核心逻辑,从根上就和这套老玩法不一样。数据不动,模型动。 每个生产节点的原始数据,永远存在本地的物理服务器里,绝不外传。本地先跑一个基础的小模型,只把加密后的模型梯度参数——注意,是不带任何具体工艺数值的抽象参数——传到联合训练的公共节点,所有参与方的参数凑在一起,迭代出准确率更高的通用模型,再下发回各个本地节点。 谁都拿不到谁的原始数据。
落地最先要啃的3个硬骨头,和技术关系都不大
别被服务商的PPT唬住。工业联邦学习从来不是买套软件就能跑通的事,我们跑了十几个项目,踩的坑80%都和技术没关系。 – 别上来就砸钱买高端GPU集群。很多企业一听说要搞联合训练,第一反应就是扩容本地机房,其实根本没必要。工业场景的训练数据,不是互联网平台那种几亿条的用户行为日志,单厂的原始数据量撑死也就几个TB,用厂里现有的MES配套服务器,加个轻量化的联邦学习节点就行。去年给苏州那家零部件厂做部署,总共花了不到8万,比他们之前买的传统数据脱敏系统还便宜。 – 参与联合训练的伙伴,得先把利益规则谈死。💡 别等模型跑出来有收益了再扯皮。之前碰到过一个钢厂和装备厂的联合项目,刚开始谈得好好的,等模型跑出来把成材率提了2.1%,装备厂想把模型打包卖给其他钢厂,钢厂直接把本地训练节点关了,项目直接黄了。从启动第一天就得把权责写进协议:模型的使用权归谁,收益怎么分,能不能对外复用,全说清楚。 – 别追求一步到位的全流程大模型。很多企业一上来就要把整个车间的设备数据全接进去,搞个覆盖全生产流程的工业大模型。光数据清洗就能耗你半年。先从最痛的小切口切入:就做冲压环节的模具寿命预测,就做焊接环节的缺陷检测,跑通了再慢慢扩范围。我们见过最离谱的项目,启动会开了三次,要把全厂200多台设备的全量数据全接进联邦节点,最后光梳理数据权限就搞了8个月,啥模型都没练出来。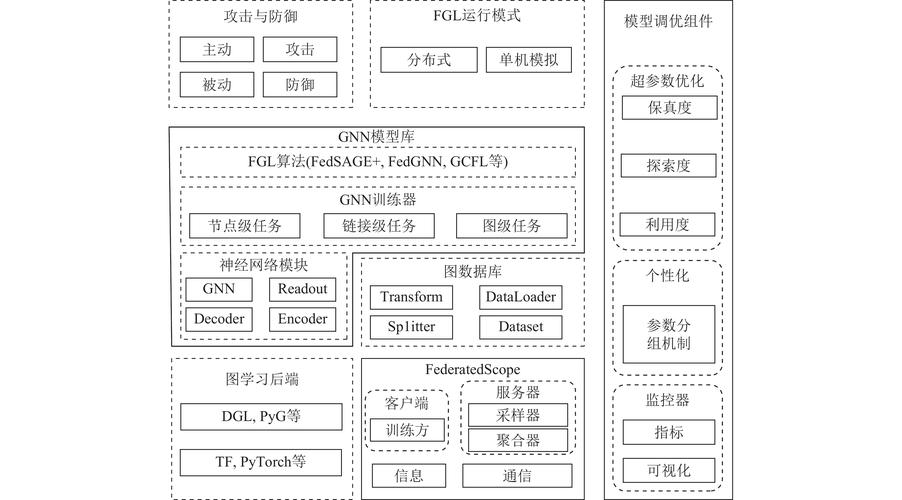
最容易踩的冤坑,给准备上车的企业提个醒
❗ 说个真事。去年有个做注塑的企业,被销售忽悠着花了大几十万上了套所谓的“工业联邦学习平台”,结果拉回来一测,本质就是个把数据集中传到云端的老系统,换了个科技概念包装。 为啥会踩这个坑? 因为很多采购根本分不清真正的工业联邦学习和套壳产品的区别。有个最简单的判断标准:如果你的服务商要求你把生产数据全导出、上传到他们的云平台才能开始训练,不管他把概念吹得有多玄,全是骗钱的。 其实做工业落地这么多年,我最烦的就是把新技术吹得像万能解药。工业联邦学习不是什么能直接让你良率翻倍的神药,它本质就是给那些被数据安全卡了脖子的制造企业,开了个不用掏家底就能用AI的口子。 别被概念唬住。 那些在行业峰会上把加密算法讲得天花乱坠的销售,大概率连自己对接的工厂用的什么型号的冲压传感器都没见过。真正好用的方案,从来都是从车间的真实痛点长出来的,不是从PPT里抄出来的。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业联邦学习:制造企业不用掏核心工艺数据也能练出好用的AI模型 https://www.dachanpin.com/a/tg/72567.html