凌晨两点,值班电话跟催命一样响。
某石化重整装置的DCS画面上,三个控制回路同时跳出坏值——红框闪烁,报警声此起彼伏。操作工一口咬定:我什么都没动。
赶过去,查了四十分钟。结果呢?不是控制器,不是网络,是现场一台Modbus RTU网关的24V开关电源被换成了便宜货,纹波大,通信时断时续。DCS本体干干净净,一点毛病没有。
可操作工不信这个。他只认屏幕上那个红框。
这就是分布式控制系统(DCS)最有意思的地方——它明明是个系统,可所有人的目光,永远只落在自己看得见的那一小块。

冗余做得再漂亮,也怕这三点
经常有人问我:我买了两套CPU、两套电源、双网、双背板,怎么还会停?
想得太简单了。
第一,共因失效。两块CPU插在同一块机架背板上,背板一挂,两个一起死。你说这是冗余吗?是。可冗余的是“通道”,不是“故障源”。真正的容错设计,得从供电、接地、甚至安装位置去拆独立性。
第二,切换根本没测过。
验收时做冷启动测试,一切正常。在线拔一块CPU试试?很多项目根本不敢做。冗余切换时间厂家标称小于50毫秒——注意,是标称。实际工程里,切换之后的I/O数据一致性和阀门输出保持,往往才是要命的地方。
第三,I/O卡件不冗余。控制器双机热备了,AI卡还是单块。一个热电偶通道烧掉,对应的串级回路直接开环。这类事故我见过至少三起。
顺便说一句,IEC 61508和IEC 61511给的是功能安全的框架,SIL等级是回路的属性,不是设备的属性。买一台SIL3认证的控制器,不代表你的联锁回路就有SIL3。这中间隔着传感器、执行机构、接线、电源,还有软件组态。
组态:七分在前,三分在调
干了这么多年,我一直觉得DCS工程最耗人的环节不是逻辑,是命名。
点表。位号。工位号。回路号。报警描述。多少个项目,开车前一星期还在改点名,改完点名再改画面,改完画面再改趋势分组和报警分组……没完没了。
你可能会说,那不就是一个字符串吗?
呵。你去现场对着操作工念一遍你组态里那些“TI-1023A_1_备用”试试,看他找不找得到。
好的位号规范,是开车效率的一半。我的建议是:设备代号—功能代号—序号—冗余后缀,四段式,别自由发挥。功能块名和位号保持一对一映射,画面标签、报警文本、趋势名全部从同一个数据源生成。别手工填两遍,一定会不一致,一定。
至于功能块本身,PID、SEL、RS、DT、SUM,这些是基本功。真正区分工程质量的,是顺控(SFC)和联锁逻辑的边界处理:故障时阀门是保位、归零,还是复位?跳车之后能不能自动复位?复位后的启动条件是什么?这些东西写在逻辑里,比写在文档里重要得多。文档没人看,代码会执行。
问:DCS和PLC到底怎么选?中小项目是不是用PLC更划算?
答:看三个维度——规模、回路类型、生命周期。I/O点少于500、以离散逻辑为主、工艺基本不变,PLC加SCADA确实便宜。但只要有较多连续调节回路、需要复杂顺控、有几十个操作站、而且未来还要改造扩产,DCS的工程效率、报警管理、历史数据和扩展成本反而更低。别只算硬件报价,要算全生命周期成本——这话说了十几年,还是有人不算。

网络:环路、风暴,和说不清的时延
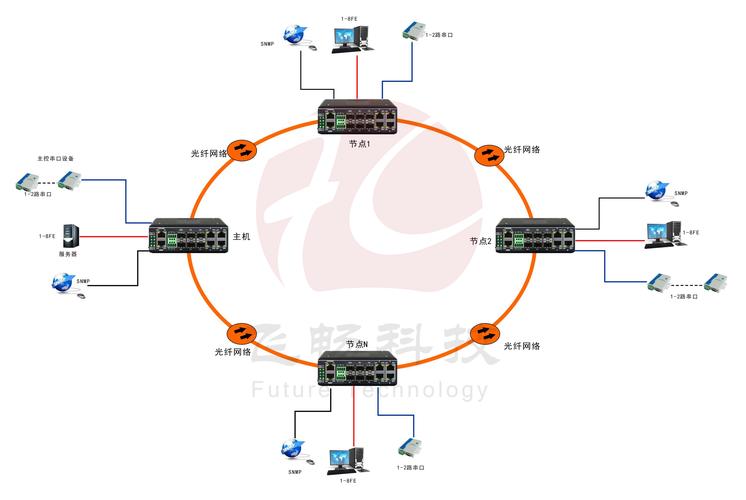
工业以太网是DCS的血管。可血管也会堵。
最常见的三个坑:
- 环网冗余协议没开,或者开错模式。管理型交换机买了,RSTP没配;或者明明是双环却接成单环。等真断了一条链路,才发现切不过去。
- 广播风暴。有人把办公网笔记本直接插进控制网,一个IP冲突或者组播泛洪,整段网哗地一下就没了。
- 时延抖动。平均时延看着没问题,峰值一高,控制器之间的对等通信数据就过期了。周期性数据讲究的是确定性,不是平均值。这点上,现场总线时代的教训到今天还管用。
现在的新装置,OPC UA越来越普及。这是好事,也带来新麻烦:IT侧的人想直接从DCS拿数据做分析,怎么隔离?
我个人的做法是用单向网关,或者在DMZ里放一台OPC UA服务器做转发。IEC 62443的分区与管道模型不是什么学术文章,是救命的东西。控制网和生产网之间,物理或逻辑上的隔离必须硬。
老装置改造:别把DCS当成一台旧电脑换掉
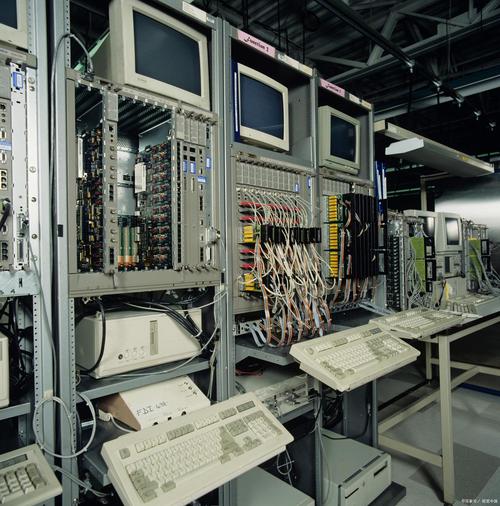
这两年听得最多的问题是:“我这套DCS用了十五年,还能撑几年?”
我的回答一般分两种。
如果备件还能买到、厂家还支持、系统负荷低于30%、没有难以忍受的硬伤——那就先做局部升级:换操作站、升级历史库、把网络换成工业环网。花的钱可能只有整体替换的十分之一。这账很容易算。
但如果控制器的扫描周期已经开始吃紧、编程软件跑在Windows XP虚拟机里、厂家已经宣布停止服务……那就别硬扛了。迁移这事,越拖越贵。
值得提醒的是,今天的DCS跟十年前比,多了不少新东西:虚拟化操作站、APC先进控制、软测量、基于机器学习的异常预警。这些不是新闻稿里的花活,用对了能实打实把波动压下去。
问:DCS和SIS能不能合成一套?省钱又省线。
答:一般不建议。安全仪表系统(SIS)和过程控制系统(BPCS/DCS)的目标函数是相反的——一个要稳,一个要该动就动。硬凑在一起,独立性和共因失效分析都很难做干净。现在防爆、合规、审计都盯着这一点,省下的那点钱,将来可能十倍还回去。
几句掏心窝的话

- 点表在开工前定死,别怕慢。前面慢十天,后面省一个月。
- 冗余一定要实测。在线拔卡、拔网线、关电源,一样都别少。
- 报警不是越多越好。NAMUR NE107那套分类思路,值得认真琢磨一遍。一个班几百条报警,等于没有报警。
- 趋势和历史的采样周期,比画面刷新率重要得多。别为了画面好看,把历史数据做没了。
- 留一套能离线的、离线也能起来的历史备份。你永远不知道哪天厂家的老版本编辑器就不给你了。
凌晨两点那通电话,说到底跟DCS关系不大。可如果那天现场用的是带纹波监控的冗余供电,如果我们在验收时对通信链路做过压力测试……也许我就不用爬起来。
系统可靠性的天花板,从来不是那台控制器。是人,是细节,是那些没人愿意翻的文档角落。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:分布式控制系统(DCS)那些事:一个老工控人的现场笔记与踩坑清单 https://www.dachanpin.com/a/tg/72826.html