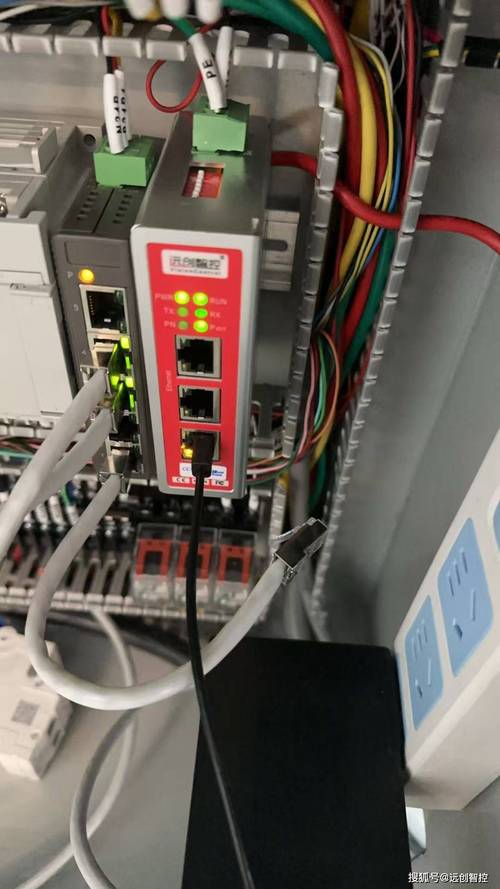
上个月在苏州一家做汽车连接器的厂子里蹲了两天。产线节拍180毫秒,客户买了台Jetson Orin NX的盒子,跑YOLOv8s,实测单帧推理45毫秒。纸面算下来绰绰有余。结果那条线每小时还是有七八次漏检。
查到最后,压根不是模型的事。触发信号抖动,相机曝光同步没做好,十几毫秒的偏差直接把整个时间预算吃光了。
这就是边缘AI推理在工业现场最真实的样子。它从来不是一个纯算法问题。算法大概占三成,剩下七成是时序、散热、供电、振动、粉尘,还有现场师傅那句「你们这个盒子怎么又红了」。
为什么非得把算力搬到设备旁边
有人问,厂里不是有机房吗?服务器不香吗?
香。但不合适。
一条高速冲压线,节拍0.2秒。图像从工业相机出来,走千兆网到机房,排队、解析、推理、结果回传,再到PLC动作。中间多一跳,就多一次不确定性。交换机在跑备份,旁边设备在传日志,都会让延迟抖起来。
工业场景最怕的不是平均延迟高。最怕的是尾延迟。999次都是20毫秒,第1000次给你来个300毫秒,这条线就直接报警停机了。这种事故来一次,客户对你的信任就归零。
还有带宽这笔账。8台2000万像素相机,25帧,原图直传,自己算算要多少。10G网都吃紧。边缘侧先做一遍推理,只把缺陷图和结构化结果传回去,几百KB的事。
数据合规也是个大头。有些客户的工艺参数属于核心机密,图像根本不让出厂区,云端方案直接判死刑。
算力不是越大越好
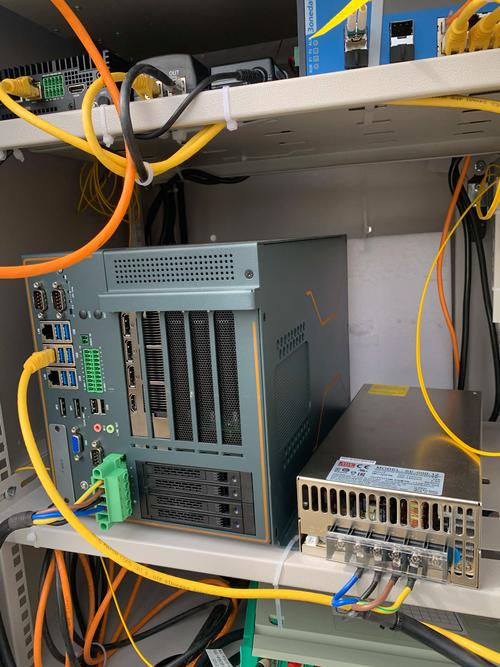
这话可能有人不爱听。但我见过太多项目,一开始就想上A100,结果盒子塞不进电柜,功耗烧掉300瓦,还得给它配空调。
工业边缘AI推理的硬件账,得这么算:
- 有效算力,不是标称的TOPS。一块标称100 TOPS的芯片,如果跑的是它不擅长的算子,实际吞吐可能只剩20 TOPS的水平。
- 功耗与散热边界。无风扇方案通常卡在15到25瓦。超过这个数就得上风扇,而风扇在粉尘环境里就是消耗品。你们运维换得起吗?
- 宽温。电柜里夏天55度很正常,北方车间冬天零下10度开机。消费级芯片撑不住。
- 接口。GigE Vision、USB3、Camera Link,还有跟PLC通讯的Modbus TCP、Profinet、EtherCAT。缺一个就得加转换器,加一个就多一个故障点。
目前工业现场走得比较多的几条路线:英伟达Jetson Orin系列,生态最全,TensorRT优化到位,代价是价格和供货周期;瑞芯微RK3588,性价比高,NPU 6TOPS,适合中小模型;Hailo-8这类专用加速器,功耗低得离谱,但算子支持限制比较死;Intel核显加OpenVINO,适合已经有x86平台的厂子平顺迁移。
没有最优解。只有跟你这条产线节拍匹配的解。
问:我们产线节拍只有150毫秒,边缘AI推理真的来得及吗?
答:来得及,但前提是别把整张2000万像素的原图直接喂给大模型。常规做法是先做ROI裁剪,把感兴趣区域压到640甚至320,再上模型。第二种是级联——小模型快速筛一遍,只把可疑区域交给大模型复核。第三种是算子层面的加速,用TensorRT或者OpenVINO把后处理也图化,能省下十几毫秒。另外提醒一句,别只盯mAP,工业上真正要盯的是过杀率和漏检率,这两个指标跟你的阈值策略强相关,阈值挪0.05,结果可能就完全不一样。
模型量化,做得糙就是给自己埋雷
FP32转INT8,精度掉1到2个点,听起来没什么。
放到产线上就是灾难。
我们做过一个表面缺陷检测的项目。量化前漏检率0.3%,量化后变成1.1%。看着只差0.8个百分点。按每天5万件算,一天多漏400件。客户当场退货。
问题出在哪?校准集。很多人随手从训练集里抽500张图就去做PTQ校准,这基本等于赌博。校准集必须覆盖你现场所有的工况。不同批次、不同光照、不同反光角度、甚至相机镜头脏了之后的成像。这些都得有。
实在不行的,上QAT,量化感知训练。麻烦,要重训,周期长,但精度守得住。有些项目我们甚至做了逐层敏感度分析,把最敏感的那两三层保留FP16,其余全INT8,精度和速度都拿到了。
还有一件事必须做:数据回流和难例挖掘。模型上线不是终点。现场误报的图、漏检的图,要有机制自动回传,当然得脱敏。每个月拿回来重新标注、微调、再验证。工厂的工艺会变,来料会变,你的模型不变,那就是在等它慢慢失效。
现场运维才是真正的泥潭
算法工程师最喜欢待在实验室里调指标。真正的战场在车间。
我列几个最常见、也最容易被忽略的坑:
- 散热降频。电柜里50多度,盒子表面烫手,SoC一过85度就降频,推理延迟从30毫秒涨到90毫秒。你监控的是算法,掉的是算力。所以边缘盒子的温度要有独立看门狗,超温提前报警,别等产线停了才发现。
- 存储写爆。日志、缓存图、崩溃dump,几个月就能把eMMC写满。写满之后有些系统不会优雅报错,而是直接崩。做好日志轮转,图片缓存设上限。
- 断电恢复。车间跳闸是常事。设备重新上电后,推理服务能不能自启?模型版本有没有回滚机制?这些要在部署前就演练一遍,别等出事了现学。
- 模型版本管理。现场跑的是v3还是v5?上周远程推的那版到底生效没有?没有版本号和A/B机制,出了问题就是一笔糊涂账。
- 时钟同步。这个听起来很无聊,但多相机场景下时间戳对不齐,你连是哪一帧出的问题都查不出来。PTP或者硬件触发,该上就上。
问:边缘盒子跑了大半年开始掉帧、卡顿,重启就好,过几天又犯,是什么原因?
答:九成出在三个地方。第一是散热,散热片被粉尘糊住,或者风扇轴承磨损转速下降,SoC长期在高温区降频运行。第二是存储,日志或者缓存把eMMC写到接近满,文件系统性能断崖式下跌。第三是内存泄漏,用Python写的长驻推理进程尤其容易出这个问题,跑几十万次之后内存曲线只涨不跌。排查顺序建议先看温度曲线,再看磁盘占用,最后抓进程的内存快照。说实话,很多时候换个散热风扇加个日志轮转脚本,问题就没了,跟模型一点关系都没有。
给准备上车的朋友几句实在话
第一,先在现场用真实数据跑一遍demo,但别信demo。Demo用的是精挑细选的样本,产线用的是连续24小时的随机输入。让供应商把设备放到你线上,连续跑一周,把误报率、漏检率、延迟P99全部记录下来。
第二,把网络时序这件事提到跟模型同等重要的位置。找个懂电气的人,一起把触发链路图画出来,每一段延迟都标上数。这比多训一个epoch有用得多。
第三,给运维留接口。再好的边缘AI推理系统也会坏,会漂移,会被粉尘打败。能不能远程看状态、远程换模型、远程重启,决定了你未来三年的售后成本。
第四,算总账。芯片贵一点没关系,如果它省掉了一个风扇、一次停机、一个驻场工程师。工业这行,便宜的东西往往最贵。
最后补一句。边缘AI推理不是什么颠覆性的魔法,它更像给产线装了一双不知疲倦的眼睛。眼睛本身不贵,真正贵的是让这双眼睛在油污、震动和40度高温里持续睁开的能力。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:边缘AI推理落地工业产线:一场关于30毫秒、散热和误报率的硬仗 https://www.dachanpin.com/a/tg/72952.html