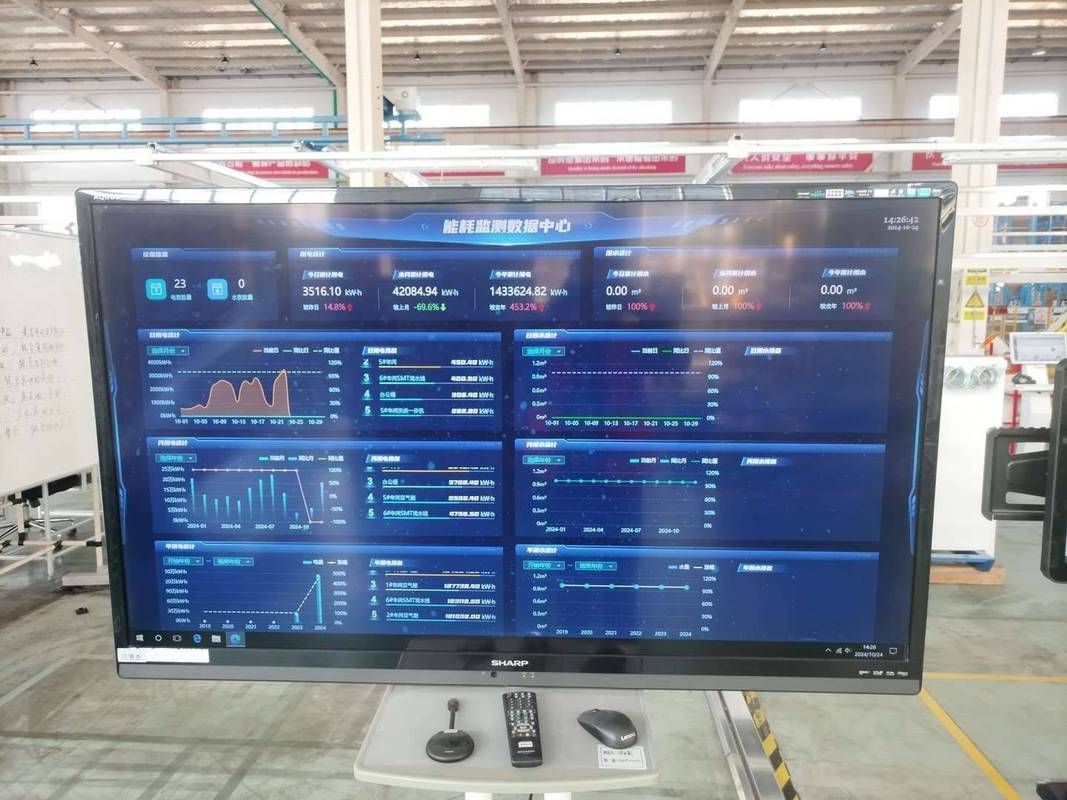
我前两个月刚去珠三角一家做新能源结构件的工厂跑现场,老板拉着我看他机房里堆着的三套数据采集系统,眉头皱得能夹死蚊子。花了快两百万上的传感器,采了大半年数据,除了能在大屏上跳数字,啥用没有——等到系统算出设备异常,刀具已经废了三四个,一整批工件都废了。问题出在哪?不是传感器不好,是他们用了老一套的批处理逻辑,根本扛不住工业现场每秒几十上百条的增量数据。
传统批处理的逻辑很简单:把一段时间的数据攒起来,存在硬盘或者数据库里,攒够了统一计算。放在十年前,工厂采样频率几分钟一次,这么玩没问题。现在呢?高端机床的主轴振动、温度采样都是毫秒级,锂电产线的辊压数据每秒钟要采几十次,你攒十分钟再算,黄花菜都凉了。
流式数据处理的逻辑刚好反过来:数据一条一条来,来一条就算一条,有异常毫秒级就能触发报警。就像你开车的时候盯着实时转速表,不对就立刻踩刹车,而不是开到目的地再算刚才有没有超速。
问:我们工厂传感器采样率只有1分钟一次,还用得着流式数据处理吗?
答:说实话,要看你怕不怕出事儿。如果是后段包装、码垛这种低风险工位,延迟十几分钟出结果也不影响,那确实没必要折腾。但如果是主轴、辊轮、汽轮机这种核心关键设备,哪怕延迟5分钟,都有可能出重大安全事故或者批量报废。我刚说的那家珠三角新能源工厂,之前就是吃了这个亏,原来批处理10分钟更新一次异常,有一次主轴密封漏了温度上涨,8分钟后才报警,直接废了三根进口刀具,还有120多件成品,损失超过二十万。换了流式数据处理之后,温度偏离阈值3秒就推送报警给工人,去年到现在没出过一次同类事故。
问:流式数据处理是不是部署和运维成本都很高,中小厂玩不起?
答:放在五年前这话没错,那时候要自己搭集群、写代码,一套下来几十万起步,中小厂确实扛不住。现在不一样了,主流工业互联网平台都有现成的流式数据处理模块,Flink这些开源框架也早就适配了工业网关,很多甚至可以按算力付费,中小厂只做核心工位的话,一个月几千块就能搞定。说白了,你只要能避免一次批量报废,成本就赚回来了,根本不亏。
不是说流式数据处理万能,我见过不下十个项目,上线就死,大部分都是踩了坑。
第一个坑❗ 数据乱序不处理,结果误报一堆。工业现场的WiFi、工业以太网经常波动,传感器数据有时候会卡个几百毫秒才发过来,如果直接按接收顺序处理,就会把后发生的数据算到前面,导致异常漏判。很多新人搭项目的时候根本不注意这个,上线之后天天误报,工人索性就关了,项目直接烂尾。
第二个坑💡 窗口大小设置不合理。流式处理要靠时间窗口聚合数据,你窗口开太大,报警延迟就高,起不到实时作用;开太小,又容易把传感器偶发的干扰脉冲当成异常,天天狼来了,谁都不信。我一般给客户做方案,关键振动监测用1秒窗口,温度监测用5秒窗口,既过滤干扰,又不会延迟太高。
第三个坑✅ 全工厂所有数据都硬上流式。很多老板觉得既然流式好,那我所有数据都走流式,其实完全没必要。比如每天的产量统计、月度的能耗分析,这种非实时数据,用传统批处理成本更低,速度也不慢。硬上流式就是白白浪费算力,多花好几倍的钱。
先跑,不要上来就搞全工厂。比如你是做机加工的,先把最贵的那台五轴主轴做了,出效果了,老板看到省钱了,再推其他工位,钱也好申请,风险也小。
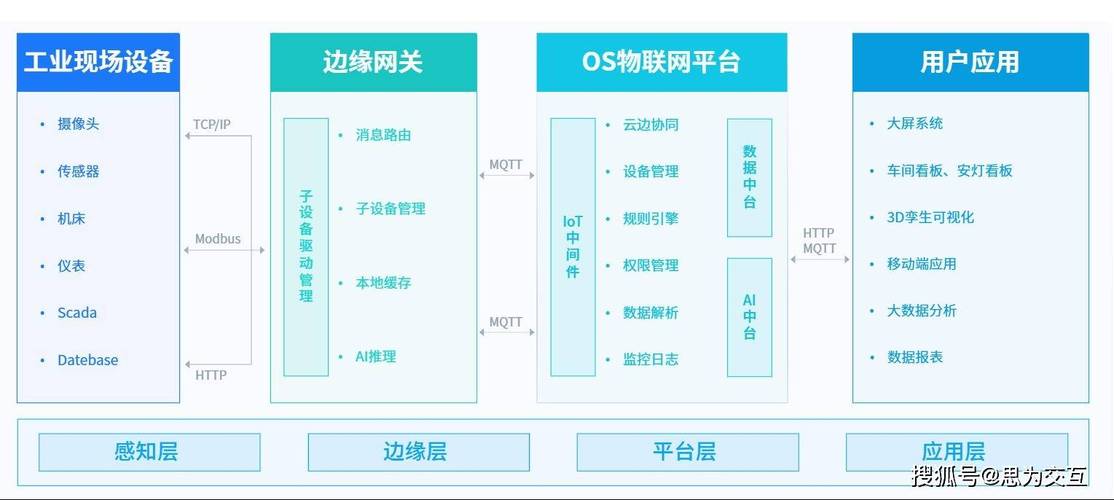
然后,选成熟的方案,不要从零造轮子。现在大部分工业网关都已经适配了主流的流式数据处理框架,像Flink现在就是工业领域的首选,生态全,工业互联网平台几乎都支持,不用自己写太多代码,改改配置就能用。
不过话说回来,千万别忘先做数据清洗。工业现场的数据太脏了,丢包、错值、干扰无处不在,不清洗直接处理,结果肯定错。现在很多流式处理模块都自带工业数据清洗规则,直接开就行,不用自己折腾。
说实话,现在很多工厂都在吹数字化,我觉得最实在的数字化,就是能帮你少亏钱,多赚钱。流式数据处理不是什么放在展厅里的黑科技,就是给你的设备装了个实时的听诊器,哪里不对立刻说,帮你把本来要亏的钱,稳稳装进自己口袋。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业预测性维护中的流式数据处理:帮工厂把浪费的钱赚回来 https://www.dachanpin.com/a/tg/69841.html