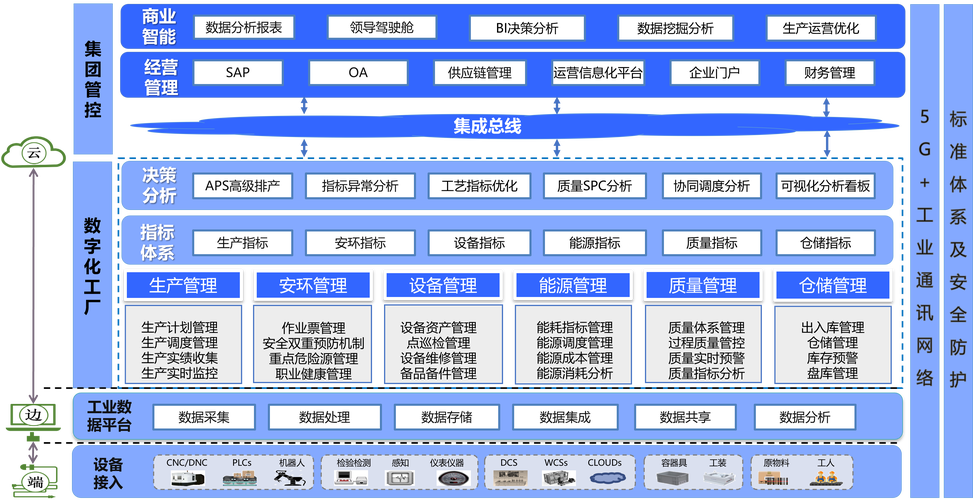
跑过二十多家长三角离散制造工厂,过半都卡在同一个地方。
上了五六年数字化,买了ERP、MES、SCADA,每个系统都解决了一部分问题,合在一起用就乱套。
生产部要周报,得找IT导MES数据,找供应链导ERP库存,找质量部导QCS良率,三个表三个口径,对到深夜还对不齐。
这不是管理的问题,是数据被锁在一个个孤岛上,连不起来。
问:很多工厂已经建了数据中台,为什么还需要工业数据编织?
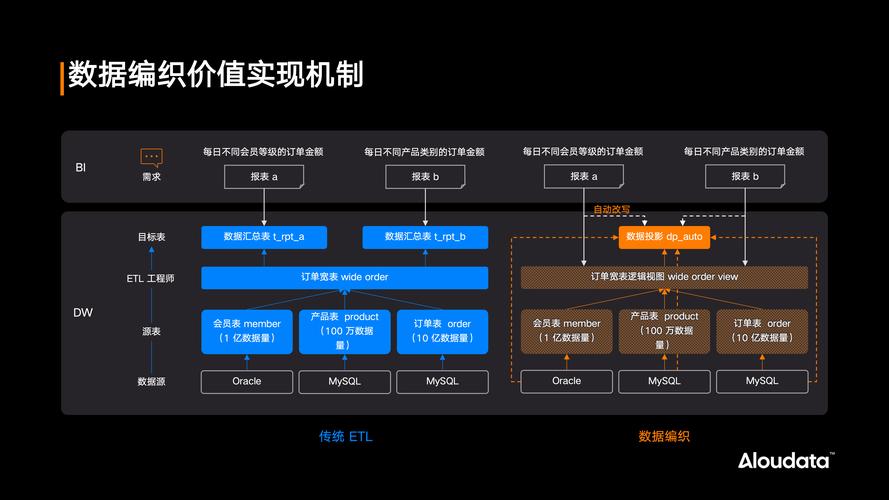
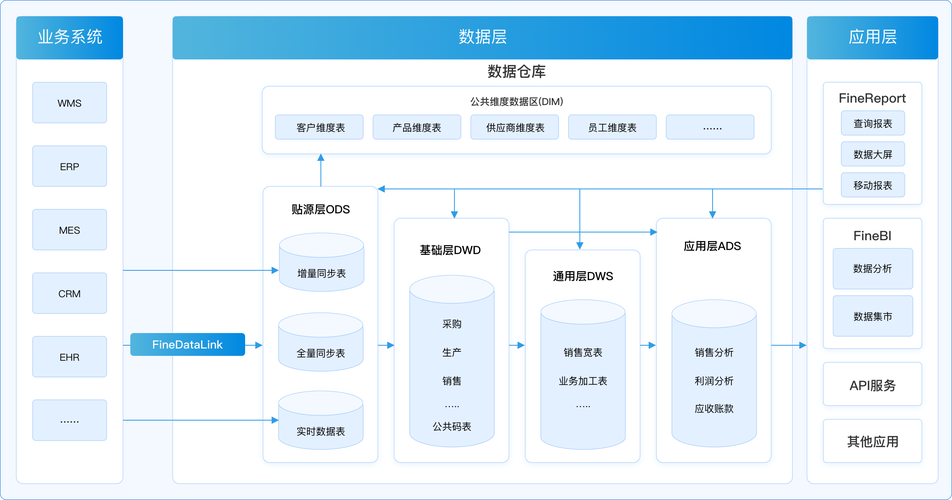
答:数据中台本质是建一个统一的“大水库”,要把各个孤岛里的数据全抽出来,清洗、转换、再统一存储,相当于推倒重来。周期长,投入高,还得动原来的业务系统,不少中小厂折腾不起,大工厂旧系统停不掉,也难落地。工业数据编织不一样,它是给各个孤岛织一张动态连接网,不用迁移原有数据,不用替换现有系统,只需要在各个数据源之间建立动态映射,需要用哪个数据直接取,哪里不对改哪里,灵活得多。
去年接触的一家汽车零配件供应商,就是典型的新旧系统打架。2018年上的老MES,2022年换了新的质量管理系统,供应链又用的第三方SaaS平台,三个系统三个库存数,盘点一次差十几万件,发错货的情况每个月都有三五起。上工业数据编织方案,三个月就打通了三个系统的核心库存、订单数据,没有替换任何原有系统,只做了数据映射和规则校验,投入还不到之前数据中台报价的三分之一。是不是很惊喜?
问:是不是所有制造企业都适合上工业数据编织?
答:只要你有两个以上独立运行的工业业务系统,还在靠人工导表对账,就适合。尤其是已经完成基础数字化、但新旧系统打通难的老牌工厂,或者预算有限不想大动现有架构的中小制造企业,优势特别明显。要是你现在还靠手工记单记产量,那先把基础数字化做完,再来谈这个也不迟。
💡 第一个坑:上来就要全量打通。
很多企业一把手一拍板,我们要把全工厂一百多个数据源全织进去,一口气吃成胖子。结果光梳理数据口径就花了七八个月,业务部门看不到效果,慢慢就不支持了,项目最后不了了之。
正确的做法非常简单,抓最痛的那个点先做。库存不准就先打通库存数据,良率算不对就先打通生产质检数据,一个月出成果,拿到业务端的认可,再慢慢扩展,稳得多。
❗ 第二个坑:只让IT部门推进,业务部门靠边站。
这是90%工业数字化项目死掉的核心原因。
。你要的良率是按班次算还是按订单算?哪个数据源的统计口径是对的?这些问题IT根本回答不上来,必须要业务一线的人全程参与。之前成了的那个汽配厂项目,就是生产主管全程跟着对接,改了三次口径,出来的数据才符合业务要求,省了至少一半的实施时间。
⚠️ 第三个坑:把它当万能灵药。
说实话,工业数据编织能解决数据连通的问题,解决不了基础管理烂的问题。你原来车间就没人认真录数据,十个数有五个错,织完网出来的还是错数据。它不会凭空给你变出准确的数据,这点一定要拎清楚。
。
什么意思?原来车间里PLC、传感器、各个设备产生的数据,都要传到云端或者工厂总部的服务器,才能做连通处理,不仅有延迟,还得占大量的带宽,数据传出去也有安全隐患。边缘侧工业数据编织,就是把编织节点放在车间的边缘网关里,数据不用出车间,直接在本地完成连通、计算、分析,延迟能降到毫秒级,还省带宽,安全性也高。
今年初给我留下印象很深的一个案例,珠三角一家做光伏组件的头部企业,给每条产线都配了边缘工业数据编织节点。原来OEE要等数据传到云端算完再返回,要两秒多才能出结果,光伏产线一秒出一片组件,晚两秒发现异常,就多两片废片。现在本地计算,几十毫秒就出结果,发现异常立刻停线,一年下来光废品损失就省了快四百万。
不过话说回来,现在工业数据编织还是个发展中的概念,不少厂商为了卖货吹得神乎其神,把什么问题都能解决。你自己得心里有数,先搞清楚你要解决什么问题,再选方案,别被概念割了韭菜。
比起那些动辄千万、半年起的大项目,这种低侵入、快见效、不折腾现有业务的方案,才真的适合大部分还在数字化深水区摸索的制造企业,不是吗?
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业数据编织:打破制造企业数据孤岛的轻量解法 https://www.dachanpin.com/a/tg/69837.html