为什么普通数据库搞不定工业数据?
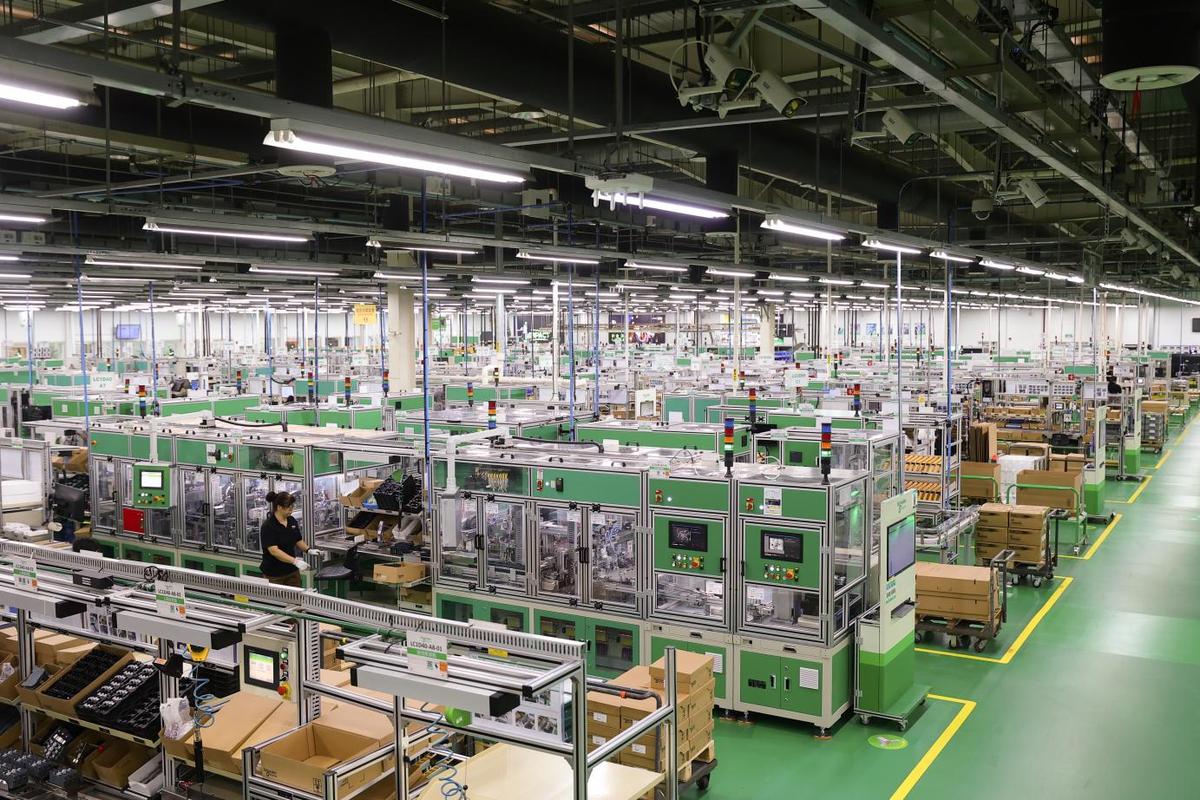
工业数据的特性,天生和普通业务数据不一样。 普通互联网业务,存个订单、用户信息,一天新增几万条顶天了,还经常要删改、查单条数据。 工业数据呢? 一个中型冲压车间,10台设备,每台设备带100个传感器,每个传感器每秒采样1次,一天就是864万条数据。而且这些数据一旦写进去,几乎不会改,只会不停新增。你要查的,永远是某段时间内某个参数的变化曲线,要做聚合、要做趋势分析。 普通MySQL、Oracle,按这个量级写半年,你查个一周的曲线,能等你十分钟。 这谁受得了?停线就是亏钱。
工业时序数据库选型的那些坑
说实话,现在市面上做工业时序数据库的一抓一大把,坑真不少。 ✅ 能跑通测试不代表能扛住现场。很多开源产品,测的时候写入吞吐量很好,一到现场,几百个传感器同时丢数据过来,网络一抖就丢包,根本扛不住。 ❗ 不要盲目迷信海外品牌。最早一批做数字化的工厂,大多选了海外品牌。贵。还每年要交百分之十几的服务费。出了问题找售后,半个月才有人回邮件,国内工程师改个配置都要等总部授权,太憋屈。 💡 核心看三个指标就够: 1. 写入吞吐量:能不能支持万级传感器同时写入不丢包 2. 压缩比:同等数据量占多少存储空间,直接决定你的存储成本 3. 查询延迟:拉取一年的历史曲线能不能在秒级出来 问:中小工厂传感器不多,能不能用开源的工业时序数据库? 答:完全可以。如果你的传感器不到一百个,只是做简单的设备状态监控,找个成熟的开源版本自己搭,成本几乎为零。但如果你要做预测性维护、工艺优化,数据量又大,我还是劝你选正经的商用产品。开源的出了问题,你找得到人修吗?停线一小时损失几万几十万,够买好几年的授权了,犯不着冒这个险,对吧。
2024年工业时序数据库最新落地玩法
相关推荐
-
工业网络安全:制造企业最容易踩的几个隐形大坑
上周去珠三角顺德那边跑一个汽配厂做技术升级调研,厂长拉着我在中控室站了快一小时,烟扔了一地,一口一个脏话骂。他上个月刚贷款换了四条无人加工线,上线不到半个月,整个线的上位机全被勒索软件锁了。拖了三天才解开,赶不上主机厂的交货期,光违约金就赔了一百八十万。 别拿办公网的安全方案套工业网络安全 很多企业老板一听要做安全,直接让IT部把办公网那套防火墙杀毒软件搬去…
-
铣削加工:老师傅都容易踩的隐形精度坑与最新实践指南
干机械这行,谁没跟铣削加工打过交道?见过干了三十年的老师傅翻船,也见过刚出师两年的小伙子干出公差零超差的活。这里面的门道,真不是靠背参数就能摸透的。 为啥现在铣削加工的要求越来越卷? 放到十年前,干普通机械零件,公差能控制在两丝以内就算合格。现在呢?新能源汽车的传动零件、航空航天的结构件、消费电子的模具,公差直接卡到半丝到一丝,差0.005mm直接整批报废。…
-
电镀行业还能“活”多久?——一个老工程师的忧与喜
说实话,干电镀这行快二十年了,最近几年那种“迷茫感”越来越重。电镀,这个现代工业的“美容师”,几乎撑起了从汽车到手机所有行业的表面处理需求,可我们自己呢?订单越来越薄,环保的刀悬在脖子上,年轻人压根不愿进车间……有时候深夜值班看着挂具上亮闪闪的镀件,心里五味杂陈。 不过话说回来,我倒也不是纯悲观。折腾了这么些年,踩过坑,也看到些真出路。今天就当跟老伙计们聊聊…
-
质量功能展开(QFD):你那被车间扔掉的客户需求
上个月去一家做工业传感器的老厂,墙上贴满了“以客户为中心”。开项目会时,研发总监拍着桌子喊:客户说想要更快的响应速度,我们就加了个高速芯片,结果成本涨了 20%,客户转身选了别家。问题出在哪儿?——他们把客户的话直接当成了技术指标,中间少了一道翻译。这道翻译,就叫质量功能展开(QFD)。 第一次接触 QFD 是十年前在日本研修,带我的师傅递过来一张画满了方框…
-
跨境电商:现状、挑战与未来趋势
在当今全球化的时代,跨境电商正以前所未有的速度蓬勃发展,成为推动国际贸易增长的新引擎。随着互联网技术的不断进步和消费者购物习惯的转变,跨境电商打破了传统贸易的地域限制,为全球商家和消费者搭建了一座便捷的交易桥梁。 跨境电商,简单来说,是指分属不同关境的交易主体,通过电子商务平台达成交易、进行电子支付结算,并通过跨境物流送达商品、完成交易的一种国际商业活动。与…