为什么工业圈现在都在聊工业联邦学习?
现在几乎所有厂子都在上AI,不管是缺陷检测还是预测性维护,效果好不好全看数据量够不够、多样性足不足。
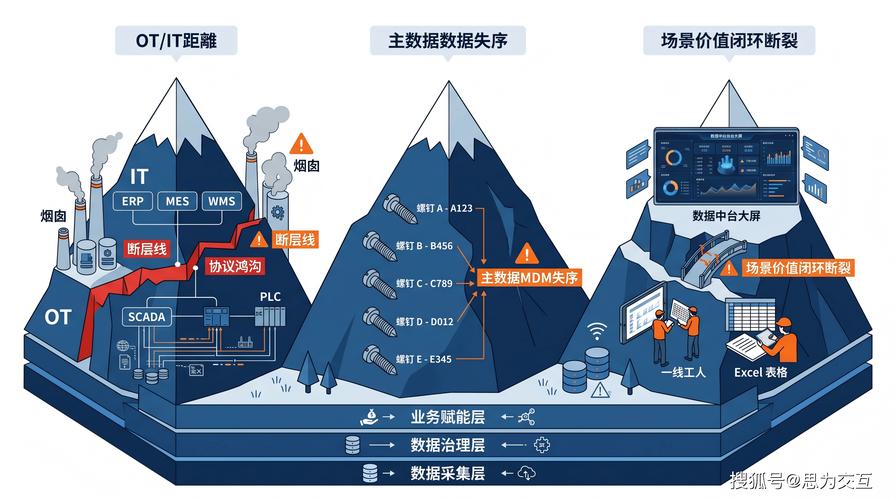
但现实是什么?同一家工厂的不同车间,数据被部门墙卡着出不了本部门。上下游不同企业,更是涉及商业隐私、数据合规,没人敢把原始数据随便给别人。之前试过数据脱敏、共享接口,试过的都知道,要么是数据可用性掉得厉害,要么就是依然有隐私泄露的风险,出过纠纷的不在少数。
工业联邦学习就是冲着这个问题来的。它让多个参与方在不出售、不转出原始数据的前提下,联合训练一个共享的AI模型,所有人都能用模型提效,没人能拿到别人的原始数据。
问:工业联邦学习和我们常听到的普通联邦学习到底有啥不一样? 答:普通联邦学习最早是互联网领域出来的,大多针对同构的用户行为数据,节点都是稳定的云端服务器。放到工业场景根本扛不住——工业数据的异构性太强了,有的传感器是秒级时序数据,有的是人工录入的表格数据,还有的是质检图像,不同工厂的标注标准都不一样。再加上海量边缘节点算力参差不齐,时不时还有断网停线的情况,普通联邦学习一跑就崩。工业联邦学习专门做了节点容错、异构数据对齐、轻量化模型拆分这些优化,就是为了适配工业场景乱七八糟的问题。说白了,它就是为工业界量身定做的数据共享方案。
工业联邦学习落地踩过的那些坑
现在概念火了,一堆人上来就说要all in,我见过太多踩大坑的项目了。
第一个坑,节点通信适配难。不同工厂用的设备品牌不一样,通信协议五花八门,很多老工厂的设备连以太网都没接全,跨厂模型参数传输都搞不定,更别说聚合更新了。第二个坑,小样本聚合效果差。很多细分特种工艺,本来每个厂的数据就没多少,就算聚合起来,样本量还是不够,模型准确率提升还不够覆盖投入成本,我之前接触的长三角那个汽配厂项目,一开始就栽在这,联合三家做缺陷检测,准确率只涨了3个百分点,投入了几十万,根本收不回来。
问:那工业联邦学习落地,最容易被忽略的关键是什么? 答:绝大多数团队上来就奔着跨企业联合去了,完全没想到先做工厂内部试点。很多人不知道,多数工厂内部的跨车间、跨部门数据墙,比跨企业的还厚。先在工厂内部不同车间之间跑通工业联邦学习,验证效果,磨通流程,再往外扩展到上下游,成功率能提至少一倍!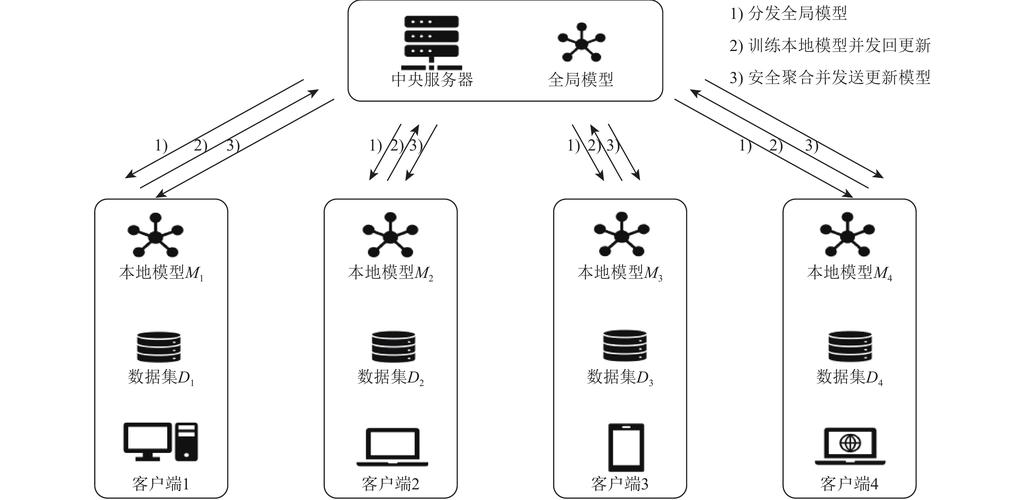
2024年工业联邦学习的最新落地进展
说实话,今年我跑了十多家头部制造企业,发现工业联邦学习的落地已经走出概念期了,不少实打实的项目已经出了效益。
💡 几个我亲眼见过的成功案例: 钢材缺陷检测:宝钢多个厂区的探伤数据,因为数据安全要求不能出厂区,用工业联邦学习联合训练模型,准确率比单个厂区训的模型提升了12%,漏检率降了快15%。 光伏组件发电量预测:头部光伏企业联合全国不同基地的发电数据训练模型,预测误差降了9.7%,对电站运维调度的帮助特别大。 刀具寿命预测:珠三角好几家机加工厂联合不同产品线的数据做预测性维护,刀具提前报废率降了10%左右,每年省下来的成本就是大几十万。现在还有一个很明显的趋势,就是边缘侧工业联邦学习越来越成熟,模型拆分和聚合都在本地边缘网关上完成,不需要把参数传到公有云,既省了带宽成本,又进一步降低了隐私风险,普通的工业网关就能跑,不需要额外换一大堆硬件,成本降了很多。
❗ 给想试水的企业提个醒: 不要盲目追概念。如果你工厂所有数据都攥在自己手里,没有跨主体共享的需求,那完全没必要凑这个热闹,老老实实训模型就行,花那冤枉钱干嘛。 如果你确实有跨车间、跨企业的数据需求,又不敢放原始数据出域,那别犹豫,现在找个小场景先试点,投入不大,试错成本低,跑通了再扩,真的不亏。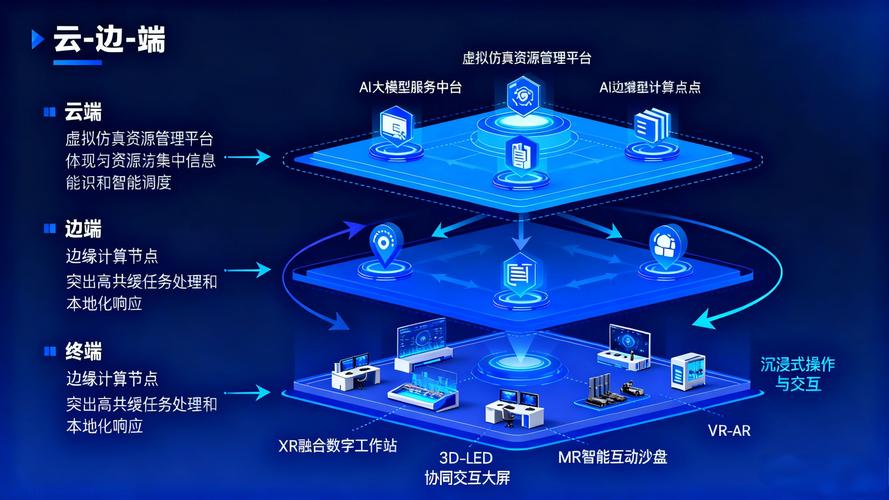
相关推荐
-
舌尖上的时光:藏在美味里的生活温度
美食从来不止是填充饥饿的物质,更是串联记忆、传递情感的特殊符号。一碗热气腾腾的汤,一块酥脆的糕点,或是一盘家常小炒,都可能在某个瞬间唤醒心底最柔软的片段,让平凡的日子变得有滋有味。人们对美食的追寻,本质上是对美好生活的向往,每一次味蕾的触动,都是生活给予的温柔馈赠。 走进巷弄深处的老字号面馆,总能闻到一股浓郁的骨汤香气。店家的老师傅守着灶台三十余年,手里的长…
-
表面处理实战笔记:这些细节决定了你的零件寿命
干这行快二十年,还是经常被一些低级失误气得拍桌子。上周一个老客户的镀锌件又出问题——三个月,仅仅三个月!螺丝根部就冒红锈,像嘲笑我们整个品控流程。说实话,表面处理这个环节,很多人当它是面子工程,可偏偏面子下面就是命门。 我见过图纸上标注得漂漂亮亮,结果实物一塌糊涂的惨案,也经历过因为镀层剥落导致整机召回——那损失,不是多省几毛钱电镀费能补回来的。❗今天不聊虚…
-
时间测定(MTM):帮离散制造砍掉无效工时的隐形抓手
很多工厂厂长盯着设备OEE往上走,转头发现生产线堆了半米高的在制品,工人明明忙得脚不沾地,订单就是交不出来。问题出在哪?很多人想不到。你根本没算对工人每个动作花的时间。 什么是时间测定(MTM)?别和普通秒表测时混为一谈 不少人一听到时间测定,第一反应就是拿个秒表蹲在工人身后掐数。那是老黄历了。 时间测定(MTM)的核心逻辑,是把所有操作拆解成最基础的动素—…
-
能源效率的真相:我们都被“差不多”给坑了
上个月去一家汽配厂,厂长指着电费单直摇头。“技术升级都做了,电机也换成高效的了,怎么用电量还下不去?”他叹了口气。我看着车间里漫天飞舞的压缩空气管接头漏气声,没有说话。这事儿,其实特典型。 搞工业的人,对能源效率这词儿太熟了。熟到有点麻木。人人都在喊节能,方案一摞一摞,计量表装了一堆,结果呢?一度电没少花。我见过太多工厂,把“节能”干成了“搭积木”——东一块…
-
快速换模(SMED):我们厂从4小时到3分钟的蜕变实录
😤 一开始,没人相信能压缩到十分钟以内 那时候我刚接手注塑车间,换一套模具,从停机到重新出合格品,平均耗时4小时12分钟。你没看错,4个多小时。说实话,还不如停机去吃个午饭再回来。关键是——管理层觉得‘这很正常’。我很想说:正常个鬼。 直到有一次去日本研修,亲眼看见人家换模只用了6分半,我整个人傻掉。那感觉,就像骑了一辈子自行车,突然看见高铁。我当时就下了决…