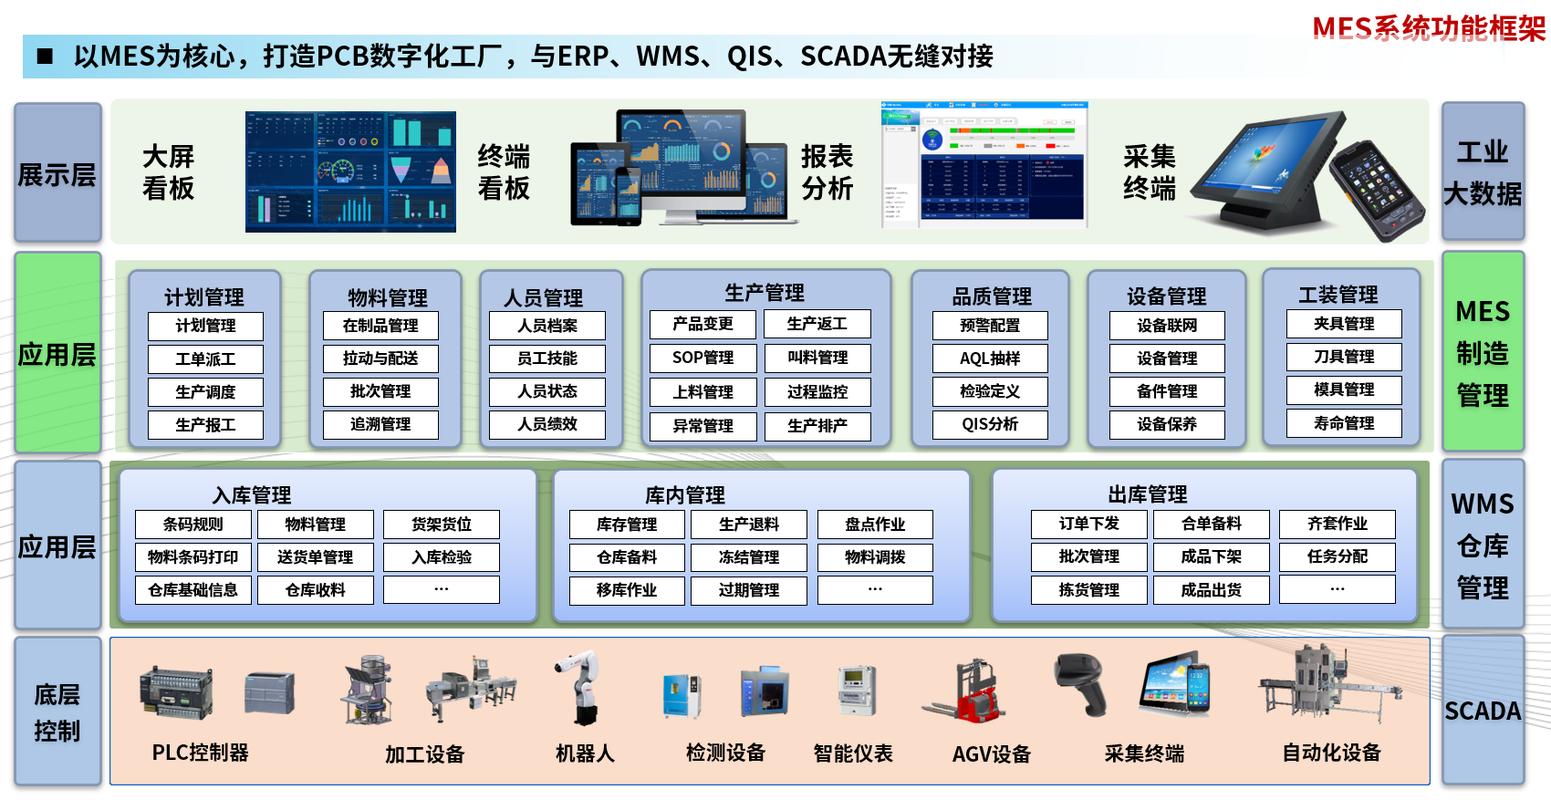
去年冬天帮东莞一家做汽车底盘冲压件的工厂梳理数字化改造方案,一进门生产总监就拉着我看墙角堆的半人高废件。那都是上个月模具裂纹没及时发现,一口气干出来的,小一百万打了水漂。
之前他们用的是传统批量数据处理,传感器数据每15分钟打包上传一次,算完出结果,最快也要等十八九分钟。等系统发出警报,废件已经堆得半车厢了。
这就是现在很多制造企业的痛点——你有了满产线的传感器,却拿实时产生的数据没办法。流式数据处理就是来解决这个问题的。
放在十年前,别说流式,你产线能攒齐数据就不错了。那时候传感器贵,一条线装十几个就算顶配,一秒出一个数据点,攒几个小时批量处理完全够用。
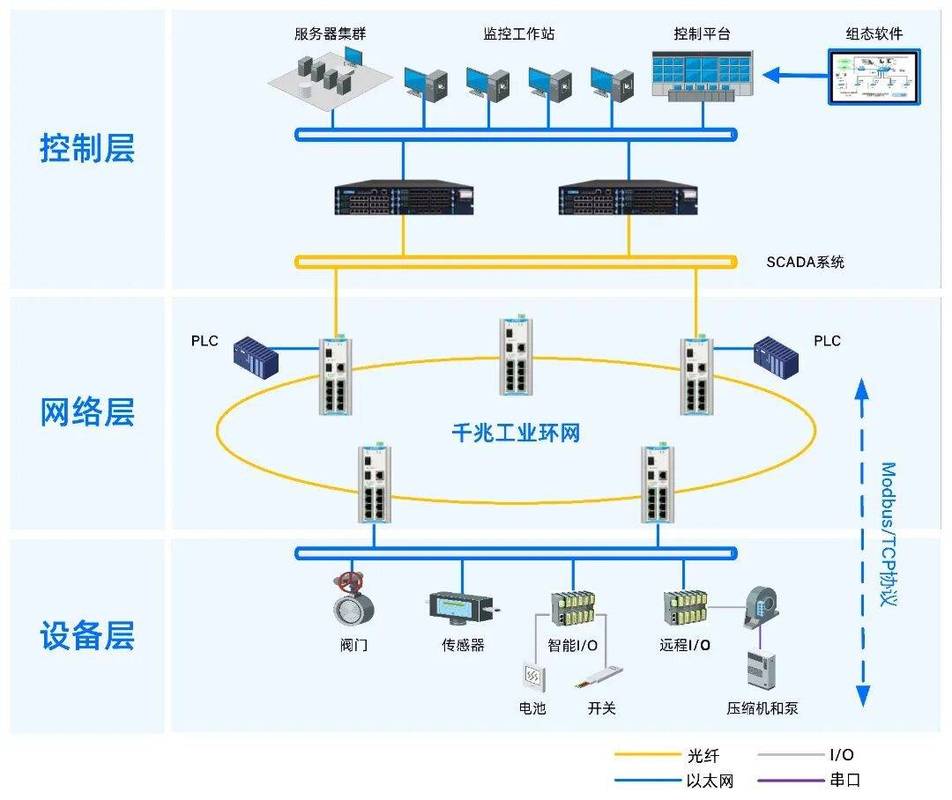
现在不一样了。新能源、汽车高端零部件这些领域,一条核心产线装两三百个传感器是常态,振动、温度、压力、位移全要测,采样频率做到毫秒级。一秒钟就是几百上千条数据,你还攒着打包处理?黄花菜都凉了。
之前那家工厂的IT主管跟我吐槽,一开始试过把数据全传到云端做批量分析,高峰期延迟能飙到半小时,等于报废完了才告诉你出问题了,有啥用?
问:流式数据处理和我们常用的批量数据处理到底差在哪?能不能用大白话讲清楚?
答:点外卖的时候,批量处理是等整个片区的单都收完了,商家再一起做一起送。流式数据处理是你一下单商家就开始做,做好马上给你送。放到工业场景就是:批量是攒够一批数据再计算,流式是数据一产生就计算,结果秒出。就这么简单。
问:是不是所有工厂都要换掉批量处理,全上流式数据处理?
答:当然不是。你要是做普通建材,一条线一分钟才出十几个数据点,对异常响应速度要求也不高,批量处理完全够用,犯不上花几十万搭流式架构。说白了,流式是给对实时性要求高的场景用的——比如高精密零部件的生产异常检测、核心设备的预测性维护、锂电产线的实时质量把控,这些地方才用得到。
很多人觉得,不就是搭个Kafka+Flink栈吗?网上一堆教程,照着搭就行了。真放到工业场景,你会发现错得离谱。
工业数据的脏,是做互联网大数据的人想象不到的。电磁干扰、传感器丢包、电压不稳跳点,一秒钟给你出十个完全离谱的异常值,你直接拿原始数据做流计算,一天能给你报十几次假警。
我上个月去苏南一家新能源电池厂,他们刚上线流式方案的头一个月,运维班的小伙子一天跑八趟车间,累得骂街,差点就把整个系统下线了。
说实话,工业流式数据处理的核心,从来不是比谁的吞吐量更大,而是
现在业内最成熟的实践,就是「边缘+云」的分层流式处理架构。把简单的预清洗、异常规则判断下放到边缘端,在产线本地就做完实时计算,只把异常事件和汇总统计数据传到云端,既省了带宽钱,又把延迟压到了毫秒级。
还是开头说的那家东莞冲压厂,改完这套架构之后,异常检测延迟从18分钟降到了不到1秒,今年年初已经靠实时预警拦住了三次模具早期开裂,挽回的损失早就覆盖了改造的投入。
给大家整理几个实打实的落地建议:
💡 先试点再铺开,别上来就全工厂改造。挑一条出问题损失最大的核心产线先上,跑通了再扩,踩坑成本极低。
❗ 别迷信云厂商的全托管通用方案。默认配置都是给互联网业务做的,根本适配不了工业数据的脏,一定要结合自己产线的情况调参数。
✅ 现在国产流式计算框架做得已经非常成熟了,支持本地化部署,适配工业场景的安全性要求,性价比比国外方案高太多,完全可以放心用。
不过话说回来,现在很多工厂搞数字化,上来就要做大模型、要做全局智能,连最基础的实时数据处理都没理顺。流式数据处理就是工业智能的地基——你连一秒钟前产线出了什么问题都不知道,还谈什么预测、谈什么智能?对吧?
你要是最近在推产线预测性维护或者实时质量控制,不妨先查一下你的数据处理延迟是多少。说不定换个流式架构,卡住你的问题直接解决一半。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:制造业设备运维中的流式数据处理:从半小时延迟到秒级响应 https://www.dachanpin.com/a/tg/70604.html