为什么工业圈现在都认可工业联邦学习?
制造业喊了十几年数据打通,喊到现在,大部分还是一座座孤岛。 同一条生产线,不同供应商的PLC、传感器数据不开放;同一个园区,不同车间的数据归属不同部门,互相拿不到;同一个集团,跨省市的厂区,数据合规要求不一样,想拉到一个平台训模型,过不了审。 最尴尬的是供应链协同,比如整车厂要预测上游供应商的零部件缺陷,供应商敢把自己的生产数据全给你吗?换你你也不敢。 💡 工业联邦学习的核心就是原始数据不出域,模型效果共提升。各个参与方把自己训模型的梯度或者特征加密之后传上来,聚合完再发回去,原始数据从来没离开过自己的私有存储。完美解决了数据共享和数据隐私的矛盾。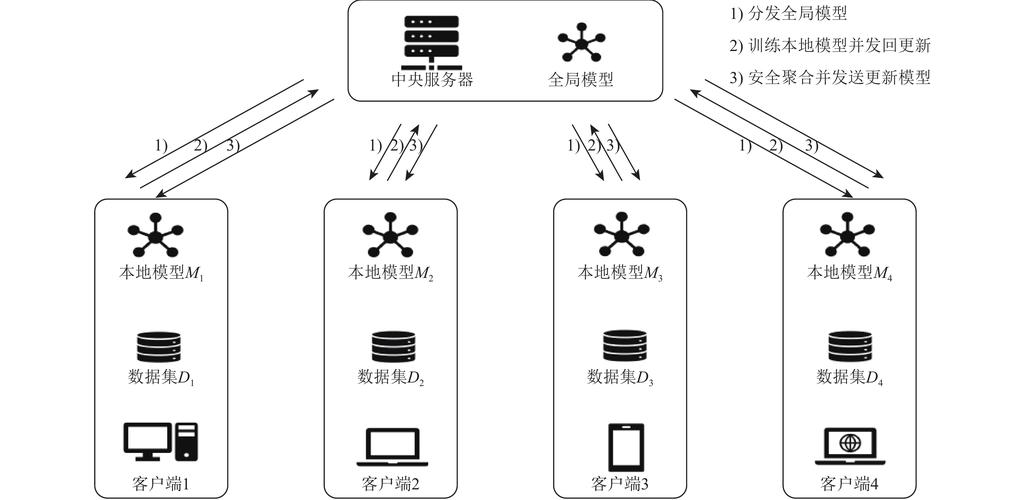
2024年已经跑通的工业联邦学习实践
说实话,之前我也觉得这就是个实验室概念,直到今年去长三角调研,亲眼看到两家工厂的落地项目,才惊觉已经能用了。 国内头部光伏企业做TOPCon电池生产,扩散、氧化、镀膜三个工序分别交给三个不同的供应商做MES,每个供应商都不会把自己的工序数据开放给别人,之前做电池效率预测,每个工序单独建模,准确率最高只有84%。后来用横向工业联邦学习,三个供应商各自在本地训模型,只传加密后的梯度参数,聚合之后的联合模型准确率直接冲到92.7%,单GW产能一年多赚大几千万,你说香不香? 还有国内头部民营钢厂,两个不同厂区生产同规格汽车板,一个在华东,一个在西南,因为数据安全合规要求,不能把原始数据汇聚到一起。之前两个厂区各自的质量预测模型准确率都在81%-83%之间,不合格品流出率一直降不下去。用上纵向工业联邦学习之后,模型准确率升到91%,不合格品流出率直接降了40%多,而且全程没有任何一方原始数据出域,合规部门直接签字通过。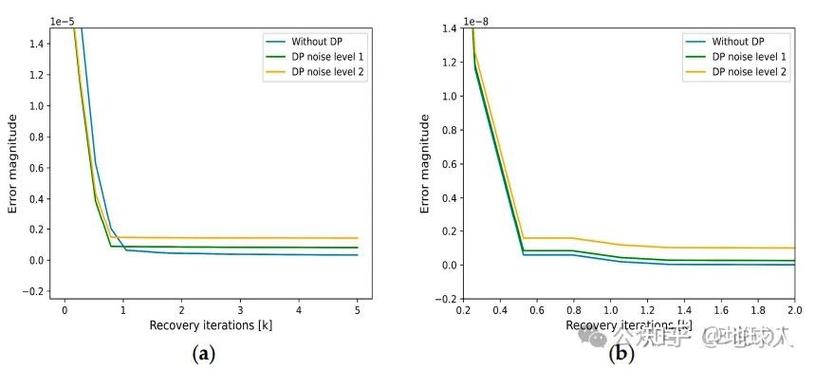
工业联邦学习落地,一定要避开这几个坑
概念好,不代表落地容易。我接触过三个项目,两个半途而废,踩的坑都差不多。 ❗ 第一个坑:不考虑工业网络实际情况。很多做算法的团队,习惯了IDC的稳定大带宽,直接把联邦学习的代码搬过来,一到工厂现场就傻了——车间的无线网关时不时断连,一个节点掉线,整个训练过程就卡壳,有的节点带宽不够,传梯度都传半小时。现在成熟的方案都会做梯度压缩、断点续训、异步聚合,适配工厂不稳定的网络,这点一定要提前问清楚。 ❗ 第二个坑:不做数据分布对齐。A厂区的设备是新上的,运行温度比B厂区低十度,原料成分也不一样,数据分布根本不在一个区间,直接联邦训练,效果比单个模型还差。所以一定要提前做域自适应处理,把不同节点的数据分布拉齐了再训,别上来就套通用模型。 ❗ 第三个坑:被概念割韭菜。说实话,现在很多AI服务商把工业联邦学习吹成万能药,啥问题都能解决,上来就要收你几百万服务费。别交智商税。你就一个小工厂,总共三条线,数据都在自己服务器里,老老实实训普通模型就行,犯不着凑这个热闹。只有跨企业、跨厂区、数据确实不能出域的场景,才值得投入。 工业数字化走到今天,早就过了“先打通所有数据再做AI”的阶段了。很多时候不是我们不想打通,是有各种合规、商业、保密的限制,根本打不通。工业联邦学习就是在这种限制下,把AI能用起来的办法。它不是万能的,但确实解决了很多之前解决不了的问题。感兴趣的话,不妨先找个小场景试点试试,水不深,别被概念吓住。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业联邦学习:破解制造业数据孤岛的金钥匙 https://www.dachanpin.com/a/tg/70624.html