、产能数据,到供应链订单、客户需求,哪一块拎出来不是能生钱的金子?
可偏偏,没人敢动。
跨厂联合研发?要共享设计数据,你敢把自己吃饭的核心参数放在别人服务器上?供应链协同对账?上游要你的实时产能数据,转头泄露给竞争对手,你找谁说理去?银行给你放供应链贷款,要看你的生产经营数据,你敢给?
说实话,这个痛点卡了工业圈快十年了。数据要素喊了这么久,到工业这里就是流不动,卡就卡在安全两个字。
问:隐私计算工业不就是互联网领域的数据加密吗?直接搬过来用不行?
答:真不行。互联网隐私计算大多处理结构化的小体量用户数据,工业数据完全是两个物种。动不动就是几个GB的三维工艺模型、每秒上百条的实时传感器流数据,工业场景对延迟要求到毫秒级,你来来回回加密解密,生产线停一分钟损失几十万,谁扛得住?更何况工业数据的敏感点更刁钻,可能就是一个热处理温度的小数点,就是一家厂子好几年攒出来的核心竞争力,半分差池都出不起。
别听圈内人瞎吹概念,现在隐私计算工业已经有不少实打实的落地项目了,我去年跟着调研组跑了长三角五家制造企业,三家已经在核心场景用起来了。
第一个跑通的就是跨企业协同研发。汽车行业最明显,主机厂要和Tier1零部件厂商联合开发新的动力总成,双方都要出自己的设计数据做联合仿真,用了隐私计算方案之后,双方数据
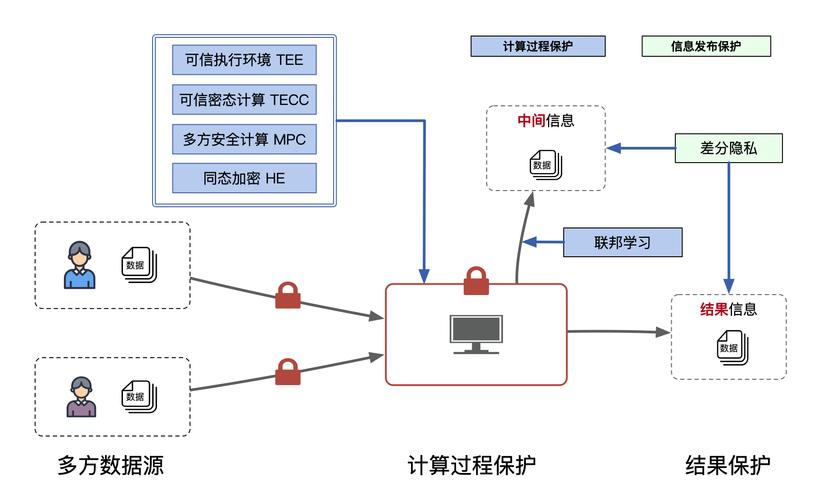
,都留在自己本地服务器,就能完成联合仿真计算,全程谁也拿不到对方的原始数据,既解决了协同问题,又保住了核心机密。
第二个落地就是供应链金融。中小零部件厂子缺资金,但是不敢把自己的生产、产能数据给银行看,怕泄露商业机密,银行也没办法核实真实经营情况,不敢批贷。现在用隐私计算,银行可以在不获取原始数据的前提下,完成对企业经营情况的核验,快速批出低息贷款,企业拿到钱,银行控住风险,双赢。
问:现在做隐私计算工业落地,最大的坑是什么?
答:我见过最多的坑,就是上来就要搞大而全,要把全厂所有数据都接入隐私计算平台,最后砸了几千万进去,用不起来,只能当摆设。隐私计算工业现在还在落地早期,成本还不算低,最合适的做法就是找痛点最突出的一个小场景先跑,跑通了验证了价值再慢慢扩,上来就铺摊子,十个有九个砸手里。
现在很多厂商都盯着头部大型企业做定制化方案,我反倒觉得,未来三五年最大的爆发点在产业集群。
珠三角的电子集群、长三角的汽车零部件集群、泉州的纺织服装集群,一个集群里几十上百家企业,都卡在同一个产业链上,每天都要做数据交互、协同生产,之前要么靠线下传U盘,要么靠人工对账,不仅效率低,还随时有核心数据泄露的风险。现在由管委会或者龙头企业牵头,搭一个集群级的隐私计算平台,每家企业出一点服务费,数据都留在自己本地,就能实现全链条的协同,这不比之前的模式香太多?我上个月刚去东莞一个智能硬件集群调研,管委会的人到处找这类方案,就怕集群里的核心设计外流,又要保企业的协同效率,隐私计算刚好戳中这个需求。
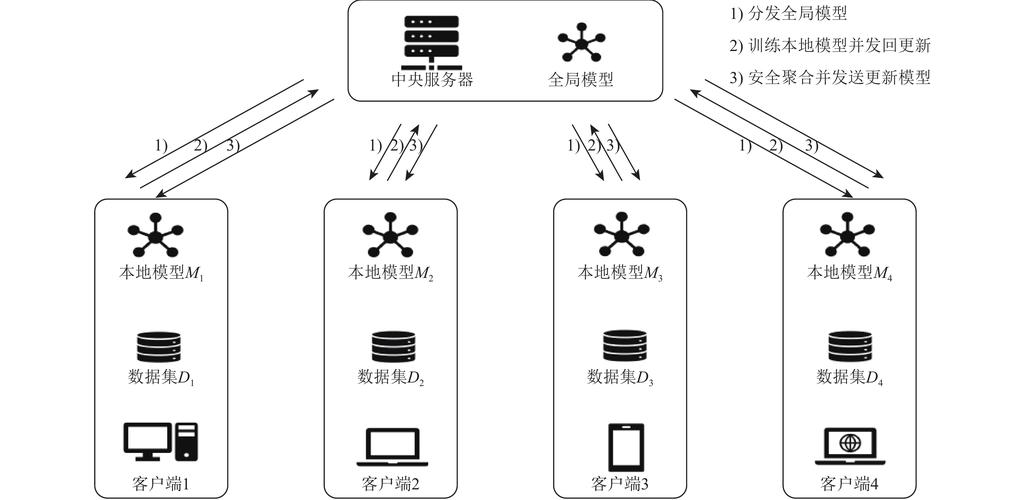
还有一个方向就是工业大模型。现在各家都在抢着训行业大模型,训大模型需要大量的多元工业数据,哪家企业都不可能把所有数据攒齐,又没人敢把自己的原始数据拿出来给别人训模型,隐私计算就是绕不开的解决方案。用联邦学习的方式联合训模型,数据不出本地,效果还不打折,这个方向现在已经有头部团队在做原型了,不出两年就能看到规模化落地的产品。
之前好多做互联网隐私计算的团队,跑来工业圈割韭菜,把概念吹得天花乱坠,上来就要收几百万的平台费,结果落地就卡壳,把好多工厂坑惨了。现在不管是企业还是管委会,都学聪明了,只看能不能解决实际问题,不玩虚的概念。
工业数字化走到今天,数据要流动起来才能产生价值,安全的流动才是可持续的。隐私计算工业不是用来炒的概念,是帮工业界把数据金矿挖出来的铲子。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:隐私计算工业:为什么工业数据金矿现在才敢挖? https://www.dachanpin.com/a/tg/70625.html