为什么通用联邦学习救不了制造业?
互联网公司的联邦学习,面对的都是同构的用户数据,规则统一,标注整齐。 工业数据呢? 同一条产线,2018年装的老传感器采样频率是1Hz,2023年换的新传感器是100Hz。 有的设备能连MES系统自动出数据,有的老机床还要班长手写记录质检结果。 更不用说,很多工艺数据是工厂的命根子,别说给外部,就是集团总部要完整拷贝,车间主任都得犹豫三分。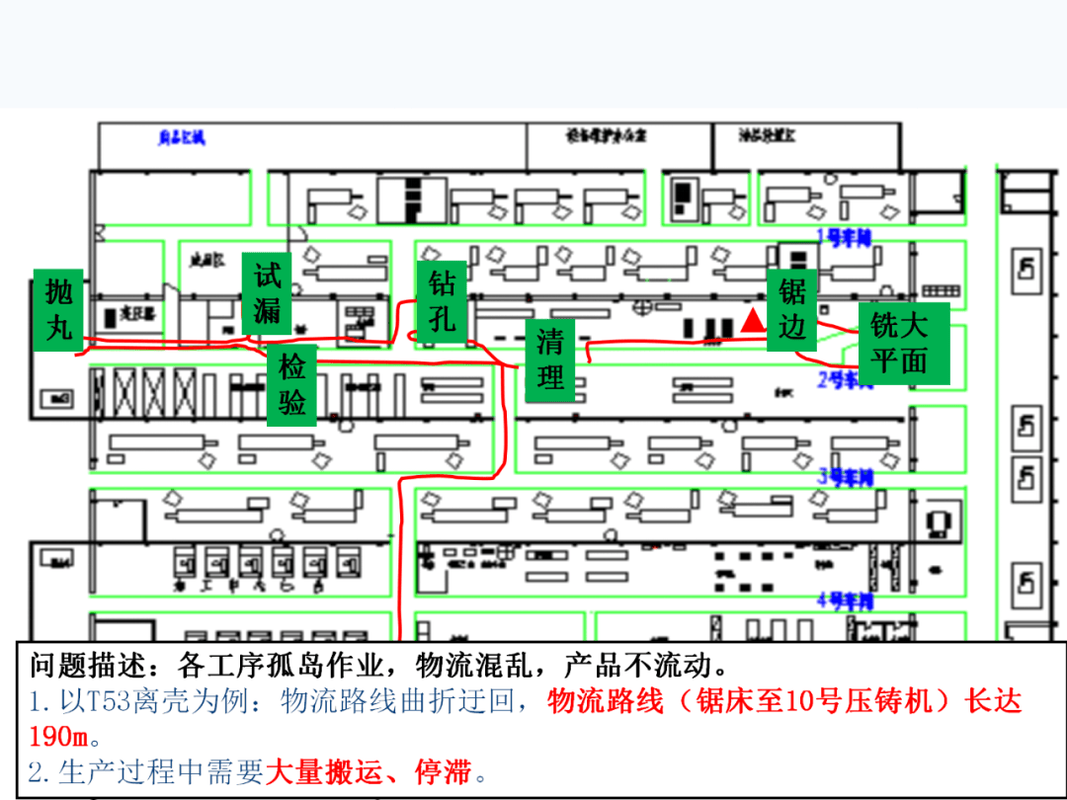
工业联邦学习落地最容易踩的坑
很多技术团队一开始就钻算法精度的牛角尖,最后项目做不出来,拍屁股走人。 说实话,工业联邦学习落地最大的卡点从来不是算法。是工程适配。 你想,工业产线7*24小时转,你的模型迭代不能影响生产吧?通用框架每次传模型参数都要占一大半带宽,搞得产线PLC都卡了,厂长能让你继续做? 去年我接触的一个家电代工厂的项目,就改了两点:把边缘端本地训练的参数压缩了70%,再加了分层聚合——同厂区的模型先聚合,再跨厂区传全局参数,直接把带宽占用降了一个数量级,推理速度提了8倍,刚好匹配产线15分钟一次的质量预测需求。最后算下来,不良率降了2.1个百分点,一年省了一千两百多万。 💡 划个重点:现在最新的落地实践,都是把工业联邦学习和小样本学习结合,大部分细分工艺缺标注数据的问题,直接就解决了。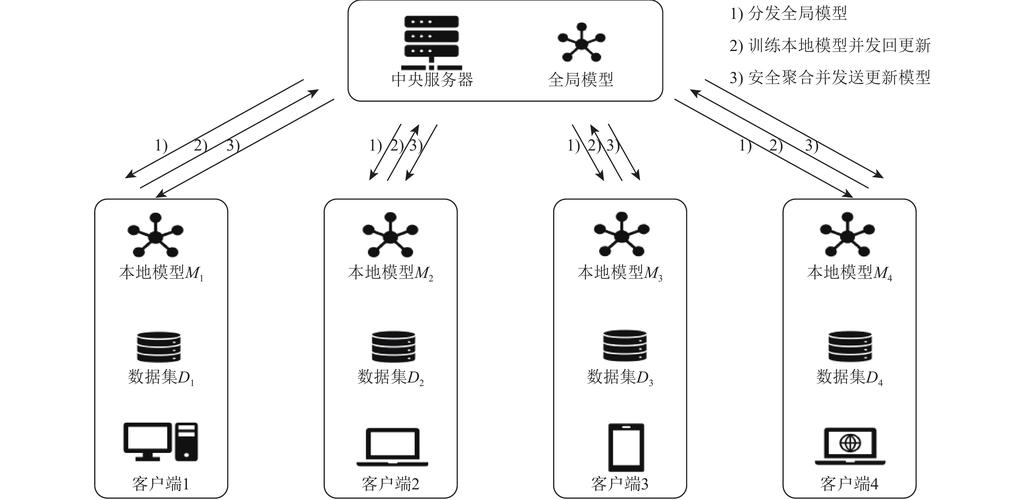
接下来两年,哪些场景会先落地?
第一个就是跨供应链的质量协同。比如汽车主机厂要找几家供应商配套零部件,每家的工艺数据都不能共享,用工业联邦学习一起训质量预测模型,不用出原始数据,就能把整体不良率再降一两个点,这一个点就是大几百万的利润。 第二个就是跨厂区的设备故障预测。同一型号的机床,卖给不同工厂,加工的材料不一样,负荷不一样,故障模式也不一样,每家单独训模型,样本太少精度上不去,用工业联邦学习把大家的模型聚合起来,精度能提10个点以上,还不用交换原始数据,大家都愿意。 不过话说回来,现在整个圈子都在吹工业大模型,很少有人提工业联邦学习。你细想一下,工业大模型要训得好,就得有各个场景的真实数据,谁敢把自己的核心工艺数据随便交出去?工业联邦学习就是工业大模型落地绕不开的底座啊。没有它,再好的大模型也碰不到真实的工业数据,只能停在实验室里做演示。 我上个月跑东莞的装备产业园,三个做数控车床的厂,已经有两个在悄悄测工业联邦学习的故障预测项目了。不是什么PPT上的概念,是真真切切在帮工厂省成本,赚利润。 再过一年,你会看到更多跑通的项目出来。免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业联邦学习:制造业破局数据孤岛的硬核方案 https://www.dachanpin.com/a/tg/71010.html