别把OT数据治理等同于IT侧的数据库清洗
很多人对OT数据治理的认知,还停留在“把数据导出来、去重、补缺失值”的阶段——这完全是把IT侧的结构化数据治理逻辑,硬套到了OT场景里。
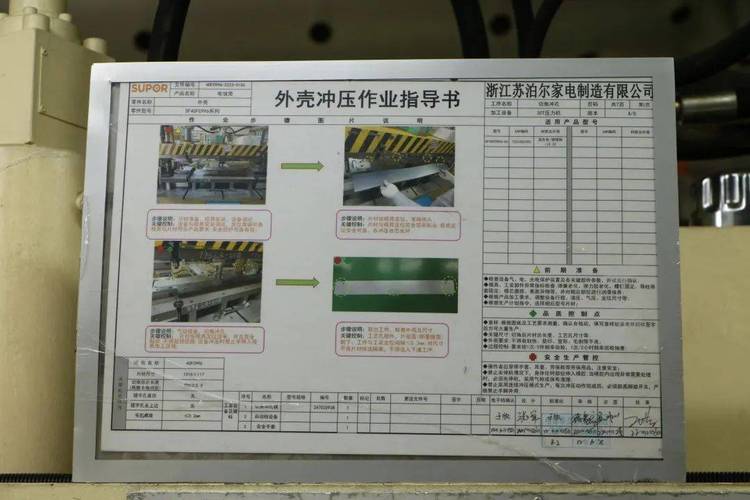
要知道,OT侧的数据从根上就和IT数据不一样:它是和物理设备强绑定的、带毫秒级时间戳的、直接反映生产状态的原始信号。不同厂家的PLC、传感器、数控系统,哪怕测的是同一个参数,命名规则、精度、通信协议全是乱的。比如西门子的冲压机PLC把扭矩参数叫“Press_Torque”,三菱的同类型设备就叫“YA_Force”,甚至同一个品牌的不同年代设备,参数定义都能差出十万八千里。
OT数据治理的第一步,根本不是清洗数据,是先把这些“跨设备、跨品牌的语义差”给抹平。不然你攒的数再多,也只是一堆没法对齐的乱码。
问:我们已经买了数采网关,把所有设备的数都传到中心服务器了,还需要做OT数据治理吗?
答:你那叫“数据搬运”,不叫“数据可用”。我见过太多厂,网关装了半年,导出的Excel里时间戳能差17分钟——边缘端没做全网对时,算出来的设备稼动率全是错的,拿这个数给车间主任考核,人都要跟你急。更别说很多网关直接把传感器掉线时飘出来的满量程值、干扰产生的跳变值一股脑传到服务器,后期人工清洗的成本,比当初装网关的钱还贵。

2024年做OT数据治理,先把“边缘侧的脏数据”拦在门外面
前两年大家做OT数据治理的思路,基本是“先全量采集传到中心,再在中心侧慢慢清洗”——这思路放到现在,纯纯是浪费钱。
现在行业里的最新实践早就变了:把数据清洗、语义标准化的环节,直接下沉到离设备最近的边缘网关层。说白了就是,在数据刚从PLC里读出来的那一刻,就把重复上报的数、传感器误报的数、时间戳不对齐的数直接过滤掉,只把能准确反映设备状态的有效数据传到中心数据库。
浙江一家做锂电结构件的厂之前算过一笔账:之前他们把所有原始OT数据全量传到云时序数据库,一个月光云存储费就要2万多,而且因为脏数据太多,算出来的产品良率偏差能到8%,根本没法用来指导生产。后来他们在每个车间装了带基础预处理功能的边缘节点,直接在边缘侧把无效数据拦下来,存储成本直接砍了70%,有效数据的准确率从之前的62%升到了98%。
真的,这逻辑跟家里装自来水前置过滤器是一个道理——你不装前置,把带泥沙的水全接到家里的储水桶,再雇人一桶一桶捞沙子,这不是纯纯的内耗吗?
问:我们是中小制造企业,预算有限,能不能先不买昂贵的边缘节点,靠人工整理OT数据?
答:我劝你别。去年接触过一家做五金紧固件的厂,一共12台冷镦设备,找了两个刚毕业的实习生,花了3个月把零散的数采Excel整理成统一格式,结果刚整理完,车间换了一台新的进口冷镦机,通信协议完全不一样,之前的整理逻辑全废了,花的2万多人工费打了水漂。中小厂完全可以选带基础预处理功能的入门级边缘网关,一台也就几千块,算下来比雇人划算10倍都不止。

OT数据治理的最终目的,从来不是“存数据”,是给一线车间解决真问题
我见过太多企业,做OT数据治理的初衷就是为了拿数字化补贴、给领导做汇报的时候放个酷炫的实时大屏——钱花了不少,最后数据躺在服务器里,跟一线的生产操作半毛钱关系没有。
就拿最开始说的那家苏州底盘件厂来说,之前攒了三年的乱数据,真正把OT数据治理跑通之后,他们把冲压线的模具磨损信号、设备振动数据,和三坐标检测出来的零件尺寸偏差做了关联建模。之前的换模逻辑是“坏了再换”,现在能提前72小时预判模具的磨损程度,安排计划停机换模,直接把冲压线的非计划停机时间砍了40%,一年算下来省了200多万的停机损失。
你看!这才是OT数据治理该干的事。
💡 这里给大家提几个现在踩坑最多的实操提醒:
- 别上来就搞“全厂统一数据标准”,先从一条核心生产线开始,跑通了价值、拿到一线的认可,再慢慢复制到其他车间
- 一定要让车间的设备管理员、一线班组长参与进来,别全靠IT部门闭门造车——毕竟哪个传感器经常飘、哪个设备的参数容易跳,设备管理员比谁都清楚
- 别追求100%的数据准确率,95%的准确率足够支撑生产决策了,剩下5%的异常值可以慢慢迭代,别一开始就追求完美把项目拖个两三年
上周张总给我发微信,说他们现在把冲压线的OT数据治理跑通之后,车间主任再也不跟他吵“考核数据不准”的事了。其实哪有那么复杂?OT数据治理从来不是什么飘在天上的高大上项目,就是把车间里那些本来就存在、但是乱成一团的生产信号,捋顺了,用起来,真金白银给一线解决问题。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:OT数据治理:车间堆了三年的数采硬盘,为什么变不成生产利润 https://www.dachanpin.com/a/tg/72144.html