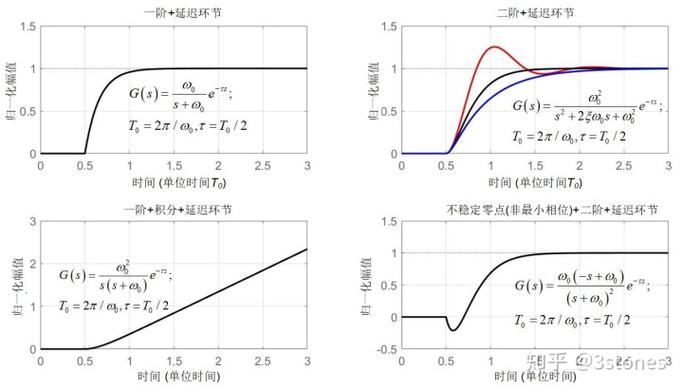
上个月在常州一家注塑厂,车间主任老周拉着我看一台海天160吨机。他指着旁边的工控柜说,这套工业神经网络控制跑了三个月,废品率从4.2%掉到0.8%。我第一反应是——吹牛吧。后来他调出MES的历史曲线,我闭嘴了。
说实话,这种话我这些年听得太多。十个人跟我讲神经网络控温,九个是PPT工程师。剩下的那一个,多半也栽在采样周期和模型漂移上。所以这次我没急着点头。
PID不是不好,是有些工况它真的无能为力
注塑机的料筒温度、保压切换点、模具热流场……这些变量之间的关系压根就不是线性的。你用Ziegler-Nichols整定出来那组参数,换个原料牌号就得重来一遍。对吧?做过多品种小批量的人都懂这种痛。
工业神经网络控制本质上干一件很暴力的事:用数据把这种非线性映射硬逼近出来。它不去建模物理机理,不推导传热方程,直接把输入输出喂进去。听起来挺糙的。但有些时候……糙办法就是好用。
不过话说回来,它也不是万灵药。我见过太多项目把神经网络当图腾供着,结果连基本的信号滤波都没做干净。

问:我们厂数据量不够,是不是就没法上神经网络控制?
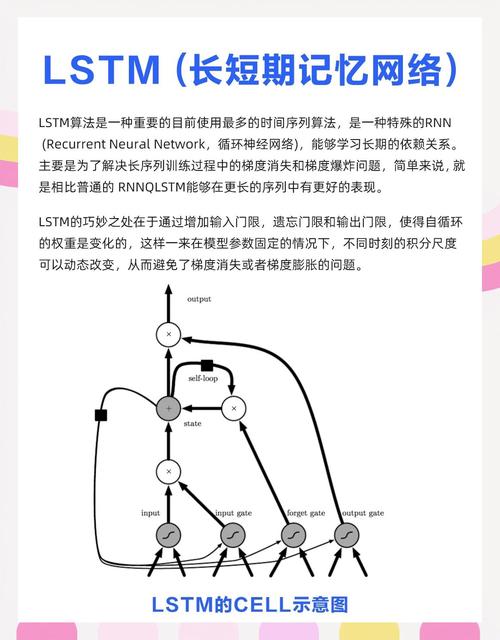
答:这是个特别常见的误区。工业神经网络控制不一定非要海量数据。像注塑成型这种周期性强的工况,一个成型周期就是一个样本,一台机一天跑上千模,半个月就攒出上万条。真正的坑不是数量,是标签质量和工况覆盖面。你手里只有满负荷一种状态的数据,模型一遇到换料、停机再启动就歇菜。这个我在佛山亲眼见过——上线第一周挺漂亮,第二周换了个色母,直接失控。
另外提一句,很多场景用浅层网络甚至极限学习机就够了。别一上来就LSTM套Attention堆三层。参数量大不等于泛化好,产线上你还得算单次推理耗时。❗
边缘算力、采样周期,这两样不匹配,剩下的都是空谈
我见过最离谱的一版方案,用云端跑的神经网络去控压铸机的压射速度。几百毫秒的云端往返,压射都结束了模型才吐出一个建议值。请问这有什么用?
工业神经网络控制要闭环,就必须把推理塞进控制器里,或者至少放进产线边上的边缘盒子。现在贝加莱、倍福TwinCAT、西门子都能挂推理引擎,ONNX格式直接转过去,这条路算是成熟了。
采样率也是个事。你要控的变量如果是毫秒级的,比如伺服压力环,网络的输入层就得吃高频数据,那滤波、降采样、特征提取全部要重做一遍。这块搞不清楚,模型再漂亮也是摆设。
问:模型跑着跑着效果变差了,该怎么办?
答:典型的模型漂移。设备磨损、传感器老化、原材料批次变化……都会让输入分布慢慢偏离训练时的分布。刚上线时R²有0.95,半年后掉到0.7,太常见了,别慌。
做法无非三种,可以组合用:
- 定期再训练——把新数据加进训练集,每周或每月触发一次,注意保留旧工况样本,防灾难性遗忘;
- 在线自适应——只更新最后一层,代价小,适合缓慢漂移;
- 残差监测告警——不自动改模型,但预测偏差超阈值就报警,先让人来判断。
我个人偏向第三种加第一种。产线这东西,全自动自我进化听着爽,真出了事没人担得起责任……💡
还有个容易被忽略的点:可解释性
老周后来问我一个问题,把神经网络控温的曲线拿给客户看,客户不认,说看不懂。这确实是工业场景和学术场景的差别。产线上你要的是可追溯,不是黑箱给出一个神秘数字。
所以现在有个折中做法:网络输出一个建议值,外面套一层规则引擎做边界限幅,超范围的直接拒绝执行。同时把关键输入的贡献度算出来,比如SHAP值,让操作工知道“这次模具温度偏高是料筒三段引起的”。这样人家才敢用。
控制系统的信任是一点一点攒出来的。不是靠一次验收会上放几根漂亮曲线。
回头说老周那台机。三个月省下来的料和人工,差不多把改造费赚回来了。但他们最看重的其实不是钱,是那个自适应功能——换个原料牌号不用再调两小时参数。✅
嗯,先写到这。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业神经网络控制落地实录:PID调不动的工况,它真能救场 https://www.dachanpin.com/a/tg/72697.html