上周跟一个做压铸件的客户吃饭。他掏出手机,给我看了一张照片——办公室里并排摆着三块屏幕。左边是MES的实时产量看板,中间是SCADA的工艺参数曲线,右边?居然是一份手动维护的Excel点检表。
三块屏,同一个车间。同一台2800吨的压铸机。
我没笑。这种场面我见得太多了,多到已经笑不出来。❗更扎心的是,那台机器上明明装着OPC UA接口,采集网关也买了,线也接了,数据确实在流动——只不过流进了三个互不相认的黑洞。
这就是工业数据编织要解决的事。但它跟很多人想的不太一样。
孤岛不是技术问题,是二十年的历史遗产
很多老板一听“数据打通”,第一反应是上数据中台。把数据全抽上来,堆进一个大湖,再慢慢治理。听着很顺。做起来呢?
产线那边每秒钟几万个测点涌上来,IT那边的ERP一天才产生几百条工单。采样频率不一样,时间戳对不齐,设备命名还是一团乱麻——同一台空压机,在ERP里叫“KP-01”,在MES里叫“空压机1号”,在设备台账里又叫“A车间螺杆机”。你让ETL工程师怎么映射?靠猜吗?
工业数据编织(Data Fabric)的核心思路,恰恰是反过来的:不搬数据,先编语义。
别急着把数据抽到一个地方。先给每一台设备、每一个测点、每一道工序建立统一的语义身份。这个身份一旦立住,数据留在原地也没关系——它们已经知道彼此是谁了。

说白了,过去二十年我们干的是“物理集成”,现在要干的是“语义集成”。前者拼的是接口和带宽,后者拼的是对工艺的理解。哪个更难?我觉得后者难十倍,但也值十倍。
技术栈长什么样:从OPC UA到元数据图谱
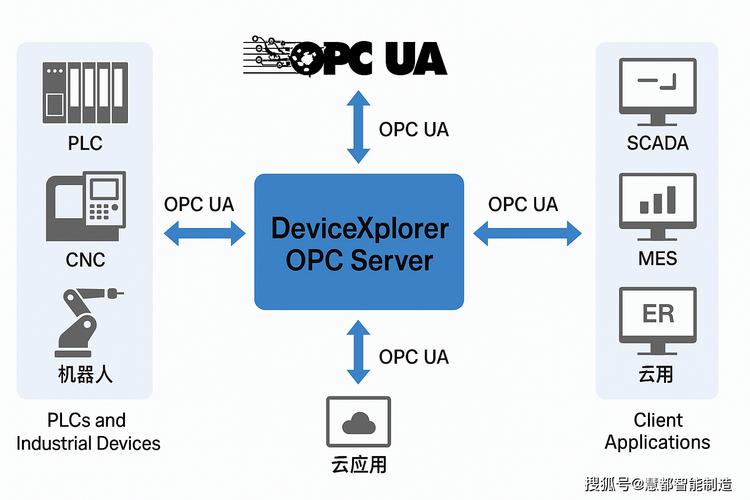
如果非要把工业数据编织拆开看,我通常分成四层来讲,不讲虚的。
第一层,接入层。车间侧的主力还是OPC UA和Modbus,新一点的设备开始支持MQTT,做IoT场景的会用到Sparkplug B。边缘网关在这里的角色很关键,它不只是协议转换器,还得负责时间戳对齐、数据压缩、断网缓存。
第二层,虚拟化层。这层是数据编织和传统数仓最大的分水岭。数据虚拟化引擎不复制数据,而是把分布在PLC、时序库、MES关系库、PLM文件系统里的数据,映射成统一的逻辑视图。工程师写一条SQL,底下可能同时在查TDengine和Oracle。✅
第三层,元数据与知识图谱。这是真正的“编织”动作发生的地方。主动元数据会持续扫描数据源的变化——新加了一个测点、某个字段类型改了、某台设备的通信中断了——然后自动更新图谱里的关系。
比如:“1号压铸机 → 属于 → 压铸车间 → 由 → MES工单系统管理 → 关联 → 模具寿命数据”。这条链路一旦建立,你查一个良品率异常,系统能自动把工艺参数、模具使用次数、保养记录全拉出来。
第四层,消费层。BI报表、数字孪生、预测性维护模型,都是在这层吃的饭。前三层没搭好,这层做出来的东西基本就是给领导看的PPT。
问:数据编织和传统的数据中台,到底差在哪?是不是换个名字炒概念?
答:差在数据的存放位置和治理时机。数据中台是先集中、后治理,数据编织是先治理(编语义)、再按需访问。工业现场有个现实约束——高频时序数据全量上传云端的成本高得离谱,而且很多工厂出于网络安全的考虑根本不允许。虚拟化和联邦查询这套机制,恰好绕开了这个坎。所以不是炒概念,是被工业场景逼出来的架构选择。
落地时最容易踩的几个坑
我见过不少项目,方案书写得漂亮,最后死在细节上。说几个最典型的。
坑一:设备命名没有统一标准。ISA-95和OPC UA信息模型早就给了参考,但真正做的时候,没人愿意停下来花两周时间做资产建模。大家觉得这是“不产生价值的工作”。结果呢?后面所有的映射规则都得靠人工维护,一百台设备还行,一千台就崩了。
坑二:时间戳没对齐。这个特别隐蔽。PLC用的是本地时钟,网关用的是NTP同步时钟,数据库写入时又加了一层时间戳。差个几百毫秒,做工艺追溯的时候就能让你怀疑人生。我的建议是——在边缘侧就统一到UTC,别拖到平台层再处理。
坑三:指望一步到位。数据编织是个演进过程,不是交付物。先编一条产线,验证语义模型对不对,跑通了再横向复制。我见过一个项目,一上来就要覆盖全厂十二个车间,做了两年,第一个车间还没验收。

问:我们厂规模不大,就三百来台设备,也没有专门的数据团队,搞数据编织是不是太超前了?
答:恰恰相反,小厂反而更容易做。设备少,命名标准推行阻力小;没有历史包袱,不用去迁就十年前建的老系统。起步也不用全套上,先把资产模型和元数据目录做起来——用开源方案,几个人的IT团队就能维护。真正的门槛不是钱,是愿不愿意承认“我们厂的数据确实是一团乱麻”。💡
一个实际的判断标准

怎么判断你们厂有没有到该做数据编织的阶段?我给个粗暴但好用的标准:
- 当工程师需要一个数据,得先打三个电话问不同部门要权限时;
- 当同一个指标,两个系统算出来的数字对不上,谁都不知道该信哪个时;
- 当设备出了故障,要把工艺、维护、物料三份记录拼在一起才能分析,而这个拼的过程全靠人肉时。
满足任何一条,就说明你的数据已经在互相打架了。这时候再往数据湖里堆数据,只会让混乱更混乱。
先把关系理清楚。数据放哪儿,反而是次要的。
说到底,工业数据编织这件事,技术含量有,但真正决定成败的是工艺知识——你懂不懂这台设备在干什么,懂不懂这道工序为什么这么设计。不懂工艺的人做数据集成,做出来的永远是一张漂亮的拓扑图,而不是能用的东西。
那位客户的Excel点检表,上个月终于撤了。三个屏幕合成了一块。他说过程比想象中麻烦,但总算不用每天早上去手动对数字了。
挺好。真的挺好。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业数据编织:车间里的数据孤岛,比设备故障还难修 https://www.dachanpin.com/a/tg/72930.html