
先别急着上大模型。真的。很多工厂的痛点不是模型不聪明,而是数据从设备到算法之间那段路——太堵了。我在一家汽车零部件厂见过,200多台CNC,每台装了振动和电流传感器,采样率10kHz。数据呢?每天晚上定时批量拉到服务器。等第二天早会看到报警,刀具已经崩了。损失?一条线停两个小时。这事听着离谱,但太常见了。
流式数据处理要解决的,就是“等不及”的问题。它不是把批处理窗口从一天改成一分钟那么简单。事件一发生,数据就得动起来。边采、边算、边判断。
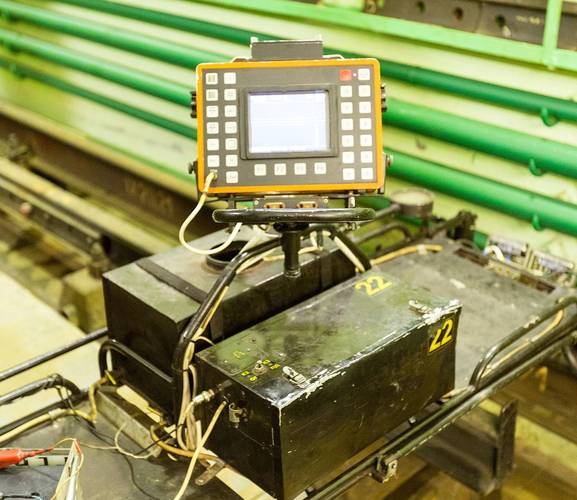
为什么传统批处理在设备侧越来越吃力
工业数据有三个脾气:高频、乱序、还爱丢包。振动传感器一秒钟几千个点,PLC扫描周期几毫秒。你用关系型数据库攒着,再定时查询?数据库先跪下。更麻烦的是,车间网络抖一下,数据到得顺序全乱。批处理只看“落库时间”,根本不关心事件真实发生的时间。
流式数据处理把“事件时间”当成一等公民。窗口、水位线、状态,这些概念听着抽象,翻译成人话就是:我知道数据可能迟到,但我得决定等它多久。等太久,报警慢;等太短,漏检。这个平衡,靠业务定,不靠拍脑袋。
问:流式数据处理和普通数据库定时查询,差别到底在哪?
答:定时查询是“到点了去看看有没有新数据”。流式数据处理是“数据一到就触发计算”。前者延迟取决于轮询周期,通常分钟级;后者可以做到毫秒到秒级。更关键的是,流处理能保留事件时间、处理乱序、维护中间状态。比如计算轴承振动最近30秒的RMS,批处理要反复扫表,流处理只维护一个滑动窗口。数据量越大,差距越吓人。
还有个现实问题:很多工厂的OT网络和IT网络是隔离的。你想把原始高频数据全丢到云端?带宽和合规都不答应。所以边缘流式处理成了标配。在网关侧先做降采样、特征提取、异常初筛。只把有价值的事件和特征推上去。省带宽,也省云上算力。

从OPC UA到Kafka再到Flink:一条可落地的数据链路
别一上来就追求“全厂一朵云”。先跑通一条线。典型链路长这样:
- 设备层:PLC、CNC、机器人、传感器。支持OPC UA的走Pub/Sub,老设备走Modbus RTU/TCP或4-20mA。
- 边缘层:协议网关转成MQTT或Kafka协议。在这儿做时间戳对齐、单位归一化、简单滤波。时钟同步别忘了,NTP是底线,要求高的上PTP。
- 消息层:Kafka、Pulsar、EMQX。分区键选设备ID,保证同一台设备的数据有序。分区数不是越多越好,要看下游并行度。
- 计算层:Flink、Kafka Streams、Spark Structured Streaming。做窗口聚合、模式检测、流式join。Flink的状态后端用RocksDB,大状态场景稳。
- 存储层:时序数据库如TDengine、IoTDB、TimescaleDB。原始高频数据存边缘,特征和事件存中心。
- 应用层:看板、告警、工单、MES/QMS。告警别只发邮件,要能触发PLC停机或Andon拉绳。
这条链路里,最容易被低估的是背压。下游算不过来,上游还猛灌,Kafka堆积,Flink反压,最后延迟飙升。解决?监控消费lag,设置合理的并行度,给关键流留资源隔离。别让一个日志采集任务把预测性维护的流饿死。
问:老设备没有OPC UA,只有4-20mA和RS485,怎么搞流式数据处理?
答:加IO模块和协议网关。4-20mA进远程IO,RS485走Modbus网关。网关负责轮询,转成MQTT上报。轮询周期可能只有100ms,做不到毫秒级,但做设备状态和能耗分析够用。关键是给数据打上准确时间戳,别用网关收到的时间代替设备产生的时间。如果工艺要求高,换带时间戳的智能仪表,或者上边缘采集卡。
预测性维护不是玄学:特征工程和实时告警阈值怎么定
很多人一谈预测性维护就想到LSTM、Transformer。但现场先问三个问题:特征算得出来吗?阈值谁定?误报谁扛?
振动监测里,时域特征最实用:RMS、峰峰值、峭度、峰值因子。频域看包络谱和边频带。电流信号看Park矢量。温度变化慢,适合做趋势。流式数据处理的好处是,这些特征可以滑动窗口实时算。比如每1秒算一次最近10秒的RMS,每10分钟算一次趋势斜率。
阈值别只写死一条线。可以用历史分位数,比如P99。也可以上轻量模型:孤立森林、One-Class SVM、自编码器。模型训练在离线,推理在流里。Flink UDF加载ONNX Runtime,或者Kafka Streams调用模型服务。注意特征口径必须一致。离线用未来数据算的均值,在线可没有。
我见过一个坑:离线训练用重采样后的1秒数据,在线却用原始10kHz数据算特征。结果模型在线表现一塌糊涂。修了两周,最后发现是窗口长度单位搞错了。真让人头大。
问:流式数据处理的延迟到底要压到多少才有用?
答:看场景。风机轴承早期故障,秒级甚至分钟级都行,因为退化是渐进的。高速冲压、焊点质量、断刀检测,可能要求毫秒级。别盲目追求低延迟,低延迟意味着更高成本和更复杂的乱序处理。先搞清楚:报警后,人是立刻能停,还是需要走工单?如果是后者,1秒和5秒差别不大。如果是联锁停机,那就得往边缘放,甚至进PLC。
上线之后踩过的坑:乱序、背压、时间同步
流式数据处理在实验室跑通,和在生产环境跑稳,中间隔着几十个夜班。几个高频坑:
乱序和水位线。车间Wi-Fi切换、交换机拥塞,数据迟到几秒很正常。水位线设成5秒,迟到10秒的数据就被丢了。设成1分钟,报警又太慢。折中方案:关键设备用有线,边缘缓存补传,水位线按P99延迟动态调整。别一刀切。
时间同步。边缘网关时钟漂移,会让事件时间全乱。NTP同步精度通常几毫秒到几十毫秒,够用。但高速场景要PTP,IEEE 1588。OPC UA Pub/Sub配合TSN,能做到亚毫秒。贵,但有些场景值。
状态管理。Flink任务跑一周,状态涨到几十GB。检查点超时,任务重启,数据重复。用RocksDB增量检查点,设置TTL清理过期状态。Exactly-once听着美,但在OT侧,at-least-once加幂等写入往往更实际。下游数据库用主键去重,比追求端到端精确一次简单得多。

还有个小细节:别把所有数据都往一个topic里塞。设备遥测、告警事件、模型输出,分开。不然消费者逻辑会变成一团乱麻。分区键也要想清楚,按设备ID还是产线ID?按设备ID能保证单设备有序,但热点分区问题要处理。按产线ID可能单设备乱序。没有银弹,看业务容忍度。
说到最后,流式数据处理在工业里不是炫技。它是一套让数据“活着到达”的基础设施。先跑通一条线,再复制到车间,最后到工厂。别一开始就搞全厂数据中台——那玩意儿,很多最后都变成了数据沼泽。对吧?
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:流式数据处理在工业现场:从振动传感器到预测性维护的实战拆解 https://www.dachanpin.com/a/tg/72934.html


