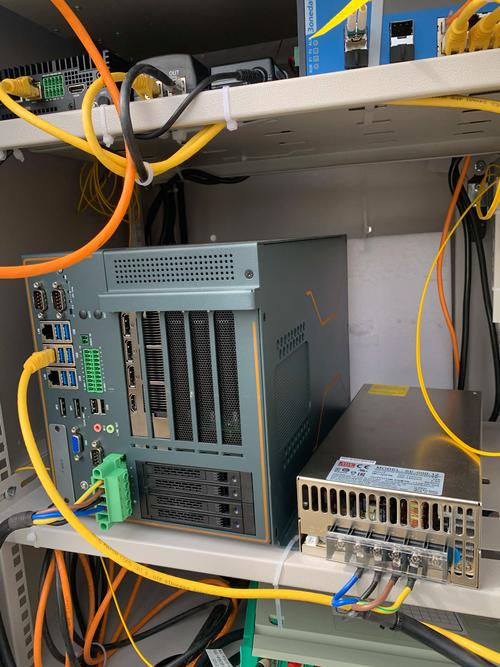
车间里那台2013年产的西门子840D,还在跑。旁边新加的视觉检测工位,数据每秒往上蹦几兆。你说把这些东西一股脑全推到云上?带宽先不答应,PLC的响应周期更不答应。于是就有了云边协同架构这个东西。但说实话,我见过太多厂子把它做成了硬件采购项目——买一堆边缘盒子往机柜里一塞,网络通上,然后呢?然后就没有然后了。
先想清楚一件事:边缘不是云的小弟
很多方案商在讲PPT的时候,喜欢把边缘说成云的延伸。这个说法害人不浅。
延伸的思路会导致什么?会导致边缘节点上跑的,还是那套云原生的东西——容器、服务网格、甚至K8s集群。一个ARM架构的边缘网关,内存可能就2GB,你给它塞个K3s,剩下的资源还够跑实时推理吗?
我个人的判断是:边缘侧的架构逻辑,和云端根本就是两套东西。
云端可以容忍延迟。几百毫秒的抖动,用户刷个页面根本感知不到。但你看贴片机,吸嘴下压的动作窗口是多少?几十微秒。一个确定性的时间窗口,漏掉了就是撞件、就是废板。这里没有“重试”这个选项。
所以云边协同架构的第一条设计原则,我总结为一句话:控制留在边缘,洞察推到云端。

听起来简单对吧?但魔鬼在细节里。什么算“控制”?什么算“洞察”?中间那条线画在哪里,直接决定了你的架构是能用还是能用得舒服。
举个例子。一台注塑机的锁模力曲线,边缘端需要做的是什么?实时采集、实时判断异常、超阈值立刻触发停机信号。这是控制层面的,必须在边缘闭环。但锁模力曲线和历史模具磨损、原料批次、环境温度之间的关联分析呢?这个推到云上跑完全没问题,晚了十分钟出结论也没关系。
协议碎片化:这才是真正的拦路虎
架构图画起来漂亮。落地的时候你会遇到一个非常具体的问题——车间里的设备说八种方言。
Modbus RTU、Modbus TCP、Profinet、EtherCAT、OPC UA、CANopen……这还没算各家PLC的私有协议。你那个边缘节点要做的第一件事,不是跑AI模型,是先当翻译官。
❗这里有一个很多团队踩过的坑:协议转换不要放在边缘应用层做。放在应用层意味着你的Python脚本要去解析字节流,延迟不可控,而且一旦协议版本升级你就得改代码。正确做法是用边缘中间件或者工业网关的驱动层来统一处理,向上暴露标准化的OPC UA接口。
问:我们厂设备品牌太杂,有西门子、三菱、还有几台老发那科,云边协同架构能做到统一接入吗?
答:能,但别指望一个协议网关包打天下。实际操作中,比较务实的方案是按品牌分批接入。西门子系走Profinet或OPC UA,三菱走MC协议,发那科老设备如果没有以太网口,就得加串口服务器先转成Modbus TCP。边缘侧部署一个支持多驱动的数据采集层,对上统一成MQTT或者OPC UA。重点是——不要追求一次性全部接入,先拿一条产线跑通,比全厂铺开然后处处是坑强得多。

边缘节点的算力,怎么配才不浪费

这是我被问得最多的问题之一。很多人的直觉是——边缘节点算力越大越好。不对。
算力配过头,成本上去了,功耗上去了,机柜散热还得重新设计。配少了,模型跑不动,又得回头改硬件。
我的经验是分三档来看:
- 轻量档:只做数据采集、协议转换、简单阈值判断。ARM Cortex-A53级别的SoC就够,功耗5W以内。
- 中量档:需要跑轻量级推理模型,比如YOLO-nano做缺陷检测,或者做振动信号的FFT分析。需要带NPU的芯片,算力在1-4 TOPS之间。
- 重量档:多路高清视频实时分析,或者需要跑较大的时序预测模型。这时候得上x86加独立GPU,功耗直接上到60W以上,机柜得考虑主动散热。
选哪一档?看你的实时性要求和数据量。不要看厂商推荐。厂商永远推荐你买最贵的。
还有一个容易被忽略的点:边缘节点的存储。工业现场震动大、温度波动大,消费级SSD撑不了多久。得用工业级宽温存储,而且要考虑断电保护。我见过一个案例,边缘盒子因为车间电压波动导致文件系统损坏,整个采集程序起不来,停产了半天。就为了省那几百块钱的存储差价。
问:云边协同架构里,边缘和云之间的数据同步怎么做?断网了怎么办?
答:断网是常态,不是异常。车间网络被叉车压断网线这种事,一年总会遇到几次。所以边缘侧必须有本地缓存和断点续传机制。数据先在本地落盘,网络恢复后按优先级补传。优先级怎么定?报警数据最高,过程数据次之,原始波形数据最低——波形数据量太大,可以只传特征值,原始数据按需回传。另外云端下发的模型更新,也要支持边缘端先下载、校验、再切换,不能更新失败导致边缘节点直接罢工。
从试点到规模化,中间隔着三个坑
第一个坑:边缘节点的运维。你部署了50个边缘节点,分布在不同车间、不同楼层。怎么批量升级固件?怎么看每个节点的健康状态?如果没有统一的边缘管理平台,你就得派人一个个去现场插U盘。这事我干过,不想再干第二次。
第二个坑:数据治理。边缘侧产生的数据,哪些留、哪些传、留多久?没有策略的话,要么是边缘存储爆掉,要么是云端收到一堆垃圾数据。建议在架构设计阶段就定义好数据生命周期策略,按数据等级分层处理。
第三个坑:组织架构。这个听起来不像技术问题,但它比技术问题更难搞。IT部门管云,OT部门管车间。云边协同架构天然横跨这两个域。谁牵头?谁负责边缘节点的日常运维?我见过项目卡在这一步卡了半年的。技术方案再漂亮,两个部门互相不配合,照样推不动。
💡说一个我自己的观察:那些云边协同架构真正跑起来的工厂,往往不是技术最先进的,而是IT和OT坐在同一间办公室的。沟通成本降下来了,很多技术问题反而好解决。
回到开头那台840D。它不需要上云。它只需要把关键状态数据吐出来,让边缘节点接住,让云端能看到它的健康趋势。这就够了。别给它加戏。
云边协同架构的本质,不是把云的能力搬到边缘,也不是把边缘的数据灌到云里。它是让合适的事情在合适的地方发生。这句话听起来像废话,但你去车间走一圈就知道,能做到这一点的工厂,真不多。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:云边协同架构:工业现场数据处理的第三条路,很多工厂第一步就走错了 https://www.dachanpin.com/a/tg/72953.html