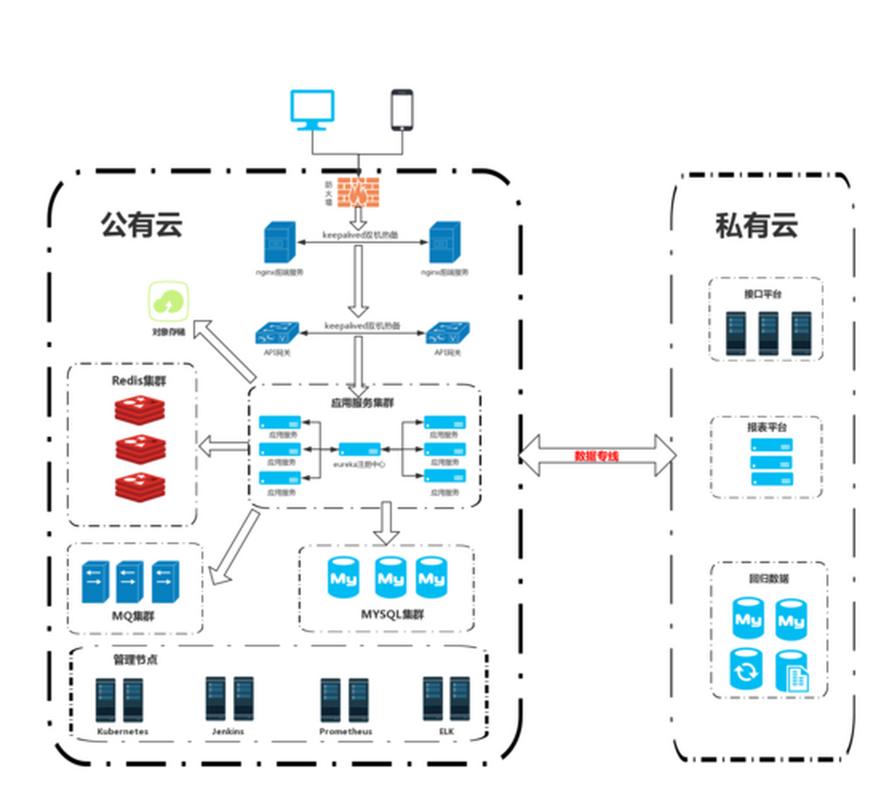
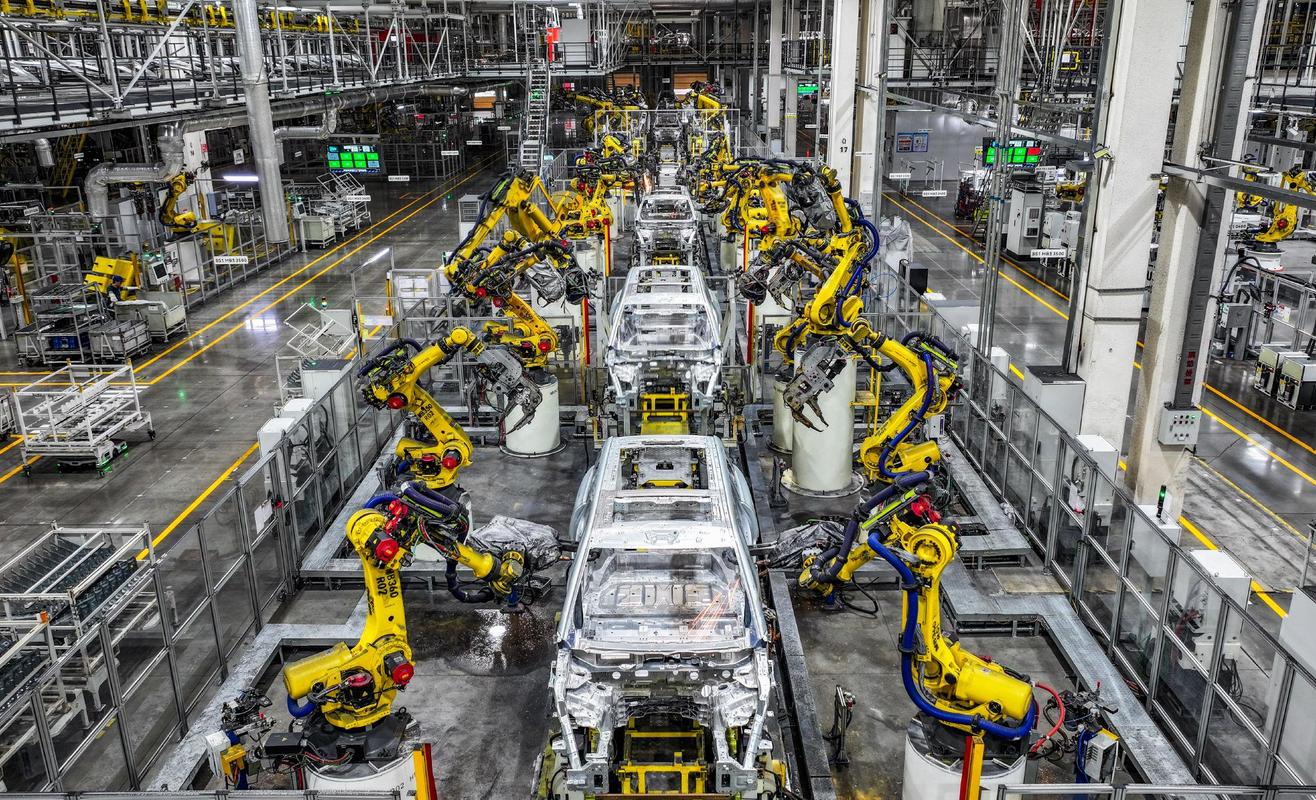
很多制造企业现在都卡在同一个坎儿。攒了好几年的传感器数据、生产日志,躺在厂区本地服务器里落灰。想用AI优化工艺、降本提效,数据量不够,训出来的模型根本不准。想拉上同行或者其他厂区一起玩,核心数据不敢出厂区一步。
为什么偏偏是工业联邦学习解决这个问题?
传统工业AI建模,核心要求就是“拿数据”。要做故障预测,你得把所有设备的运行数据都导出来给算法团队。要做缺陷检测,你得把所有缺陷样本都集中起来标注。
可放在工业场景里,这根本做不到。
化工企业的反应釜参数,是传了几代人的核心机密。汽车主机厂的冲压工艺参数,是竞品花多少钱都想挖的东西。哪怕是同一家集团的不同生产基地,受制于区域合规要求,数据也不能随便跨域流动。
💡 说白了,工业数据的核心矛盾早就变了。原来缺数据,现在有数据,但是被拆成了一个一个孤岛,拿不出来用。
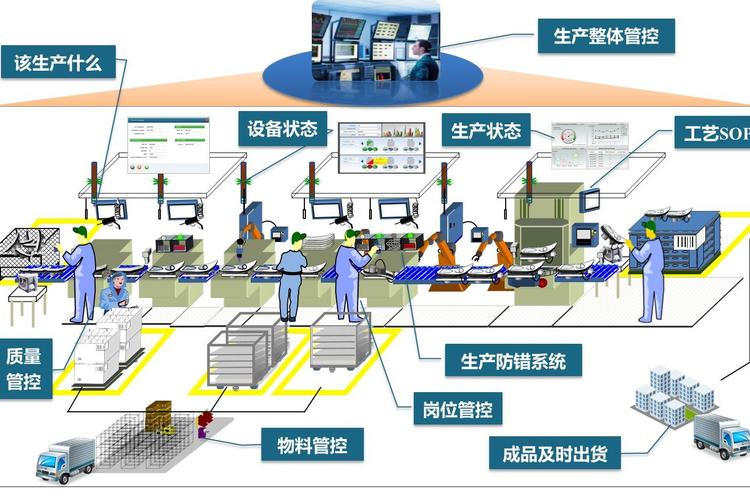 制造工厂工业数据孤岛场景示意图
问:普通联邦学习和工业联邦学习不是一回事吗?为啥非要单独加个“工业”前缀?
答:还真不是一回事。普通联邦学习大多是给互联网用户数据做的,处理的都是结构化的用户行为数据,不用考虑现场环境的坑。工业联邦学习要适配的东西多了去了——要处理带大量噪声的时序传感器数据,要兼容工业现场低带宽、高时延的网络环境,要适配不同品牌不同年代的异构设备,还要满足工业行业特殊的安全合规要求,这些都是普通联邦学习根本覆盖不到的。
工业联邦学习落地,这些坑没人提前告诉你
说实话,我接触过不下十个工业联邦学习的项目,一半以上折在了非技术问题上。
首先就是IT和OT的对立。IT部门想着搞数据搞AI升维,OT部门盯着生产不能停,你给边缘设备装个联邦学习节点,OT工程师怕占资源跑不稳生产,说什么都不让你动。
其次就是旧设备改造难。很多工厂里服役十年以上的老设备,连个开放的数字接口都没有,你连数据都采不上来,还谈什么联邦建模?
❗ 我见过一个项目,上来就铺全流程十个节点,花了大半年,最后因为一个老设备接口不对,整个项目卡了三个月,预算耗完了,不了了之。
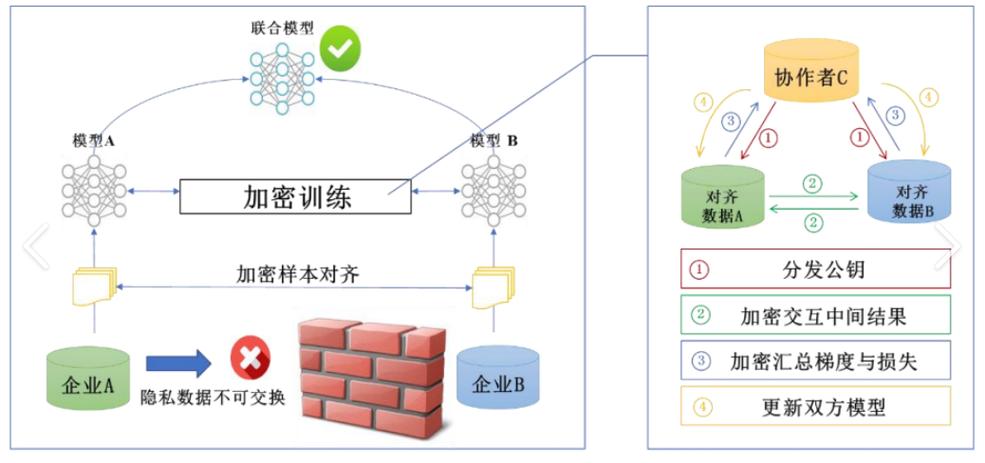 工业边缘端工业联邦学习节点部署图
问:我们就是个几十人的中小加工厂,能用得起工业联邦学习吗?会不会太贵?
答:真不贵。前两年可能只有大厂玩得起,现在不一样了,很多第三方方案商推出了轻量部署方案,按节点收费,一个节点一年几千块到几万块不等。现在不少行业协会都在牵头做中小工厂的工业联邦学习联盟,比如珠三角的注塑行业,十几家中小厂联合训练产品缺陷检测模型,每家的数据都留在自己厂里,模型效果每家都能用,成本摊下来每家一年才几万,比自己养个算法团队便宜十倍都不止。
已经跑通的工业联邦学习实用场景
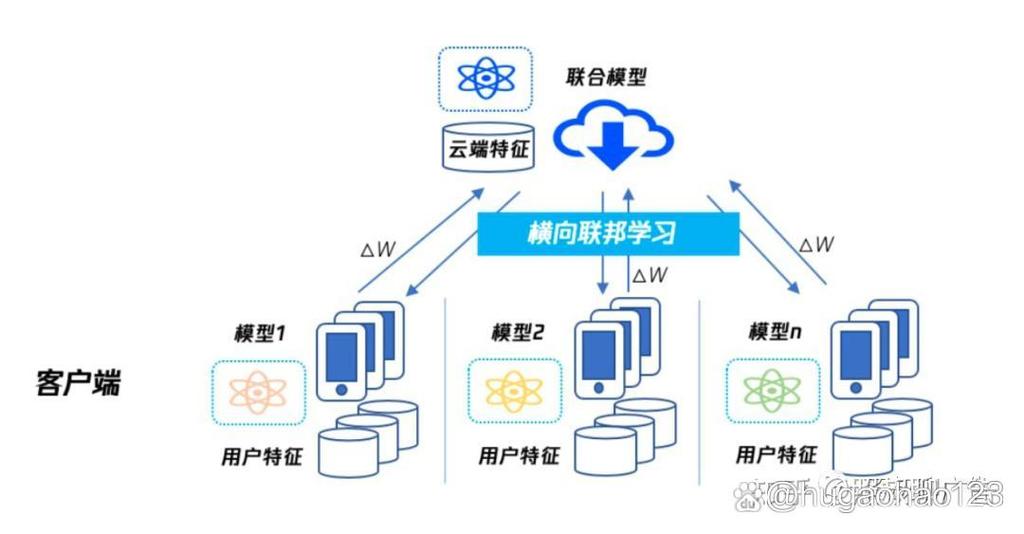 已经跑通的工业联邦学习实用场景
✅
跨厂区设备故障预测
头部工程机械厂商已经跑通,五个不同区域的生产基地,共享模型梯度不共享原始运行数据,联合训练出来的挖掘机故障预测模型,误报率从原来的16%降到3.8%,每年省下上亿的售后运维成本。
✅
跨企业产品缺陷检测
长三角几家异质结光伏电池厂商,联合训练硅片缺陷检测模型,每家的工艺参数都不流出,模型准确率比单厂训练提升12%,整体良率提升了1.7个点,这一个点就是几千万的利润。
✅
供应链联合质量溯源
汽车行业的供应链,一级二级供应商不用把自己的生产数据交给主机厂,通过工业联邦学习联合建模,就能快速追溯到问题零部件的生产环节,既满足了主机厂的质量要求,又保住了供应商自己的工艺机密。
说实话,工业走到今天,数据就是新的生产资料。但生产资料也有产权,不能说你要我就给。工业联邦学习最棒的一点,就是把数据的控制权还给了数据生产者,你要用我的数据建模可以,原始数据我死死攥在手里,你只能拿到迭代模型的参数,亏不了我,大家都能赚。
不少人说工业AI落地难,难在哪里?大半难在数据拿不到,不是真的没有数据,是不敢拿,不能拿。工业联邦学习就是捅破这层窗户纸的那根针。路已经出来了,就看谁先迈步了。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业联邦学习:破解制造企业数据孤岛的落地方向 https://www.dachanpin.com/a/tg/69479.html