为什么制造业现在突然把隐私计算工业摆上台面?
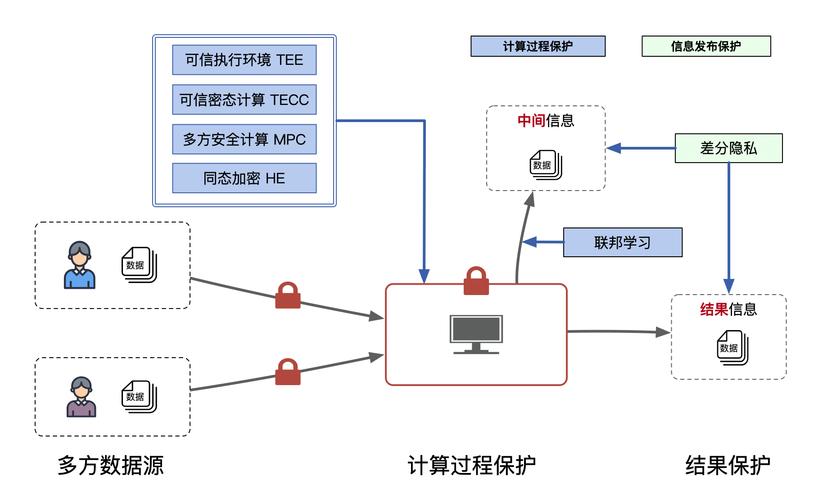
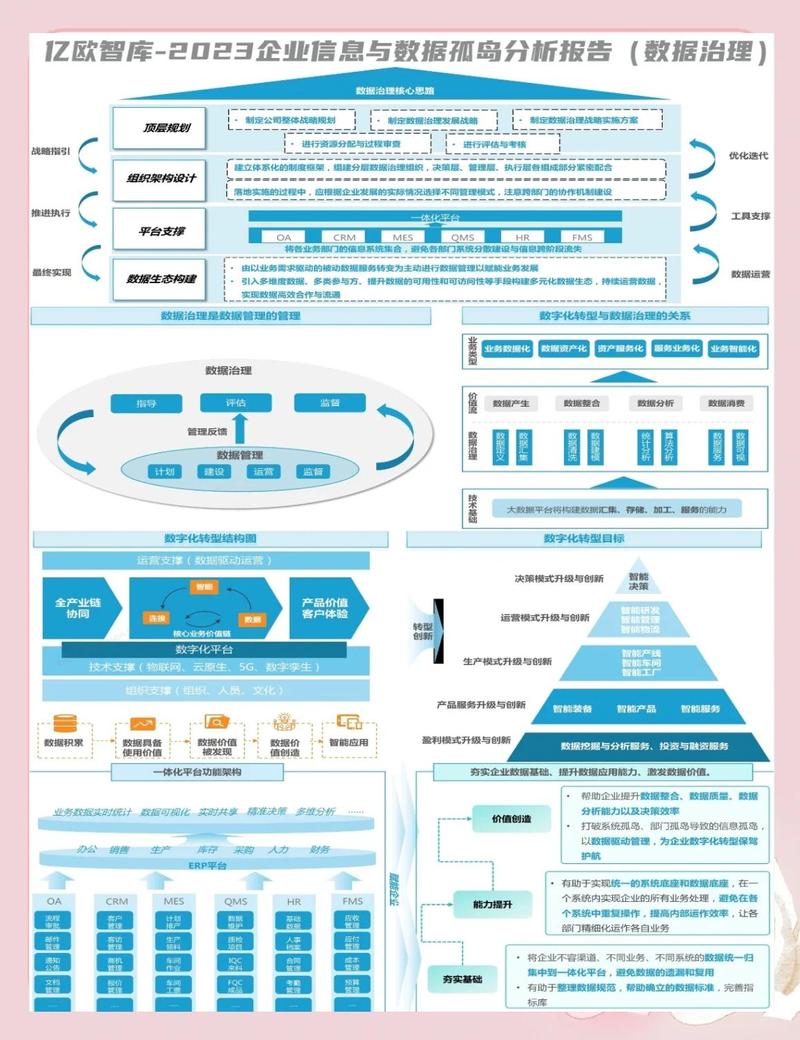
放在五年前,没人关心这个。那时候制造业数字化的核心是把自己厂的数据管起来,提质降本,都是关起门来自己干。 这两年不一样了。产业协同的需求起来了。新能源车企要训AI质检模型,需要上游电池厂、结构件厂、PCB厂的缺陷数据;化纤厂要优化原材料配方,需要下游织造厂、品牌商的市场反馈数据;哪怕是做五金冲压的小厂,要优化模具损耗,也需要上游钢厂的钢材成分数据做支撑。 数据是好东西,能赚更多钱,但是没人敢裸奔。 隐私计算工业就是为这个问题来的。核心就是数据不出域,可用不可见,你我都不用把原始数据交给对方,就能一起算、一起训模型,好处都拿得到,风险不存在。
隐私计算工业落地的坑,90%的进场玩家都踩过
我这两年见了不下二十个隐私计算工业的落地项目,成成败败,总结下来,坑其实就那几个。 ❗第一个坑:把互联网那套直接搬去工业。 互联网做隐私计算,算的大多是结构化的用户行为数据,接口统一,数据干净。工业数据是什么?百分之七十是非结构化的设备时序数据,还有不同品牌PLC采出来的乱七八糟的脏数据,协议都不统一,你把互联网的隐私计算框架直接搬过来,跑都跑不起来,更别说要适配工厂低延迟的生产要求了。 ❗第二个坑:上来就要搞全产业链大平台。 很多玩家一进场,喊的口号就是打通全行业数据,做万亿级平台。结果呢?各家工厂的网络环境不一样,有的老工厂连外网都不接,要部署隐私计算节点,光协调安全部门就协调了大半年,好不容易部署完,跑一次联合计算要三四个小时,没人愿意用,最后烂尾了。 💡现在真正跑通的项目,全都是从小切口切入的。先挑一个小需求,比如只做联合质检模型训练,只做供需需求预测,跑通了,赚到钱了,再慢慢扩范围,没人一上来就吃成胖子。
隐私计算工业接下来的爆发点在哪里
相关推荐
-
失效模式与影响分析(FMEA):当“可能出错”真的出了错,你扛得住吗?
车间里又炸了。 不是物理意义上的爆炸——是晨会上那帮人差点掀了桌子。生产经理拍着报告吼:“为什么这个失效模式上次FMEA里明明评估过,结果还是漏了?”质量工程师一脸无辜:“当时RPN值不高啊,谁知道它真会出问题……” 说实话,这场景我都见了不下十回。失效模式与影响分析(FMEA),这玩意儿名字听着高大上,可落到车间执行层面,往往变成了一份除了审核时翻一翻,平…
-
激光切割:老钣金工私藏的效率与省钱干货
干了快二十年钣金加工,见过太多离谱的事。几百万的激光切割机买回去,切出来的活精度差,挂渣多,还天天费耗材,一算成本比等离子切割还高。很多老板挠破头,觉得是机器买差了,其实都是小细节没注意。 为什么你家激光切割精度总是差0.1mm? 干这行的都知道,差个0.1mm,看起来不多,后续折弯组装的时候,就是装不上的大问题。很多人第一反应是调切割参数,换镜片,折腾大半…
-
锻造工艺:那些老师傅打死不说的门道
上周去了趟老工业区,本想着淘点二手模具钢,结果撞见个做了三十年锻压的老赵头,蹲在车间门口抽烟,眉头拧得——怎么说呢,像他手里那截烧红的棒料。 “赵师傅,愁啥呢?” “你瞅瞅这铝锻件,客户非要一模两穴,可模具寿命就是上不去。我改了三次冷却水道,还是裂。” 我凑过去看,飞边切得倒是利索,但模具表面那些热疲劳裂纹,哎。这种事儿吧,书本上从来不写。你翻遍《锻造工艺学…
-
RPA:重塑企业运营效率的智能助手
在数字化浪潮席卷各行各业的当下,企业对运营效率的追求从未停止。大量重复性、规则明确的工作依然占据员工大量时间,从财务报销单据审核到人力资源部门的员工信息录入,这些任务耗时费力却难以创造高附加值。此时,机器人流程自动化(RPA)技术应运而生,它如同一位不知疲倦的 “数字员工”,悄然改变着企业的工作模式,成为提升运营效率、降低成本的重要工具。 RPA 并非传统意…
-
智慧物流:重构货物流转的隐形脉络
智慧物流早已不是停留在概念中的名词,它像一张细密的神经网络,渗透在货物从工厂到消费者手中的每一个环节。从仓库里自动穿梭的 AGV 机器人,到运输途中实时跳动的温湿度数据,再到小区驿站精准推送的取件信息,技术正悄然改写着物流行业的运行逻辑。这些看似独立的智能节点,通过数据串联形成完整的协同体系,让货物流转效率实现质的飞跃。 在长三角地区的一座电商仓储中心,每天…