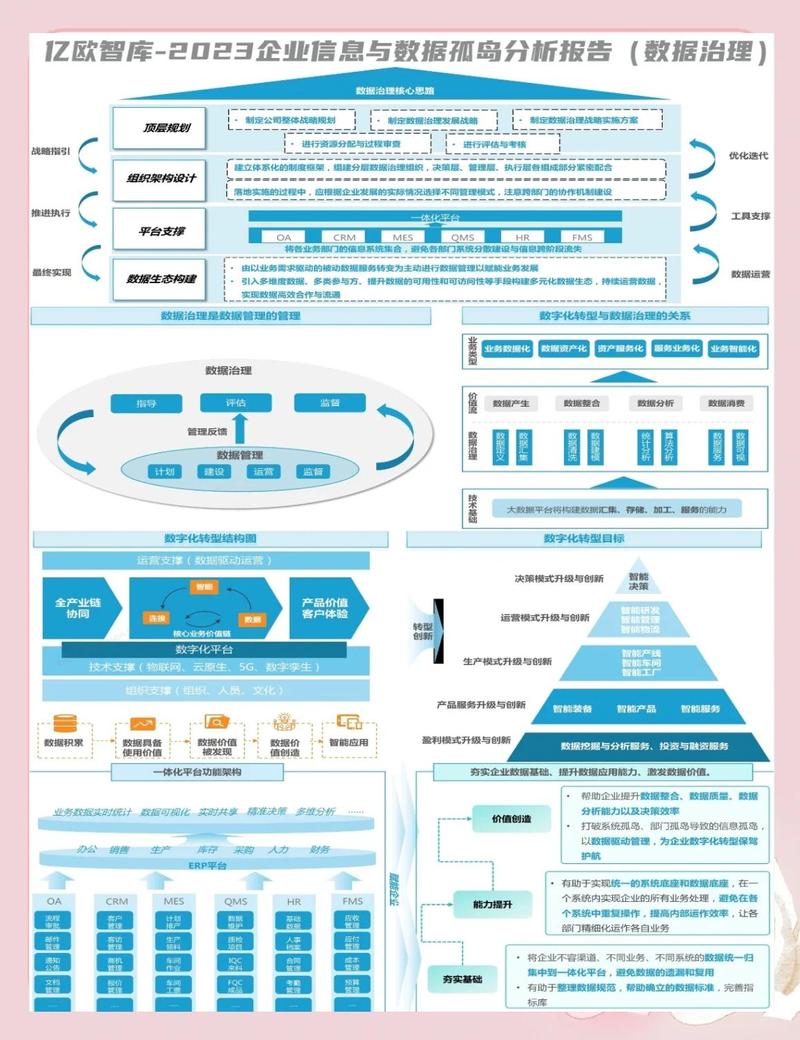
你去跑十家制造工厂问,九个都会跟你说,我们现在有数据,就是用不起来。供应链上下游你防我我防你,同个工厂不同车间的数据都锁在不同系统里,像一个个密闭的箱子。
做数字化这么多年,工业AI模型早就证明了自己的价值,不管是缺陷检测还是故障预测,只要数据量够、标注准,精度能比传统方法高好大一截。可问题就出在数据上。
长三角一家做动力电池顶盖的厂长跟我吐槽,他们三条生产线分属三个不同的事业部,各算各的KPI,数据标准都不统一,更别说把数据放一块训模型了。每条线自己训出来的缺陷检测模型,对罕见瑕疵的识别率不到70%,漏检率一直降不下去,换了好几批算法工程师都没用。
就算你愿意内部协调,把数据攒到一块,放到供应链场景里呢?整车厂要做供应链的质量管控,需要各个零部件厂商提供生产过程数据,哪家敢给?那都是人家攒了十几年的核心工艺,数据交出去,等于把家底都亮给你了。
问:那我搭个私有云,让大家把数据都放我这,签好保密协议还不行吗?
答:先不说保密协议能不能管住内部泄露,真出了安全事故,数据持有方谁都跑不了,现在合规要求这么严,没人敢冒这个险。就算合规过了,清洗、转换不同厂商不同格式的数据,成本够你上线半条新生产线了,怎么算都不划算。
不过话说回来,既然数据不能动,那能不能动模型?这就是工业联邦学习能火起来的原因。
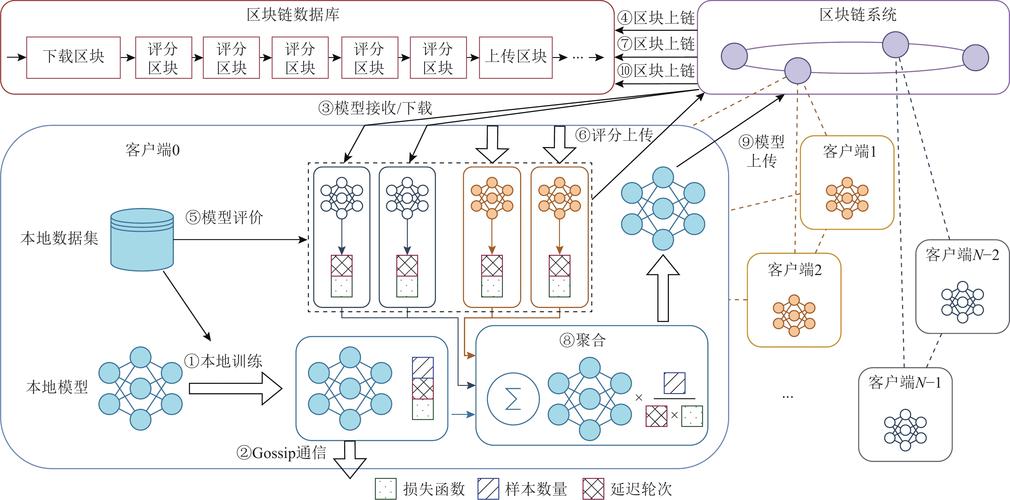
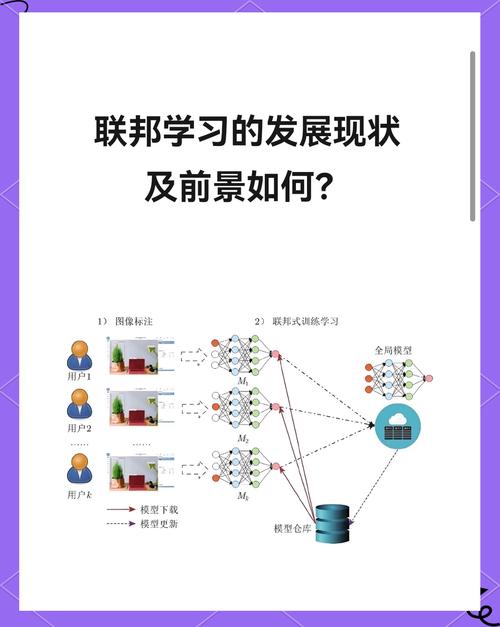
说白了,工业联邦学习走的就是完全不一样的路。它不是把数据聚到一块训模型,而是每个参与方把数据留在本地,只把训练出来的模型参数传出来聚合,最后得到一个大家都能用的共用模型,
,完美解决了数据隐私和合规的问题。
现在国内风电行业已经有成熟的2023-2024年落地案例了,好几家风电运营企业,不同区域的风场数据都留在自己场站内,用工业联邦学习联合训练风机齿轮箱故障预测模型,最终模型的预测准确率比单个风场训练的提升了23%,提前预警的时间也从原来的2天拉长到7天,光每年的维护成本就能降十几个点。
国内不少头部汽车供应链也在试点,整车厂和一级供应商联合训零部件缺陷检测模型,供应商数据不用出域,整车厂拿到了更高精度的模型,双方都划算,没人吃亏。
问:很多人说工业联邦学习就是把普通联邦学习换了个工业的名字,本质上就是炒概念,是这样吗?
答:还真冤枉了正经做工业联邦的团队。普通联邦学习一开始是给互联网用户画像做的,数据规整、云端算力也管够,工业数据哪是这样?
工业数据高噪声、样本不平衡,还动不动就因为设备断网缺数据,再加上很多现场的老设备算力极低,根本跑不动大参数更新。所以现在成熟的工业联邦学习方案,都做了针对性优化:轻量型参数剪枝、梯度压缩适配低算力低带宽,还有专门针对不规则工业数据的鲁棒性优化,根本不是换皮的概念。说实话,真拿普通联邦学习往工业场景套,十个有九个跑不起来。
我见过不少企业,上来就把工业联邦学习吹得神乎其神,砸大几千万搞全集团全链路项目,最后烂尾收场,真的可惜!
❗ 第一个坑:不要上来就搞大而全。
我见过落地最快的项目,都是从一个具体的小痛点切入,比如先拿两三个同类型的生产线,或者供应链上两三个合作伙伴,先跑缺陷检测或者故障预测这个单一场景,三个月出效果,拿到收益再慢慢扩,稳得很。上来就想打通全集团所有数据,大概率死在半路上。
💡 第二个坑:不要想着替换现有系统。
很多工厂已经有了现成的工控系统和AI平台,没必要全换掉。现在成熟的工业联邦学习都是插件化部署,直接嵌到现有系统里就能用,改造成本极低,千万别推倒重来,那钱烧得,水漂都不响。
❗ 第三个坑:一定要提前算通信开销。
工业现场内网带宽大多不高,很多人忽略了这个,每次聚合参数传个几个G,直接把内网卡崩,影响正常生产。选方案的时候一定要问清楚,有没有做梯度压缩和稀疏化,能不能适配现场的带宽条件,别等上线了才出问题。
现在制造业数字化搞了这么多年,很多工厂都攒了一堆数据,就是锁在各个孤岛上变不成收益。工业联邦学习不是什么天上掉下来的黑科技,就是给这些沉睡的数据找了个合法能用的出路。
不信,你找个小场景试试。
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工业联邦学习:制造业数据孤岛破局的实用方案 https://www.dachanpin.com/a/tg/70242.html