为什么工业制造必须做云边协同架构,不是纯云也不是纯本地
纯云架构走公网传输,工业现场对时延要求是毫秒级的,你冲压机的温度超标了,等云端处理完指令发下来,十多个废件已经压出来了。 纯本地架构呢?中小厂要自己搭服务器集群,自己存好几年的生产数据,自己养团队做数据分析,算下来一年几十万的成本,大半工厂扛不住。 就算是大厂,全本地存所有现场数据,存储成本三年就能翻一倍,太烧钱了。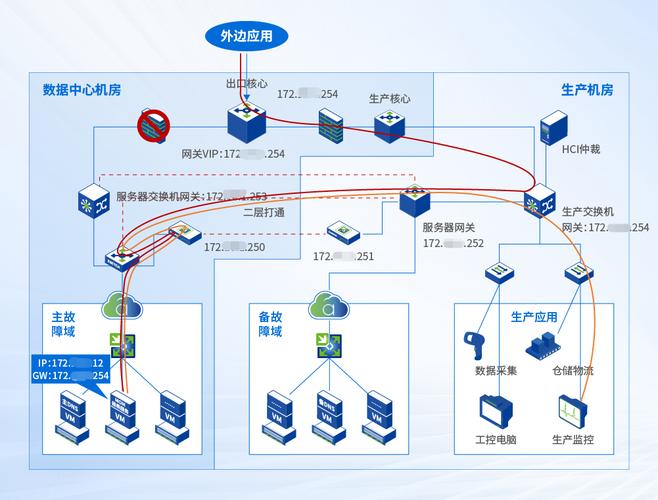
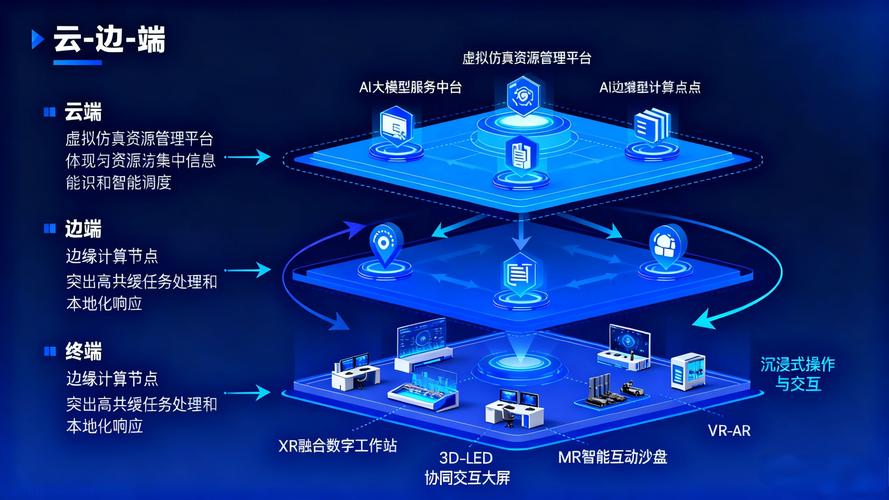
工业云边协同架构的核心落地逻辑:谁该在边,谁该在云
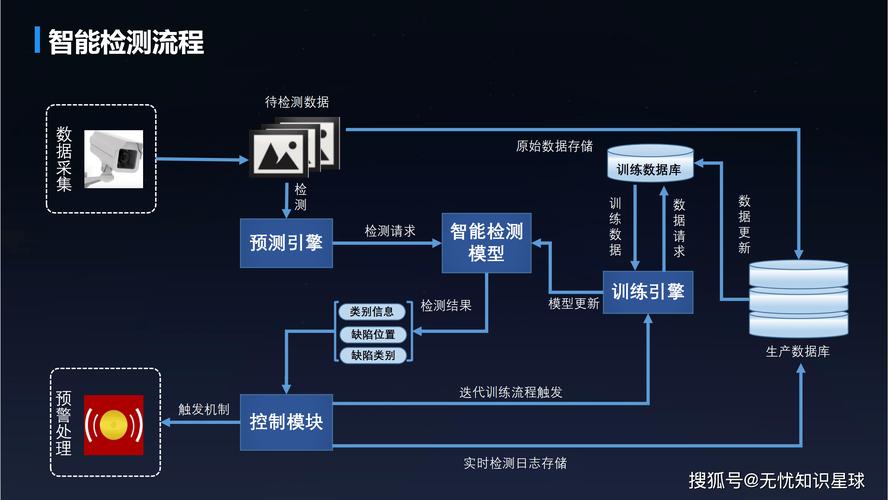
说实话,我见过好多项目做砸了,核心原因就是没搞清楚分工。上来就把所有数据都往云上发,结果带宽被占满,时延还是降不下去,完全浪费了云边协同的优势。 💡 边缘侧必须扛住这三件事: 1. 实时数据预处理:设备振动、温度这些一秒钟采十几次的高频数据,边缘先筛掉正常范围的平稳数据,只把异常数据和关键特征往云上传,至少能省80%的带宽成本 2. 本地实时控制:报警触发、急停联动、工艺参数实时调整,这些绝对不能走云端,毫秒级时延要求,边缘本地处理才靠谱 3. 断网续传:工业现场偶尔断网太正常了,边缘先把数据存在本地存储里,网络恢复之后再同步到云端,不会丢一个点的生产数据 ✅ 云端只需要做这些事: 1. 全工厂多设备数据聚合分析,比如整厂OEE计算、月度能耗统计这些非实时的分析工作 2. 机器学习模型训练,比如预测性维护的故障模型,要用全工厂几年的数据训练,训练完再把轻量化的推理模型下发到边缘节点运行 3. 上层业务协同,对接工厂的ERP、CRM系统,做全链路的排产和供应链调度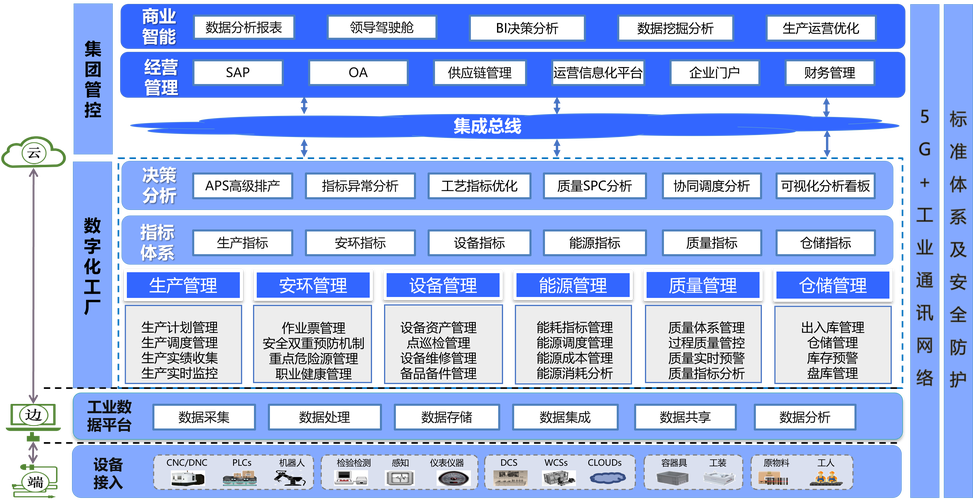
工业落地云边协同架构踩过的三个坑,别再往里跳
相关推荐
-
指尖上的隐形工匠:RPA 如何编织现代生活的温柔纹理
晨光透过写字楼的玻璃幕墙,在财务总监陈薇的办公桌上投下细碎光斑。她端起温热的咖啡,目光掠过电脑屏幕时忽然笑了 —— 往日需要耗费整个上午核对的报销单据,此刻正由一个看不见的 “助手” 自动校验、分类,屏幕上跳动的进度条像一条安静流淌的河,将琐碎的数字转化为规整的表格。这个被称为 RPA 的工具,正以一种近乎诗意的方式,悄悄改写着人们与工作、生活相处的节奏。 …
-
计算机辅助设计(CAD):一个老工程师的执念与现实
CAD?不就是电脑画图吗。 每次听到这个论调,我都有点想摔鼠标。真不是矫情——当你为一根复杂的曲轴做参数化关联,因为一个尺寸标注失误,整个装配体一夜之间“雪花屏”的时候,你就会明白,这玩意儿早就不只是电子图板了。它是一套严谨的、带着血泪教训的思维逻辑。 入行快二十年,说实话,我见过太多人把SolidWorks当成微软画图来用。特征树从来不看,尺寸全靠手敲,改…
-
解锁城市出行新方式:共享出行的现状与未来探索
当你站在繁忙的路口,想要快速抵达目的地却又不想花费高额打车费用,也不愿在拥挤的公交里耗费过多时间时,拿出手机轻轻一点,附近的共享单车或共享汽车便会出现在地图上 —— 这便是当下城市生活中极为常见的共享出行场景。共享出行并非新兴概念,但其在技术发展与消费需求变化的推动下,已从最初简单的单车共享,演变为涵盖单车、汽车、电单车、拼车等多种形式的综合出行体系,深刻改…
-
冲压工艺:搞了十几年,还是被毛刺和回弹搞到破防
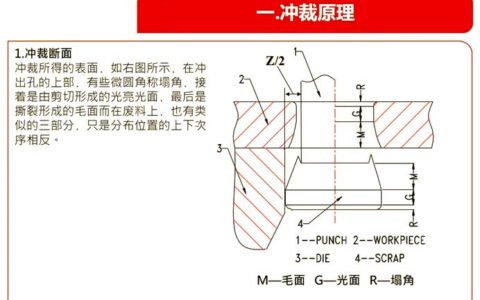
上周三晚上十一点,车间电话把我从床上拎起来——新开的连续模,打出来的零件毛刺大得像锯条齿,修边工序直接崩了口。我套上工服就往厂里赶,一路上心里把那套模具的设计师问候了八百遍。说实话,冲压这行干久了,什么妖蛾子都见过,但每次都还是能让你血压飙升。 冲压工艺,听着粗犷,其实比绣花还挑细节。一台压力机,几十吨的力往下一砸,钢板变成零件,看起来简单粗暴,对吧?可一旦…
-
锻造工艺:为什么高端制造业都绕不开它
很多人对锻造的印象,还停留在村口铁匠抡大锤打铁。早就翻篇了。 为什么现代锻造工艺比你想的更重要 说白了,锻造就是靠外力让金属坯料塑性变形,得到我们想要的形状和性能。很多刚入行的机械工程师,总想着能省则省,用铸造代替锻造,最后出了问题追悔莫及。 铸造是把熔化的金属倒进模具冷却成型,内部天生容易带气孔、疏松,晶粒也粗,抗疲劳性能差远了。锻造不一样,塑性变形会把内…