为什么工业产线现在必须玩流式数据处理?
早年制造业数字化程度低,传感器采样频率低,攒上一两个小时的数据批量分析,完全够用。那时候没人提实时,反正出问题也不会一下子亏太多。 现在不一样了。新能源电池的涂布工序,振动采样要做到毫秒级;风电整机的叶片健康监测,一秒钟好几个G的振动数据往里打;汽车冲压线的模具磨损监测,差个几百毫秒都可能出大问题。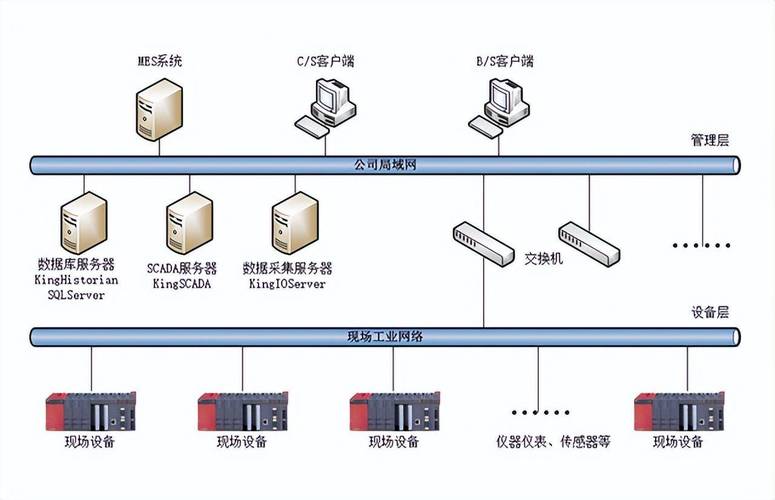
工业流式数据处理落地最容易踩的坑
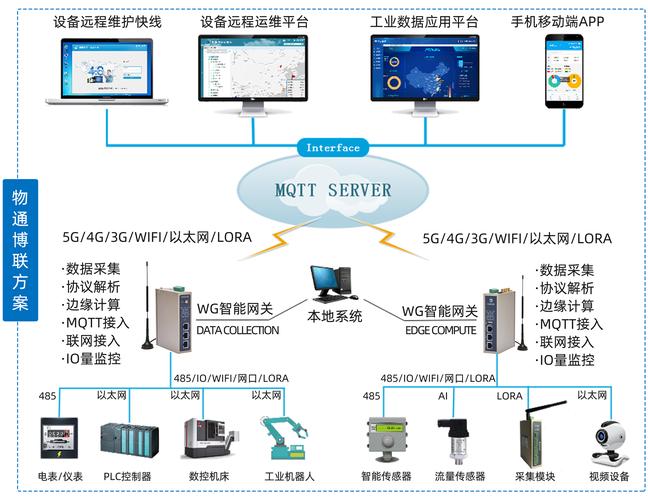
我接触过不下二十个工厂的数字化项目,一半以上都在流式这块翻过车。这里放两个大家问得最多的问题: 问:我们工厂已经上了企业级大数据平台,还要单独搭流式数据处理模块吗? 答:绝大多数情况都要。很多通用大数据平台的流式组件,都是给互联网点击流、交易流做的,对工业场景的适配几乎没有。工业现场动不动就边缘网络抖动,传感器丢包重连,很容易出现数据乱序,通用流式框架处理不好乱序,你的异常预警就会错报、漏报,反而比不用还添乱。 问:流式数据处理是不是所有数据都要实时处理?硬件成本会不会高到离谱? 答:当然不是。说实话,90%的产线数据都是平稳的正常数据,根本没必要全量实时存全量算。我们去年给一家汽车底盘零部件厂做方案,就是用了分层流式处理:传感器数据过来,边缘侧先做门槛判断,超过正常阈值的异常片段,才用流式处理实时分析发往后端,正常数据只需要每分钟汇总一个均值就行。改完之后,存储成本直接降了87%,核心异常预警的延迟还控制在100毫秒以内,一举两得。 💡第一个坑:贪大求全,上来就要处理全产线所有数据,结果算力拉满,服务器成本涨了几十倍,最后算下来投入产出比根本看不了。 第二个坑:全放云端跑计算,不做边缘侧分流。工厂车间的网络你懂的,时不时晃一下,数据传云端延迟一下,你的实时预警就成了马后炮。现在最新的落地实践都是云边协同流式数据处理,边缘侧做第一层过滤和轻计算,只把有用的信息往上发,稳得多。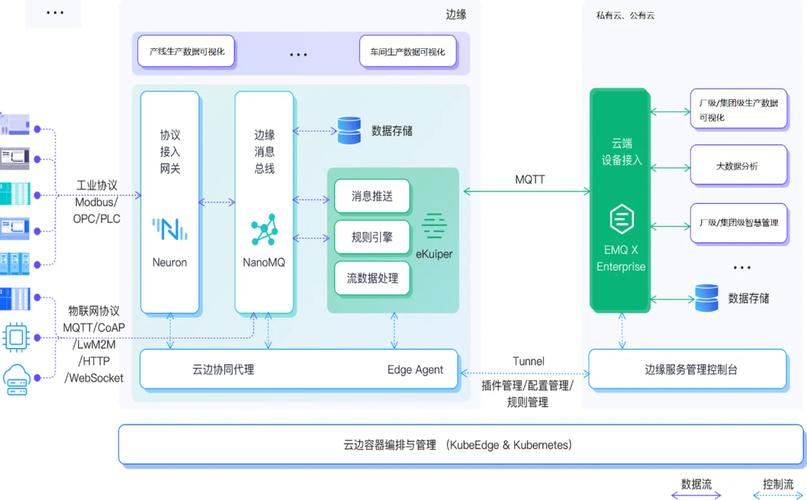
给中小制造企业的流式数据处理入门建议
免责声明:文章内容来自互联网,本站仅作为分享,不对其真实性负责,如有侵权等情况,请与本站联系删除。
转载请注明出处:工厂产线流式数据处理:解决毫秒级异常预警的落地方坑 https://www.dachanpin.com/a/tg/70990.html